暑假后
other-other暑假后新项目和之前项目的推进
full-length HERV transcripts
Systematic characterization of the disease-relevant regulation of putatively full-length HERV transcripts in Alzheimer’s cortex
- 收集尽可能多的数据(AD的单细胞数据,不同脑区,有没有配套SNP的)
- 定义“全长转录本”和“嵌合转录本”(“它为什么表达变化、它和gene是什么关系”)
- 嵌合转录本:HERV被纳入宿主基因转录本中,作为alternative promoter、new exon、internal exon、3’UTR或terminator
- putatively full-length:不用特别标准的拼接方法,稍微简单一点,去掉只在其中一端有reads的,要求在LTR/exon都有reads(和嵌合区分,嵌合可能是只剪接了其中一段)
- (regional表观驱动型:所在区域在AD中变得更开放(通过表观遗传标记识别),导致HERV表达上升)
- (复杂调控型:同时受到邻近gene转录读穿、局部开放、TF结合、遗传变异、细胞状态变化等多因素影响)
- 选出值得研究的转录本
- AD-NC差异表达的HERV
- 不同细胞类型中特异变化的HERV(以及HERV表达是否有细胞类型特异性),参考2024 NC–Single-cell eQTL mapping of human endogenous retroviruses reveals cell type-specific genetic regulation in autoimmune diseases / stellarscope原文:A single-cell transposable element atlas of human cell identity
- 共表达网络+GO看功能,参考2024 NC–Integrating human endogenous retroviruses into transcriptome-wide association studies highlights novel risk factors for major psychiatric conditions
- 前述分类中各类别是否有功能偏好?比如嵌合转录本型更容易和邻近基因表达有关、表观驱动型更多受炎症、抗病毒等细胞通路激活影响、复杂调控型更能体现细胞状态?
- 挖掘上游调控因素
-
TF层面:看这些HERV/LTR附近是否富集某些TF motif,比如炎症相关TF、干扰素相关TF、神经元/胶质细胞特异TF;再结合TF自身表达或TF活性,解释为什么某类HERV在某些细胞类型里被激活
参考Single-nucleus chromatin accessibility and transcriptomic characterization of Alzheimer’s disease
-
(如果有SNP数据)SNP层面:看是否有遗传变异调控HERV表达,即HERV-eQTL;再看这些SNP是否也和AD风险相关
-
- 与AD疾病作相关:
- (可以先算一下)如果找不到有基因型的数据,可以用别人做好的HERV-QTL+cortex AD GWAS summary做SMR:SNP → HERV表达 → AD风险,参考2024 NC–Single-cell eQTL mapping of human endogenous retroviruses reveals cell type-specific genetic regulation in autoimmune diseases
- HERV~SNP的QTL:某个SNP是否调控某个HERV表达
- AD~SNP的GWAS summary:某个SNP是否影响AD风险
- 用自己的HERV~gene关系+公开gene eQTL,间接推断AD状态下HERV~SNP关系
- 自己的表达矩阵:
HERV表达≈β₁×gene表达 - 公开cortex gene eQTL:
gene表达≈β₂×SNP - 上述两个结合:
SNP对HERV的间接影响≈β₂×β₁
优点是可以利用自己在AD cortex中得到的HERV-gene关系,所以更贴近AD状态;缺点是HERV~gene相关性不一定代表gene调控HERV,也可能是共同受细胞状态、表观调控等的影响
- 自己的表达矩阵:
-
把两条证据合并:直接遗传证据
公开HERV-eQTL+AD GWAS→SMR+间接遗传证据自己的HERV-gene关系+公开gene eQTL→推断HERV调控SNP如果某个HERV同时
在AD中差异表达(或者还有细胞类型特异性)+判明转录本类别(邻近gene也和AD机制有关)+有共表达功能解释+有HERV-eQTL/SMR或推断SNP支持,那么它就可以作为更高可信的AD疾病相关HERV候选
- (可以先算一下)如果找不到有基因型的数据,可以用别人做好的HERV-QTL+cortex AD GWAS summary做SMR:SNP → HERV表达 → AD风险,参考2024 NC–Single-cell eQTL mapping of human endogenous retroviruses reveals cell type-specific genetic regulation in autoimmune diseases
简单总结暑假的工作:
- 在GSE157827、GSE174367中发现明确的细胞型和位点特异性HERV变化,MG偏免疫/抗病毒,神经元偏突触功能,ODC/ASC偏膜与支持功能
- 共得到约1379个HERV-基因剪接连接,但AD-NC差异没有通过BH校正;当前短读长也不能可靠判断HERV方向、真实TSS、完整内含子链和“新外显子”
- snATAC只在±10kb范围出现部分方向一致结果,直接重叠和±2kb证据很弱,且没有全局富集,因此不能把“附近开放”直接解释为HERV上调原因
- SV分析主要被39.8Mb大范围重复事件驱动,说明通用短读长SV与HERV简单求交的收益已经较低
一些思路:
- snRNA-seq作为基础数据,确定HERV位点在哪些细胞类型中改变
- bulk RNA-seq去确认HERV转录本结构,同时进行供体级表达验证;小样本长读长数据确认LTR—internal—宿主外显子是否由同一RNA分子连接
- snATAC-seq:判断HERV/LTR附近是否出现AD相关开放变化
- HERV-eQTL、AD GWAS:补充遗传支持
数据
GPT首推,比较大的数据集,但基本都需要申请使用:
AD单核短读长+PacBio Kinnex长读长(Paired 10X 3’ single-nucleus RNA sequencing with PacBio Kinnex long-read sequencing in 7 control and 8 Alzheimer’s disease human frontal cortex samples),来自RNA isoform diversity, splicing variants and switching in single cells of the Alzheimer’s disease brain- European Genome-Phenome Archive这个网站无法注册,提示“The domain “xxx” is not allowed”,试了qq/163/gmail/proton都不行
- SEA-AD:非常全面,snRNA/snATAC/Multiome+WGS/SNP,似乎可以申请
- raw 10x snRNASeq, snATACseq, and Multiome data generated by the SEA-AD study
- single cell genomics datasets and associated representations of disease pathology across the AD/ADRD community through uniform re-processing, data harmonization and mapping to highly annotated BRAIN Initiative Cell Atlas Network (BICAN)/SEA-AD cell classifications
- processed data (including cell type assignments) for snRNAseq data from eleven brain regions
-
PsychAD(syn52160016):约630万细胞核、1494名供体
dorsolateral prefrontal cortext (DLPFC),1,494 samples (donors) from 3 brain banks, i.e. Mount Sinai NIH Brain Bank and Tissue Repository (MSBB; 1,042 samples), NIMH Human Brain Collection Core (HBCC; 300 samples), Rush Alzheimer’s Disease Center (ROSMAP; 152 samples). Importantly, over 60% of the PsychAD cohort, had previously participated in MSBB AMP-AD, CommonMind and/or ROSMAP studies, which had already generated a wealth of omics data, including SNP-array, whole-genome sequencing (WGS), RNA sequencing (RNA-seq), assay for transposase-accessible chromatin (ATAC-seq), chromatin immunoprecipitation sequencing for histone 3 lysine 27 acetylation (ChIP-seq H3K27ac) and for histone 3 lysine 4 trimethylation (ChIP-seq H3K4me3) for these individuals
- 同前,需要申请
- ROSMAP多脑区snRNA+snATAC(syn52293442):来自6个脑区、48名个体的130万细胞样本,涉及6个不同阶段的阿尔茨海默病发病过程
- 不过似乎只看到了bam文件和表达矩阵,没看到fastq?
- 同前,需要申请
Banner SFG snRNA+WGS(syn51753326):来自Single cell transcriptomes and multiscale networks from persons with and without Alzheimer’s disease,66例AD、35例对照,481840个细胞核,平均PMI约3.4h- 该项目中的fastq文件夹中只有一个fastq.gz文件,且无下载权限,也无申请下载选项
SEA-AD申请可获得的数据:
| 数据 | 脑区与供体覆盖 | 访问状态 | 对你的作用 |
|---|---|---|---|
| snRNA-seq原始FASTQ | MTG(颞叶皮层),设计覆盖84位供体,约110万个核 | 申请 | 重新比对并进行位点级HERV定量 |
| snATAC-seq原始FASTQ | MTG,设计覆盖84位供体,约58万个核 | 申请 | 重新识别HERV/LTR附近开放区域 |
| snMultiome原始FASTQ | MTG,同核snRNA-seq和snATAC-seq,28位供体,约15万个核 | 申请 | 同一个细胞核内联系HERV表达和LTR开放性 |
| A9 snRNA-seq原始FASTQ | A9(前额叶皮层),同一批84位供体,约120万个核 | 申请 | 作为前额叶独立脑区复现 |
| 处理后snRNA/snMultiome矩阵 | MTG、A9 | 公开AWS/h5ad | 普通基因和已有细胞注释可直接使用,但标准gene矩阵通常不能重新发现HERV |
| 处理后snATAC peak矩阵 | 主要为MTG | 公开AWS | 候选HERV与既有开放峰重叠;不等于重新做HERV定向ATAC分析 |
| MERFISH空间转录组 | MTG,27位供体、69张切片、140基因panel | 公开 | 验证细胞层次和空间病理关系;panel中基本不能系统测HERV |
| 定量神经病理 | 84位供体 | 公开 | 包括Aβ、pTau、GFAP、IBA1、NeuN、α-synuclein、pTDP43等染色及定量 |
| 供体和临床元数据 | 84位供体 | 公开 | 年龄、性别、APOE、ADNC、Braak、Thal、CERAD、认知、共病、PMI、RIN等 |
注意:基因型和WGS数据不在SEA-AD中,而是在NG00174中单独存储
| 数据类型 | 样本数 | 生成方式 | 提供文件 |
|---|---|---|---|
| WGS | 84 | American Genome Center使用Illumina NovaSeq测序,GCAD处理 | CRAM、单样本gVCF、预览版联合分型pVCF |
| SNP芯片 | 80 | CHOP使用Illumina Infinium Global Screening Array | GRCh38上的PLINK二进制文件 |
- 该数据似乎不能是学生申请,只能是PI?NIAGADS Data Downloader说明
不用申请的数据:
- GSE237718/SRR run:56位供体(29AD+27对照),颞叶皮层,10x snRNA-seq,有APOE基因型和性别,原论文研究APOE对病理变化的影响
- GSE263468/SRR run:46位供体(18个Braak 0-II、10个Braak III-IV、18个Braak V-VI)。前额叶BA9、楔前叶BA7、初级视觉皮层BA17,有APOE基因型和疾病分期(似乎没年龄性别),原论文主要研究其中的神经元的分子特征
- GSE268599/SRR run:32位供体(覆盖正常衰老至重度AD),内嗅皮层、下颞回、DLPFC、视觉联合皮层、初级视觉皮层,有年龄性别基本分期,原论文主要研究其中的星形胶质细胞的病理变化
- 如果拿不到SEA-AD的数据,可以以毕设的两套前额叶数据为基础,其它脑区作补充验证
- 汇总:
- snRNA:约30例AD+24例对照(GSE157827、GSE174367和GSE214979)
- 连续病理snRNA:前额叶BA9,42位供体(GSE263468)
- bulk RNA:191份(GSE174367)
- snATAC:约19例AD+16例对照(GSE174367和GSE214979,后者是同样本ATAC+RNA,前者不同样本)
- 长读长:AD-对照数据12份(SRP456327)
- 颞叶独立复现:29AD+27对照(GSE237718)
- 星形胶质细胞多脑区扩展:32位供体、146份区域样本(GSE268599)
思路
共同的核心科学问题:
- 哪些HERV位点在AD中发生可重复的表达变化?这些变化发生在哪些细胞类型和细胞状态?
- 候选属于独立HERV转录、推定全长转录,还是基因—HERV嵌合转录?
- 候选HERV/LTR是否同时出现染色质开放和TF调控证据?
- 候选是否与干扰素、TLR7/8、补体、APOE-TREM2、脂质代谢和神经元应激等通路相关?
- 候选是多个皮层区域共有,还是具有脑区和病理阶段特异性?
- 是否存在HERV-QTL、AD GWAS或空间病理证据进一步提高可信度?
主要流程:
- 细胞类型/AD特异HERV表达:加上bulk RNA数据后可尝试pseudobulk
- 推定全长和嵌合转录本分类:结合长读长数据,将候选分成四类
- putatively full-length:具有两侧LTR的HERV位点在5′LTR、internal和3′LTR均有同链RNA覆盖
- HERV—gene chimeric:split reads或长读长分子连接HERV与宿主外显子,可进一步分为alternative promoter、new exon、internal exon、3′UTR和terminator
- LTR-only/regulatory:只有LTR表达或开放性证据
- uncertain:只有一端覆盖、多重比对无法区分或支持reads不足
- 染色质开放和TF调控:
- 对每个候选检查
- HERV/LTR是否与AD相关差异开放区重叠
- 5′LTR附近开放性是否与HERV表达方向一致
- 附近是否富集NF-κB、IRF、STAT、AP-1、SPI1、C/EBP等motif
- 候选TF自身表达或活性是否随疾病改变
- HERV附近基因是否出现一致的表达或可及性变化
- 最后分为:嵌合/读穿驱动型、局部表观开放驱动型、TF或细胞状态相关型、多因素复杂调控型
- 对每个候选检查
- HERV—gene共表达或模块分析+GO/GSEA:hERV是否与相关通路有关,还可以比较候选HERV在疾病相关小胶质细胞、反应性星形胶质细胞、易损神经元状态中的变化
- 跨队列和跨脑区复现:每个队列、脑区分别估计HERV疾病效应
如果可以申请到SEA-AD数据:
- 把MTG作为主分析脑区(RNA、ATAC、Multiome和定量病理最完整)
- A9作为前额叶复现脑区,并与GSE157827、GSE174367衔接
关于eQTL+GWAS的遗传分析:理想情况下是这样的
| 关系 | 输入数据 | 回答的问题 |
|---|---|---|
| HERV–AD | HERV-eQTL+AD GWAS | 遗传预测的HERV表达是否与AD风险共享信号 |
| HERV–gene | HERV-eQTL+gene-eQTL,辅以自己的HERV–gene共表达 | 同一遗传位点是否同时影响HERV和附近基因 |
| gene–AD | gene-eQTL+AD GWAS | 附近基因表达是否与AD风险共享信号 |
-
如果可以申请到基因型数据:
SEA-AD的HERV表达+NG00174基因型 ↓ 脑皮层HERV-eQTL ↓ HERV-eQTL+外部AD GWAS+匹配人群的LD参考 ↓ SMR+HEIDI+共定位- 看hERV(的某些位点的变异)是否会导致AD
-
如果申请不到基因型数据:
- HERV-QTL:原定使用Single-cell eQTL mapping of human endogenous retroviruses reveals cell type-specific genetic regulation in autoimmune diseases,但这块的供体都是健康人,更多反映基础遗传调控,没有AD特异性;组织是血细胞不是脑皮层;作者在处理数据时删除了与基因外显子重叠的HERV
- 同时GPT说作者论文中给的补充数据不全?如果只有补充表的话只能做到“比较2888个eSNP的AD GWAS P值是否相对于匹配的非eSNP更富集”(HERV调控变异整体是否富集AD遗传信号)这种,所以说这里还是存在一些问题
- AD GWAS:可使用GCST90027158
- GPT似乎不太认可之前提出的“自己的表达矩阵
HERV表达≈β₁×gene表达+公开cortex gene eQTLgene表达≈β₂×SNP→SNP对HERV的间接影响≈β₂×β₁”这种思路- β₁来自观察性HERV–gene相关,可能由细胞状态或共同上游因素造成
- 两个beta可能来自不同组织、队列和表达尺度
- 不确定性不能靠简单相乘解决
- 方向可能是HERV影响gene,也可能是gene读穿HERV
- HERV-QTL:原定使用Single-cell eQTL mapping of human endogenous retroviruses reveals cell type-specific genetic regulation in autoimmune diseases,但这块的供体都是健康人,更多反映基础遗传调控,没有AD特异性;组织是血细胞不是脑皮层;作者在处理数据时删除了与基因外显子重叠的HERV
首先需要解决的基础问题:hERV的注释、hERV表达量的定量/标准化方法
补充研究思路:
- 关于差异分析:在异质性条件下找特定情况——比如最简单的-找hERV富集的亚群来看hERV的变化,或者将hERV高的细胞和低的细胞比有哪些特异/有哪些marker,用鉴定出来的marker分细胞亚型看hERV / 用AD相关通路marker先定义细胞亚群看hERV
- 如果结果和别的研究不一样(像我的毕设中hERVK的那样),可以在多个数据集上验证以证明我的结果是正确的
- 关于全长/非全长转录本结构:找长读长看转录本结构再贴到短读长上
- 位点表达稀疏怎样让丰度提高:已知转录本富集新测序数据信号
- hERV受调控:基因读穿/开放性/TF,最后是做一个定量(表达预测模型)还是定性(在哪些情况下受什么影响大)
- hERV的TF调控:转录因子本身的改变+hERV有没有结合位点
- GO完成后看结果对不对:查文献有无记载、独立数据、实验验证
- 以后是否可以涉及DNA/RNA模型
final 计划
GPT5.6Sol最高 v0 → GPT6astro高 v1 → GPT6astro高 v2 → 最终版修改如下:
Systematic characterization of disease-relevant transcription, transcript structures and regulatory mechanisms of human endogenous retroviruses in Alzheimer’s cortex
| 数据集 | 样本量 | 脑区 | 建库方法/详细信息 | 用途 |
|---|---|---|---|---|
| GSE157827 | snRNA:12AD+9NC | 前额叶皮层PFC | 10x 3′v3 | 差异表达 |
| GSE174367 | snRNA:11AD+7NC snATAC:12AD+8NC 191份bulk RNA |
主要为前额叶皮层PFC,bulk包含多个脑区 | snRNA:10x 3′v3 snATAC:10x ATAC v1 bulk:SMARTer Stranded Total RNA |
snRNA差异表达 snATAC染色质开放+TF调控 bulk转录结构验证+差异表达验证 |
| GSE214979 | 同核snRNA-seq和snATAC-seq:7AD+8control | DLPFC | 10x Genomics Chromium Next GEM Single Cell Multiome ATAC+Gene Expression | snRNA差异表达 snATAC染色质开放+TF调控 |
| GSE183068 | snRNA:15AD+8control | 额叶皮层 | 10x 3′v3 | snRNA差异表达 |
| GSE310554 | snRNA:9AD+9control | 前额叶皮层 | 10x 3′v3.1 | snRNA差异表达 |
| GSE303823 | snRNA:4AD+4control | 前额叶、中额回,包含灰质及白质 | 10x 3′v3.1 | 候补(snRNA差异表达/同脑区独立验证) |
下载时发现无原始fastq |
snRNA-seq:8sporadic AD+8control+8PSEN1-E280A | frontal cortex | 10x 3′v3.1 | 候补(snRNA差异表达/同脑区独立验证) |
| GSE263468 | snRNA-seq:BA9共42供体 (低病理17、中间10、高病理15) |
BA9前额叶、BA7楔前叶、BA17初级视觉皮层等 | Drop-seq/10x 3′v3/v2 含All Nuclei与NeuN富集文库 |
候补(snRNA差异表达/同脑区独立验证)(因为病理不完全等于AD-NC) |
| GSE268599 | snRNA-seq:BA46前额叶有32位供体、146个脑区样本 | EC、ITG、BA46 DLPFC、V2、V1 | 去除神经元和少胶后进行10x 3′snRNA-seq | 星胶富集,后续验证用 |
| GSE237718 | snRNA-seq:29AD+27control | temporal cortex | 10x 3′v3 | 跨脑区独立验证(颞叶) |
| SRP456327 | 长读长RNA seq:6AD+6control | DLPFC,BA9/46 | poly(A)富集PCR-cDNA Oxford Nanopore PromethION |
转录本结构判定 |
| GSE282551 | 长读长RNA seq:16NC+14精神分裂症 | DLPFC BA8/9 cortex | PacBio Sequel II/IIe Iso-Seq | 转录本结构判定 |
- 主分析数据:GSE157827的21位+GSE174367的18位+GSE214979的15位+GSE183068的23位+GSE310554的18位,总计约95位供体(54AD+41对照)
用gpt以及之前的论文总结了一些关于后续遗传分析的数据:(find by GPT待补充)
| 数据集 | 脑区 | 建库方法/详细信息 | 包括哪些数据 | 用途 |
|---|---|---|---|---|
| CommonMind | DLPFC | 已有RNA及基因型构建的预测模型 | HERV和gene的FUSION/FOCUS权重与示例参考面板 | HERV rTWAS、条件分析及精细定位 |
| GTEx SERVE | 含多个脑区 | bulk RNA组装及cis-ervQTL分析 | hervRNA注释、汇总补充表 完整逐SNP QTL统计需另行取得 |
注释比对 条件具备后开展HERV共定位及SMR |
| AD GWAS GCST90027158 | - | 分型、填补及GWAS荟萃分析 | SNP风险效应、标准误、等位基因等summary | rTWAS及条件性QTL整合的疾病端输入 |
| SingleBrain | 多脑队列 | snRNA与基因型eQTL荟萃分析 | gene cis-eQTL及细胞类型信息 | 宿主或邻近gene的遗传关联和替代解释 |
建立AD相关HERV表达图谱(snRNA)
关于hERV注释暂时找的资源如下:(后续还需整合补充)
- 也许可以在Telescope的注释上继续扩展出包含LTR的注释
- 正式确定前要先运行几个样本测试计数,比较只有Telescope、全部RepeatMasker和我自己版本间的差别
| 资源 | 覆盖特点 | 优点 | 主要问题 | 用途 |
|---|---|---|---|---|
| Telescope HERV_rmsk.hg38.v2 | 以internal/provirus相关HERV位点为主 | 位点清楚、数量适中、适合多重比对分配 | 缺少soloLTR | 可以作为总注释的基础 |
| ERVmap | 3,220个较完整proviral ERV | 高可信、结构完整 | 覆盖非常窄,基本不解决soloLTR问题 | 全长hERV参考? |
| UCSC RepeatMasker/Dfam | 几乎所有LTR/ERV片段 | 覆盖最广,包括大量soloLTR候选 | 包含很多不需要的TE,命名和结构不统一 | 构建Telescope注释的原始来源 |
| SERVE | 从GTEx bulk RNA组装出13,889个hervRNA,其中8,139个被归为soloLTR来源 | 有实际RNA转录支持 | 依赖正常bulk组织表达,可能漏掉AD或特定细胞事件 | 注释和转录本结构参考 |
| HERVarium | 合并RepeatMasker碎片并区分5′LTR、3′LTR、tandem和soloLTR | 有可能会是一个比较好的soloLTR补充 | 还需要具体看一下基因组版本、标注质量和命名问题 | 补充soloLTR |
比对计数:基本延续毕设的方法
- STARsolo保留多重比对,Stellarscope计数
- Seurat过滤低质量细胞,scDblFinder去除双核,Harmony/Seurat integration去批次效应,根据gene计数注释细胞类型
- 吸取毕设的经验:在这里可以先处理“被gene和hERV都计数了的UMI”(同一个UMI既被gene矩阵计入某个基因,又因与HERV/LTR重叠而被HERV矩阵计入),将它们从gene中去除(避免后续计算gene~hERV相关性时拉高平均值)
差异分析:pseudobulk+单细胞普通差异分析
- pseudobulk:同一供体同一细胞类型的HERV raw counts相加(如果某个供体在某类细胞中的核数过少就排除该供体的这一细胞类型),之后用edgeR来进行差异表达分析
- 单细胞的差异分析直接用Seurat的FindMarkers做,不过仅作参考,最后位点筛选结果以pseudobulk的为主
- gpt在选候选位点的时候,对于这种多队列的情况提到了一个“随机效应荟萃分析(metafor)”。具体来说,如果一个HERV只在某个队列显著,而其他队列效应接近0或方向相反,它应被标记为队列特异信号;而如果多个队列P值不都显著,但效应方向一致且荟萃结果稳定,则仍可作为可信候选
- 从指定gene/通路变化看hERV的变化:
- 在每个大类内部基于gene重新降维和聚类,使用marker gene注释homeostatic microglia、DAM-like/inflammatory microglia、reactive astrocytes、应激神经元等状态;或使用UCell计算已有AD相关signature,例如干扰素反应、补体、APOE-TREM2、吞噬、脂质代谢、髓鞘、突触和细胞应激评分,再按连续评分或预定义阈值识别状态
- 随后分别分析:细胞组成变化(AD-NC)、状态内/状态间HERV的差异
- 从候选hERV看gene/通路的变化:
- 对于已经筛出的候选,可以进一步比较HERV-positive和HERV-negative细胞的gene表达
- 存在一个重要问题:hERV高会不会只是因为测序深度高,因此也许“根据gene/通路分细胞亚群,再在亚群内/间差异表达分析”的思路更稳定
- 在其它队列中验证,重点是效应方向一致(不要求p值显著)
如果结果和别的研究不一样。评估是否是3’测序数据的影响:
- 选取既往bulk研究报道上调的HERV-K位点,在bulk和snRNA数据中计算同一组位点的reads覆盖
- 按HERV方向统一为5′→3′,将结构可比的区域缩放为相同数量的bin,分别绘制bulk和snRNA中AD与对照的平均覆盖曲线
- 重点检验bulk中的AD相关增加信号是否集中于5′或内部区域,而这些区域在10x 3′snRNA中覆盖不足,从而评估3′捕获偏倚对两类数据结果不一致的贡献
细胞类型的细分:借助SEA-AD等大规模图谱建立特定细胞亚型或状态的reference,再将注释迁移到自己的小数据集中,探索HERV变化是否集中在某些更细的细胞群体
- 以小胶质细胞为例,可以利用SEA-AD公开处理后的数据作为reference,通过Seurat label transfer辅助注释各队列中的小胶质细胞及相关髓系细胞,区分microglia、血管周围巨噬细胞(PVM)和monocyte-like细胞
- 在小胶质细胞内部,结合参考标签和UCell基因集评分,识别稳态、DAM-like、炎症和增殖等状态,并单独评估外周髓系样表达特征
- 随后开展两类分析:
- 亚群比例变化:以供体为单位,比较AD与对照中各亚群的比例
- 亚群内HERV差异:按donor×亚群汇总HERV raw counts,使用edgeR比较AD与对照,并检查跨队列结果是否一致
- 区分:整体HERV变化是由于某类细胞比例增加,还是同一亚群内部的HERV表达发生改变
确定候选HERV实际对应的转录本结构
建立长读长脑组织转录本参考:
- ONT数据先使用NanoPlot检查read length和质量;PacBio数据根据下载形式从CCS或已处理的HiFi reads开始
- 分别使用minimap2的splice-aware模式比对到GRCh38,两种平台的数据先独立处理
- bambu进行多样本转录本发现和collapse
- SQANTI3结合GENCODE检查splice junction、转录起止位置、intron retention和潜在RT-switching等问题
- IGV人工检查最终重点候选:如果bambu对单外显子或5′端结构合并过度,可用FLAIR或StringTie2 long-read模式进行复核
- 注:长读长两端不完整仍然是常见问题,因此长read覆盖到某一位置不自动等于真实TSS或TES
(用新参考重新建立STAR索引,把bulk RNA数据重新比对,检查候选HERV位点的总体计数是否仍然有差异、特异HERV–gene junction是否有差异、候选位点的检出率是否提高,如果差别很大的话可以考虑用新索引重新比对snRNA数据)
对候选转录本进行结构分类:
- 将长读长转录本与HERV_rmsk.hg38.v2位点、GENCODE gene和LTR坐标进行交集,根据方向和连接关系分为:
- 推定全长HERV来源转录本:同一长分子按正确方向连接5′LTR、internal region和3′LTR,最好有多个独立read、多个样本或两个平台支持,并且read包含能够唯一定位到该HERV位点的序列
- HERV/LTR→gene嵌合转录本:长read从HERV或LTR区域开始,并连接到下游gene exon,可能对应替代启动子或新的5′外显子
- gene→HERV嵌合转录本:宿主外显子连接到HERV,HERV可能成为内部外显子、3′UTR或终止区域
- 宿主基因读穿:转录从上游gene开始,连续延伸进入HERV区域
- LTR-only或短HERV相关RNA:只有LTR或局部HERV片段形成稳定RNA,没有证据支持完整前病毒转录
- 结构不确定:read缺乏唯一锚定区域、长read只覆盖一端、多个高度相似位点均可解释,或支持read太少
- 也可以稍微简单一点。根据是hERV/LTR自己转录还是gene转录来区分:
- HERV/LTR主导型:转录起点位于HERV或LTR,RNA从这里向外延伸
- 宿主基因主导型:RNA从宿主基因起始,随后读穿或剪接进入HERV/LTR
- 不确定型:只有局部覆盖、长读长5′端不完整、reads不足或多重比对无法区分
回到bulk RNA验证junction和覆盖:
- 将高可信长读长转录本整理成自定义GTF,bulk RNA使用STAR two-pass重新比对,并通过regtools提取splice junction
- 对于每个候选检查:
- 5′LTR、internal和3′LTR的链特异覆盖
- HERV与gene之间的特异splice junction
- HERV junction变化是否只是宿主gene整体表达变化
- AD与对照中junction counts是否变化
- 相同结构是否出现在多个脑区或多个供体中
解析HERV表达变化的调控机制
先判断宿主基因转录能否解释HERV信号:
- 对每个候选整合:HERV和邻近gene的链方向、HERV位于gene的哪个区域、长读长是否从gene连续进入HERV、是否存在HERV-gene splice junction、HERV和宿主gene在供体层面的表达关系
- 比较
HERV∼diagnosis+covariates和HERV∼diagnosis+host gene expression+covariates,如果加入host gene后diagnosis效应明显减弱,同时长读长支持gene readthrough,则很可能是宿主基因转录影响
分析局部染色质开放:
- snATAC数据使用Signac或ArchR处理后(包括TSS enrichment、nucleosome signal、FRiP、doublet和细胞类型注释),也按donor×cell type汇总peak counts,并使用edgeR或limma进行差异开放分析
- 对每个候选检查:HERV本体是否与ATAC peak重叠、5′LTR是否开放、HERV上下游局部区域是否存在AD相关DAR、开放性变化是否与HERV RNA方向一致、同一cell state中RNA和ATAC是否共同变化等
建立TF调控证据链:
- 对候选的LTR用HERVarium已有motif和JASPAR 2024进行候选LTR motif注释,再用chromVAR估计对应细胞类型中的TF motif activity
- 对于每个候选检查:
- 候选HERV的5′LTR或开放区域存在该TF motif
- 该区域在相应细胞类型中可及性
- TF自身在RNA层面表达,且AD或相关cell state中发生变化
- chromVAR motif activity与HERV表达方向一致
- 这种关系能够在另一队列或相近细胞状态中复现
对少数候选建立解释性模型:HERV expression∼diagnosis+local accessibility+host gene expression+TF activity+covariates
- 局部开放性是否能解释HERV个体差异
- TF活性是否在开放性之外提供额外解释
- 加入这些因素后,AD系数是否减小
最终将候选分为:
- 宿主基因读穿或嵌合驱动型
- 局部染色质开放相关型
- TF或细胞状态相关型
- 多因素共同解释型
- 暂无法确定机制型
分析候选HERV关联的细胞功能
gpt首先推荐用hERV~gene的相关性来作为选gene的指标:gene expression∼HERV expression+diagnosis+covariates
- 根据HERV相关gene的统计量排序,使用fgsea分析Hallmark、Reactome和GO通路。与简单相关相比,该模型可以控制diagnosis,减少“AD同时使HERV和炎症基因升高”造成的表面相关
- 如果某种细胞类型具有至少约30位有效供体,可在pseudobulk矩阵上使用WGCNA建立gene module,再判断候选HERV与哪个module eigengene相关
- 验证:文献、能否在独立队列复现
最后汇总结果,大致包含以下项:
- 主队列荟萃差异
- 同脑区复现
- 跨脑区复现
- cell state特异性
- 长读长结构
- bulk junction支持
- 宿主基因读穿证据
- LTR开放性
- TF证据
- 功能模块
HERV遗传关联分析
第一条路线:使用CommonMind HERV/gene预测模型和AD GWAS GCST90027158进行rTWAS
- 对AD GWAS进行等位基因、效应方向、重复SNP和频率检查
- 选择与GWAS祖源匹配的LD参考
- 使用FUSION检验遗传预测的HERV表达是否与AD风险相关
- 对显著区域同时加入附近gene预测模型进行joint/conditional analysis
- 使用FOCUS进行TWAS fine-mapping,判断HERV与邻近gene中哪些对象更可能解释关联
- 检查rTWAS方向是否与病例脑中的真实表达方向一致
- 优点:CommonMind使用Telescope的hERV注释,可以与我使用的对应上一部分
- 缺点:CommonMind是bulk DLPFC模型,不细分细胞类型;最关键的是这个模型属于比较确定的模型,可扩展的空间不大,只能用于提高部分候选的优先级
第二条路线:如果能获得完整逐SNP HERV-eQTL统计,可以进行coloc或SMR,确定完整的hERV-gene-AD机制
- HERV-eQTL与AD GWAS共定位
- HERV-eQTL与附近gene-eQTL共定位
- gene-eQTL与AD GWAS共定位
- SMR+HEIDI作为补充检验
总体顺序:(遗传分析之前)
- 下载数据、建立一份比较准确全面的hERV注释表,STAR+Stellarscope比对snRNA\bulkRNA\snATAC数据,分别质控后整合多队列进行细胞类型注释
- 第一轮分析:基于统一HERV/LTR位点注释,做各队列donor×cell type pseudobulk差异分析(不依赖转录本结构假设,先广泛筛选疾病相关位点)
- 支线1:用长读长建立脑组织HERV转录本参考(判断HERV/LTR自身起始、宿主基因读穿及全长可能性)
- 支线2:比较bulk与10x 3′snRNA的HERV-K覆盖分布(检验过去bulk信号是否主要落在单核数据难以捕获的5′或中部区域)
- 第二轮分析:将高可信长读长转录本回贴到bulk和snRNA,重新统计特异区域和junction(回收稀疏位点的有效信号,并重新检验候选)
- 支线:小胶质细胞身份/来源样特征×疾病状态×HERV(确定HERV究竟与哪类小胶质细胞变化相关)
- 整合宿主基因、ATAC、TF、细胞状态,为少量重点HERV建立解释链
最终修改:
- 用长读长数据建转录本参考后,和hERV注释融合作为计数的gtf再计数(相当于把上面的第一轮和第二轮合并)
- 结构分类不作为重点
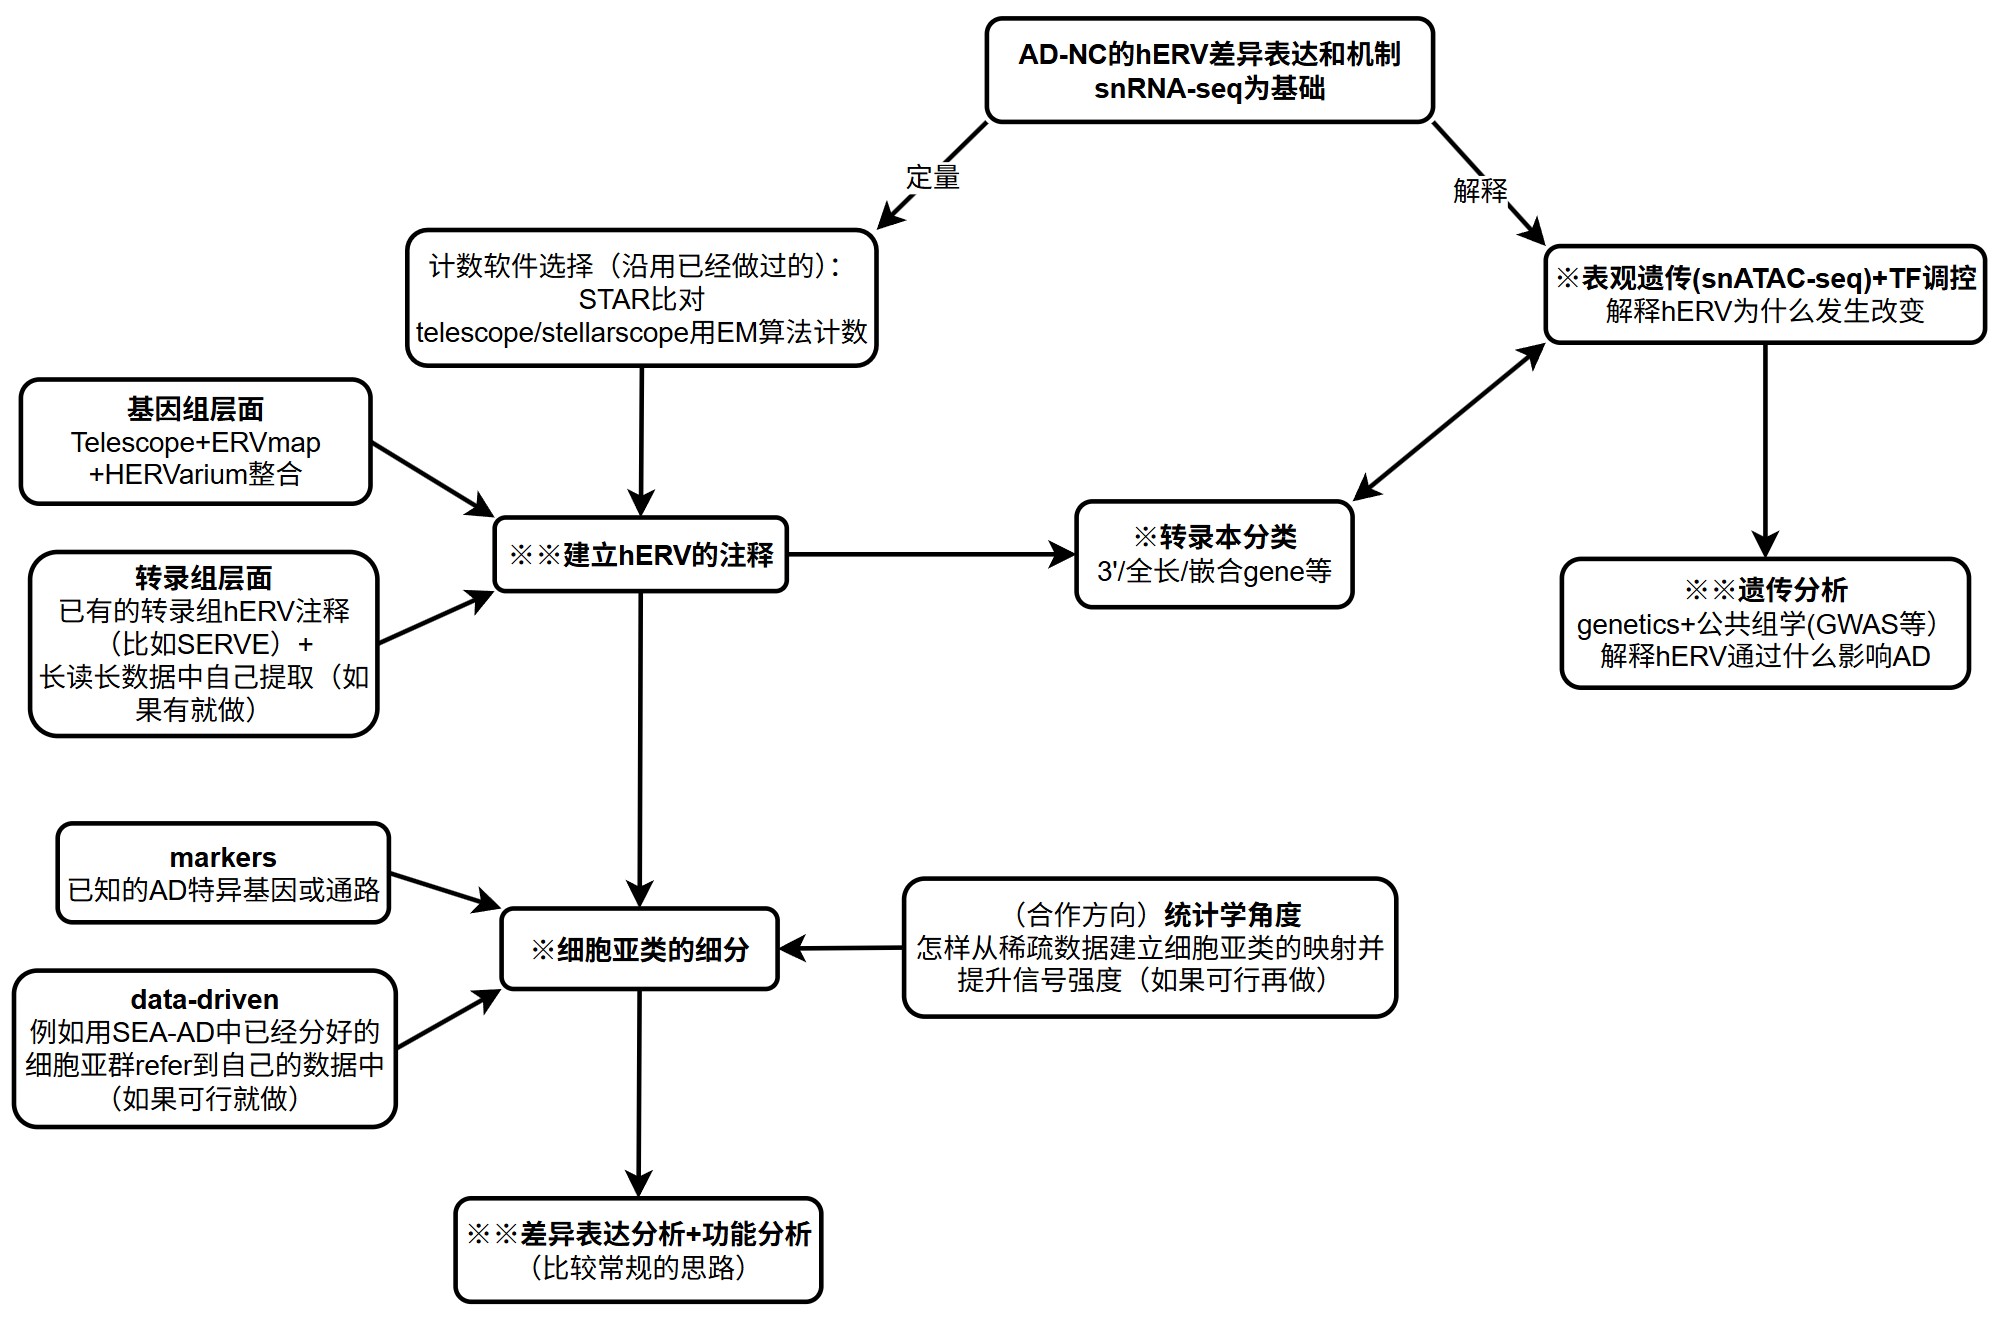
形成的大致流程图如下(※代表重要/优先程度):
碱基编辑
基础概念
碱基编辑(base editing, BE):传统Cas9通常造成DNA双链断裂,然后细胞修复时产生indel(核苷酸片段的插入或缺失)。碱基编辑器一般是把Cas9 nickase和一个脱氨酶deaminase融合起来,让它在不造成双链断裂的情况下,把某个碱基改成另一个碱基。常见几类是:
- ABE(adenine base editor):把A•T改成G•C
- CBE(cytosine base editor):把C•G改成T•A
- CGBE(C•G to G•C base editor):把C•G改成G•C
可以把CRISPR系统想象成“定位器+编辑器”:
-
sgRNA是定位器,它里面有一段通常20个核苷酸(20nt)长的序列,叫spacer,这段序列和目标DNA互补配对,DNA上被它识别的那段互补序列叫protospacer
很多模型说“输入20nt protospacer”,本质上就是输入目标DNA序列附近的信息
- PAM是Cas9识别目标时需要的短序列,比如经典SpCas9常见PAM是NGG。没有合适PAM,即使sgRNA和DNA能配对,Cas9也不一定能稳定结合。所以PAM会影响一个位点能不能编辑,也会影响目标碱基落在编辑窗口的哪个位置
- scaffold是sgRNA中不与DNA配对、负责和Cas9结合的结构部分

↑以CBE的工作原理为例,参考文章
编辑任务里有三个层次:
-
第一,能不能编辑,也就是效率高不高
编辑效率(editing efficiency):在某个位点,有多少比例的测序reads发生了目标类型的碱基转换
- 比如某个ABE实验中,一个目标A位点测到1000条reads,其中300条A变成G,那么这个位置的A-to-G编辑效率可以理解为30%
- 不同论文的具体定义有细微差别,有的看总编辑效率,有的看某个位点的编辑频率,有的看所有编辑产物中某种产物的比例
-
第二,编辑哪里,也就是窗口在哪些位置
编辑窗口(editing window):在sgRNA对应的protospacer中,哪些位置最容易被碱基编辑器改到
- 例如经典ABE可能在protospacer的第4-8位附近编辑比较高。假设第5位和第7位都有A,那么ABE可能不只改你想要的第5位,也会顺手改第7位。这个“顺手改掉的附近碱基”就是bystander edit
-
第三,是否精准,也就是只改目标碱基,还是把旁边的A/C也改掉
bystander和off-target:
- Bystander edit:同一靶点内部的不精准——发生在同一个目标位点附近。比如你想改protospacer第5位的A,但第6位、第7位也有A,ABE也把它们改了
- Off-target edit:靶点外编辑——发生在基因组其他位置。也就是sgRNA本来应该去A位点,但它跑到相似序列的B位点也发生结合和编辑
R-loop可以理解为Cas9-sgRNA识别DNA后形成的“打开状态”。正常DNA是双链配对的。Cas9带着sgRNA来到目标位点后,sgRNA会和DNA中的一条链配对,另一条DNA链被挤开,于是局部DNA双链被打开,这个结构就叫R-loop
- 碱基编辑器里的脱氨酶要接触到目标碱基,DNA必须在局部处于比较可接近的状态。或者说,某个位置DNA双链打开得越充分,脱氨酶越可能接触到那个碱基,编辑效率可能越高
-
distance就是DNA两条链之间的距离(三维结构里的空间距离)
C1-C1 pdb Cas9 absolute:大概率指的是在结构中计算两条DNA链对应碱基的C1’原子之间的距离,C1’是核糖/脱氧核糖上的一个原子。正常双链DNA中,互补碱基靠得很近;当R-loop打开后,两条链距离变大
短sgRNA:
-
短sgRNA形成的R-loop可能不那么稳定,可能让编辑窗口变窄、bystander减少,编辑更精准(18-nt或16-nt sgRNA能减少bystander)
标准sgRNA一般是20nt,短sgRNA比如18nt或16nt,和DNA互补配对的长度变短,R-loop可能变短或不稳定;如果R-loop打开范围变小,那么脱氨酶能接触到的DNA区域可能也变窄,可能减少不想要的bystander
- 短sgRNA也可能降低整体on-target效率,因为定位和结合变弱
- 是否会降低脱靶:
- R-loop稳定性降低后,非目标位点不容易被Cas9打开,会降低脱靶
- 匹配核苷酸更少,可能反而更容易匹配到其他位置
- 后续需要数据支持
AF3:AlphaFold3。这里不是直接用AF3预测编辑效率,而是用AF3预测Cas蛋白+sgRNA+DNA复合体的三维结构
- 在这里,20-nt真实结构只有两个,18-nt、16-nt这些只能用AF3预测;他们把Cas蛋白、RNA、DNA复合体拿去AF3预测,然后从结构中提取DNA双链distance
空间构象转移映射:不是标准名词,按聊天内容理解,它大概是
- 先在20-nt条件下建立关系:
20-nt R-loop distance → 20-nt真实编辑效率/窗口 - 然后把这个关系迁移到18-nt条件:
18-nt R-loop distance → 预测18-nt编辑效率/窗口 -
它假设“distance和编辑效率之间的关系”在不同sgRNA长度之间可以部分复用。这个思路直观,但有一个关键假设:18-nt和20-nt的主要差别可以由R-loop distance解释
distance是否只和长度有关?还是也和target sequence本身有关?目前只试了一个位点的不同长度,所以这个假设还不能算稳
论文主要思路
2020Cell_Determinants of Base Editing Outcomes from Target Library Analysis and Machine Learning:比较早、比较经典的碱基编辑预测工作。在哺乳动物细胞中分析了38,538个整合到基因组中的靶点
- BE-Hive包含两个主要部分:
- efficiency model,预测这个靶点总体编辑效率高不高。它用到的特征包括sgRNA melting temperature、G/C比例、dinucleotide motif、activity window等
- bystander editing model,预测具体会产生哪些编辑产物。比如第5位A被改、第7位A被改、两个都改,分别占多少比例。这个部分用了deep conditional autoregressive model,可以预测bystander pattern
- 关心“编辑效率+旁观者编辑+精准性”,非常适合拿来理解短sgRNA如何减少bystander。但它原始输入主要还是序列,不是R-loop三维结构
2023NBT_Deep learning models to predict the editing efficiencies and outcomes of diverse base editors:编辑器和Cas9变体太多了,怎么选最合适的组合。系统比较了7种base editor和9种Cas9变体,开发了两个模型
- DeepCas9variants:预测不同Cas9变体在某个目标序列上的活性。也就是先判断“哪种Cas9更适合这个PAM/这个序列”
- DeepBE:进一步预测63种BE的编辑效率和结果。63来自7种base-converting domain×9种Cas9 nickase变体
- 这篇文章是“选择编辑器/选择Cas9变体/选择sgRNA”的工具,重点是PAM和Cas9变体带来的差异。也说明了一个概念:sgRNA设计和效率预测是两件事,但常常被集成在一个工具里
2025Genome Biology_Predicting adenine base editing efficiencies in different cellular contexts by deep learning:主要研究adenine base editing,也就是ABE,而且特别关注不同细胞环境和递送方式,比如HEK293T细胞、mRNA-LNP、AAV、小鼠肝脏等。有两个输出层面的模型
- Efficiency Model:预测总编辑效率
- Proportion Model:预测编辑产物在edited reads中的分布
- 两个模型的输出结合起来得到最终编辑效率预测
- 对我们的研究价值比较高:
- 是ABE方向,和ABE8e、短sgRNA窗口比较贴近
- 有比较丰富的实验数据,可以拿来训练“distance→编辑窗口”的简化模型
- 它本身的主要创新点不是sgRNA长度,而是不同细胞/递送环境下ABE预测,尤其是mRNA递送数据更能保持in vivo预测准确性
2025NC_Deep learning models simultaneously trained on multiple datasets improve base-editing activity prediction:“效果最好”的模型。把多个来源的数据一起训练,并且保留每条数据来自哪个dataset的信息。整合了ABE7.10、ABE8e、BE4等多个数据集,开发了CRISPRon-ABE和CRISPRon-CBE,用于预测gRNA编辑效率和outcome frequency
- 输入不只是20nt protospacer,还包括
- 30nt target sequence = 20nt protospacer + PAM + 两侧flanking sequence
- gRNA-DNA binding energy ΔGB
- predicted Cas9 efficiency
- target nucleotide editing position
- dataset one-hot encoding:告诉模型这条数据来自SURRO-seq、Song、Arbab、Kissling ABE7.10还是Kissling ABE8e。让模型可以学习不同数据集之间的共性和差异;预测时还可以给不同dataset设置权重
| 模型/论文 | 主要解决什么 | 输入主要是什么 | 输出是什么 | 和现任务的关系 |
|---|---|---|---|---|
| 2020Cell BE-Hive | 预测BE效率和bystander pattern | target sequence、sgRNA特征、base editor、cell type等 | 编辑效率、编辑产物分布 | 经典、相对早、适合理解bystander和precision |
| 2023NBT DeepBE | 在很多Cas9/BE组合里选最合适的 | 序列、PAM、Cas9变体、BE类型 | 63种BE的效率和outcome | 适合理解“sgRNA设计”和“BE选择” |
| 2025Genome Biology BEDICT2.0 | 预测ABE在不同细胞/递送环境中的效率 | protospacer+PAM等序列输入 | ABE效率和产物比例 | A已用其数据做初步尝试,适合短期推进 |
| 2025NC CRISPRon-ABE/CBE | 多数据集联合训练,提高ABE/CBE预测 | 30nt序列、ΔGB、Cas9效率、dataset标签等 | gRNA效率和outcome frequency | 更像当前最强参考框架,适合后续做严肃模型 |
“sgRNA设计工具”和“efficiency预测工具”是什么关系:概念上是两件事,实际工具里经常合在一起
- sgRNA设计是先找候选项。例如给你一个想编辑的A,程序会找附近有没有合适PAM,设计哪些sgRNA能让这个A落在编辑窗口里
- efficiency预测是给这些候选sgRNA打分。例如sgRNA1预测效率30%,sgRNA2预测效率5%,sgRNA3虽然效率高但bystander很多
- 实际应用时一般是:先生成候选sgRNA → 再预测每条sgRNA的效率和bystander → 排序选择最优方案
如果只是把sgRNA长度加进模型sequence特征 + sgRNA长度 → 编辑效率,那创新性比较弱,因为长度只是一个普通条件变量,更完整的模型是sgRNA长度改变 → R-loop结构改变 → DNA打开程度改变 → 编辑窗口改变 → bystander减少、精准性提高
- 新特征不是“18”或“20”这个数字,而是18-nt/20-nt条件下每个位置的R-loop distance曲线
- 比较可创新的地方是把结构信息引入碱基编辑预测模型。过去这些模型主要用序列、PAM、编辑器类型、Cas9活性、binding energy、dataset来源等特征,没有显式用三维结构信息
R-loop distance到底是主要由sgRNA长度决定,还是也受target sequence影响:
- 如果distance只和长度有关,那么18-nt所有位点都用同一条distance曲线,这更像是一个“全局窗口校正因子”
- 如果distance和每条sgRNA/target sequence都有关,那么就需要给每条sgRNA都预测结构,再提取position-specific distance,这样才是真正的结构增强模型
四篇论文已经能根据序列、PAM、编辑器类型、Cas9活性、数据集来源预测20-nt sgRNA下的碱基编辑效率和产物分布,现在想加入的是sgRNA变短后R-loop三维构象变化产生的DNA双链distance特征,用它把模型从20-nt条件扩展到18-nt/16-nt条件,并重点解释为什么短sgRNA可能让编辑窗口变窄、bystander减少、精准性提高
2025NC crispron-BE
module load miniconda3/base
conda activate crispronbe
conda create -n crispronbe python=3.10 tensorflow=2.10.0 biopython=1.79 viennarna=2.5.1 pandas=2.2.2 matplotlib openpyxl gemmi scikit-learn -y
cd ~
git clone https://github.com/RTH-tools/crispron-BE.git
cd crispron-BE
bash bin/download_and_test.sh
大致流程:
- 输入一段DNA序列
- 找出符合NGG PAM的30nt target
- 计算一些辅助特征
- 枚举可能的碱基编辑产物
- 把这些东西转成神经网络能读的矩阵
- 加载训练好的模型
- 输出编辑效率和各编辑产物频率
项目结构
bin/CRISPRonBE.sh:总入口,负责串联全部步骤bin/get_30mers_from_fa.py:从输入FASTA中找30mer和23merbin/CRISPRspec_CRISPRoff_pipeline.py:计算CRISPRoff特征bin/DeepCRISPRon_eval.py:预测Cas9活性,生成crispron.csvbin/DeepCRISPRonBE_eval.py:主预测脚本,加载CRISPRon-BE模型(控制“预测时”怎么构建输入特征)bin/DeepCRISPRonBE_train.py:训练脚本,定义模型结构(控制“训练时”模型结构是什么)data/CRISPRonBE_models/ABE/:训练好的ABE模型data/CRISPRonBE_models/CBE/:训练好的CBE模型
总入口:./bin/CRISPRonBE.sh ABE input.fa outdir weight
ABE/CBE:选择碱基编辑器类型input.fa:输入DNA序列outdir:输出目录weight:可选,dataset权重
先生成30mers.fa和23mers.fa,然后用CRISPRoff生成CRISPRparams.tsv,然后用DeepCRISPRon生成crispron.csv,最后用DeepCRISPRonBE_eval.py生成最终预测结果
get_30mers_from_fa.py生成模式需要输入的FASTA:4nt upstream + 20nt protospacer + 3nt PAM + 3nt downstream格式
- 扫描输入序列
- 找到符合NGG PAM的位置
- 取这个位置附近的30nt
- 同时输出23nt guide+PAM
PRE_GUIDE=4
GUIDE=20
PRE_PAM=1
PAM='GG'
POST_PAM=3
TOTAL=30
- PAM实际是NGG:其中PRE_PAM=1代表PAM第一个任意碱基N,
PAM='GG'代表后两个碱基必须是GG - 后续所有模型输入都围绕这个30nt target展开
get_30mers_from_fa.py-CRISPRparams.tsv:给每个target加一个“gRNA-DNA结合/结构稳定性相关”的数值特征,包含RNA-DNA hybridisation energy、DNA-DNA opening energy、spacer self-folding energy和CRISPRoff score等特征,但实际上CRISPRon-BE主模型实际只取了CRISPRoff_score这一列(从30mer中截取20nt protospacer + 3nt PAM,然后用这个23mer去这个文件里查对应的CRISPRoff_score)
DeepCRISPRon_eval.py-crispron.csv:Cas9活性预测(也是模型的输入特征),包含30nt序列和CRISPRon预测的Cas9 indel frequency。读取30mer和CRISPRoff特征,构建两个输入30nt one-hot序列+CRISPRoff相关数值,然后加载CRISPRon模型预测Cas9活性,输出ID,30mer,CRISPRon
one-hot编码:神经网络不能直接读A/T/G/C这些字符,所以要把序列转成数字矩阵
-
一条简化的4nt序列ATGC会变成
A  [1,0,0,0]
T  [0,1,0,0]
G  [0,0,1,0]
C  [0,0,0,1]
这样的4×4二维矩阵
-
实际的模型输入:
one_hot: (None,30,4),None表示样本数量可以变化,比如预测10个outcome,shape就是10 × 30 × 4
outcome_properties:CRISPRon-BE不是只预测“某条gRNA总体效率是多少”,它还预测不同编辑产物的频率
- 同一个target可能产生多个outcome:例如ABE编辑窗口内有2个A,会有3种编辑产物
- 第1个A被编辑
- 第2个A被编辑
- 两个A都被编辑
- outcome_properties是一个8维向量,表示编辑窗口内每个位置是否被编辑:比如窗口长度是8,如果第2和第5个位置被编辑,就可以表示成
[0,1,0,0,1,0,0,0]
模型的输入是所有target的所有possible outcomes数量:假设有一条target窗口里有3个A,那么可能outcome有7种,程序会生成一个dataframe
seq_id   target   outcome1   outcome_feature1
seq_id   target   outcome2   outcome_feature2
seq_id   target   outcome3   outcome_feature3
...
seq_id   target   outcome7   outcome_feature7
| 输入名 | 形状 | 内容 | 来源 |
|---|---|---|---|
one_hot |
n × 30 × 4 |
30nt target序列 | 30mers.fa |
outcome_properties |
n × 8 |
编辑窗口中哪些位点被编辑 | 程序枚举outcome |
energy_properties |
n × 1 |
CRISPRoff score | CRISPRparams.tsv |
cas9 |
n × 1 |
CRISPRon预测Cas9活性 | crispron.csv |
dataset |
ABE:n × 5; CBE:n × 3 |
数据集权重 | 命令行weight |
- dataset weight:该模型不是把所有数据混在一起当成同一种实验
- ABE需要5个weight,依次代表SURRO-seq、Song、Arbab、Kissling ABEmax、Kissling ABE8e;CBE需要3个weight,依次代表SURRO-seq、Song、Arbab
0-0-0-0-1代表完全按Kissling ABE8e数据集来做dataset条件,0.5-0.5-0-0-0就是SURRO-seq和Song数据集各占50%- 如果gRNA是为ABE8e设计的,建议给Kissling ABE8e数据集100%权重;如果是ABE7.10或BE4且平台不清楚,则根据scaffold和实验平台选择不同权重
模型结构:以ABE模型为例,它本质上是一个多输入的卷积神经网络(CNN)+多层全连接网络(MLP)
ABE模型的one_hot输入先进入三个卷积分支Conv1_1D/Conv2_1D/Conv3_1D;它们分别输出不同长度和filter数量的序列特征,然后经过pooling、flatten,拼接成一个6140维向量,再进入Dense层
one_hot输入
→ Conv1D分支1
→ Conv1D分支2
→ Conv1D分支3
→ Flatten
→ 拼接
→ Dense1
→ 拼接outcome/energy/cas9/dataset
→ Dense2
→ Dense3
→ Output:2个数
- 卷积分支
Conv1_1D/Conv2_1D/Conv3_1D:相当于用三种不同的“扫描器”看同一条30nt序列,学习DNA序列中不同长度的局部sequence motif与ABE活性之间的规律- Conv1_1D → 输出
(None,28,240) - Conv2_1D → 输出
(None,26,140) - Conv3_1D → 输出
(None,24,80)
输出长度不同,通常意味着卷积核大小不同。卷积核越大,一次看的序列片段越长;卷积核越小,更关注短motif。然后模型把这些不同尺度的信息拼起来
卷积 kernel size filters 直观含义 Conv1 3 240 扫描3nt局部模式 Conv2 5 140 扫描5nt局部模式 Conv3 7 80 扫描7nt局部模式 - 例如一个kernel size=3的卷积会依次看
位置1–3+位置2–4+位置3–5+…+位置28–30,在训练过程中自己寻找“什么3nt组合、出现在什么区域,和编辑效率有关” - 一个filter可以理解成一个“模式探测器”,240个filters就相当于模型同时学习240种不同的3nt相关模式
- Conv1_1D → 输出
-
Dense层和拼接层:卷积以后得到的还是“位置×特征”的二维东西
例如Conv1的处理过程是
30×4 ↓ Conv kernel=3 28×240 ↓ AveragePooling 14×240- Flatten把
14×240直接摊平成3360,三条卷积分别得到Flat1=3360+Flat2=1820+Flat3=960 - Dense1提取序列特征:
3360+1820+960=6140→Dense1→900,这900个数字已经不再能简单解释成“第几个碱基是什么”,它是模型把整条30nt序列压缩后得到的一种内部表示(sequence representation/hidden representation/latent representation),可以很粗略地理解成“这900个数字总结了模型认为这条30mer在ABE编辑方面有哪些重要序列特征” - Dense2/3把序列特征和其它非序列特征拼起来:
Dense1结果 + outcome + CRISPRoff + CRISPRon + dataset weight → Dense2/Dense3 → 输出(后面加特征可以加在这里)
- Flatten把
- 输出的两个数
pred_eff:这条gRNA的总体编辑效率,同一个target的不同outcome会共享一个最终pred_eff。程序会在normalize_dataset()中对同一个seq_id下的pred_eff取平均pred_freq:当前这个outcome的预测频率
- 结果表
- 一行 = 一个target的一种可能编辑产物
- pred_eff = 这条target/gRNA总体有多少比例会被编辑
- pred_freq = 具体变成这一种产物的比例
关键组成部分:
- 训练脚本
DeepCRISPRonBE_train.py:负责读取训练数据、定义模型结构、把输入X和真实标签y喂给模型、不断调整模型参数、保存表现最好的模型model.fit(tx,ty,validation_data=(vx,vy),...):训练过程。ty/vy是真实实验值,代表真实editing efficiency和真实outcome frequencyModelCheckpoint(args.m,save_best_only=True):保存最佳模型
- 预测脚本
DeepCRISPRonBE_eval.py:加载已经训练好的模型、准备输入X、预测、输出预测结果keras.models.load_model(path)和model.predict(X):预测- 为什么有很多模型
model_1_1/model_1_2/...:用多个模型分别预测,取平均作为最终预测。这样通常比单个模型更稳定
- 训练数据格式
- refs:20nt gRNA sequence
- outcomes:20nt outcome sequence
- editingeff:gRNA editing efficiency
- outcomefreq:outcome frequency
- surro_target:30nt target DNA sequence
- source:数据来源
- partition:分区
总结:
| 阶段 | 文件/函数 | 输入 | 输出 | 作用 |
|---|---|---|---|---|
| 找靶点 | get_30mers_from_fa.py |
任意FASTA | 30mers.fa,23mers.fa |
找NGG PAM并提取固定长度序列 |
| 算能量 | CRISPRspec_CRISPRoff_pipeline.py |
23mers.fa |
CRISPRparams.tsv |
计算CRISPRoff相关特征 |
| 算Cas9活性 | DeepCRISPRon_eval.py |
30mers.fa,CRISPRparams.tsv |
crispron.csv |
预测Cas9 indel/活性 |
| 枚举outcome | DeepCRISPRonBE_eval.py |
30mers.fa |
内部df | 生成所有可能编辑产物 |
| 构建模型输入 | create_feature_X() |
df+两个特征表 | X=[5类输入] |
转成神经网络能读的矩阵 |
| 预测 | predict_X() |
X+SavedModel | pred_eff,pred_freq | 预测编辑效率和产物频率 |
| 归一化输出 | normalize_dataset() |
原始预测 | crispronABE_prediction.tsv |
保证outcome频率加和合理 |
plan
sgRNA变短后R-loop三维构象变化产生的DNA双链distance特征,并把模型从20-nt条件扩展到18-nt/16-nt条件
- 先跑原模型ABE8e baseline:直接用CRISPRon-BE原模型批量预测一批候选序列(论文中的
2025Genome Biology_Predicting adenine base editing efficienc.xlsx,得到“原模型在20-nt sgRNA条件下的预测结果”,作为后续所有改进的对照(后续加入distance特征时可以以此判断有无提升) - 构建输入:把真实编辑效率和R-loop distance整理到同一张表中,每行表示一个sgRNA的一个编辑窗口位置
- 真实编辑效率:在上述xlsx中有SpRY-ABE8e相关的真实编辑效率(需筛选PAM为NGG的数据)
- 还需要20-nt/18-nt/16-nt sgRNA对应的R-loop distance
- 还需要18-nt真实编辑效率
- 真正修改CRISPRon-BE模型结构:修改DeepCRISPRonBE_train.py和DeepCRISPRonBE_eval.py,把distance作为第6类输入加入神经网络,然后重新训练模型
- 需要原CRISPRon-BE训练数据,且每条训练样本都要补上distance特征,最好还要有18-nt/16-nt真实编辑结果,否则模型只能学习20-nt条件下distance和编辑效率的关系,再外推到短sgRNA
- 可能需要AF3在线预测distance
- cross-attention transformer
已有数据
2025Genome Biology_Predicting adenine base editing efficienc.xlsx:提供大规模真实ABE8e编辑效率数据
- 筛选ABE8e+NGG
- 构建CRISPRon-BE输入30mer
- 运行原模型得到baseline预测
- 用absolute_editing_efficiency和A1-A20_efficiency作为真实值对照
| 类别 | sheet | 含义 |
|---|---|---|
| 实验说明 | Oligos & BE |
高通量测序引物、oligo pool设计、ABEmax/ABE8e相关表达载体序列 |
| 数据总览 | Overview_Datasets |
每个实验条件的replicate名称、初始library size、过滤后library size、合并后的数据sheet名称 |
| 编辑效率数据 | 其余26个sheet | 不同Cas9变体、ABE版本、递送方式/时间条件下的逐sgRNA编辑效率数据 |
- 对baseline最重要的是
ABE8e相关sheet - 每个编辑效率数据sheet的列结构一致
rname:目标突变/疾病位点名称,通常包含转录本编号、基因名、突变形式和蛋白改变。例如类似NM_000021.4(PSEN1)c.1141CtoT...refSeq:与该sgRNA/目标位点相关的20nt序列字段PAM:该sgRNA对应的PAM序列,可选出NGG的来跑baselineTarget-Sequence:较长的目标序列上下文,需要整理出30nt序列作为输入Position:目标编辑碱基在protospacer中的位置,用于确认目标A对应哪个窗口位置absolute_editing_efficiency:实验真实值,该sgRNA的总体编辑效率,作为和原模型预测结果比较的真实值A1_efficiency-A20_efficiency:实验真实值,20nt protospacer每个位置的A-to-G编辑效率。如果某个位置不是A,表格中会写noA;如果是A,则给出该位置的编辑百分比
ABE8e summary V2.xlsx:短sgRNA实验总结和结构预测准备文件
Sheet1:每个小块对应一个实验靶点(ABE8、ABE25、HPE6等),每个靶点下面按A位点列出编辑效率,横向分成不同sgRNA长度(每个长度通常有3个重复值,ABE8e 20nt、ABE8e 18nt/19nt、ABE8e 16nt/17nt、ABE8e 14nt/15nt),表示某个靶点 在不同sgRNA长度下 各个A位置的ABE8e编辑效率Cas9:Cas9蛋白序列,给AF3或其它结构预测准备蛋白输入Cas9蛋白序列+sgRNA序列+DNA双链序列→AF3预测Cas9-sgRNA-DNA复合物→提取R-loop distance)
sgRNA DNA:每个靶点在不同长度下的spacer/sgRNA序列,以及对应的DNA双链序列,- spacer行是短sgRNA的靶向序列
- sgRNA行是在spacer后面接上scaffold后的完整sgRNA序列
- DNA1和DNA2是用于AF3输入的双链DNA序列
也是用于构建AF3输入
短sgRNA真实编辑窗口+提供AF3结构预测所需Cas9/sgRNA/DNA输入→后续整理distance→验证distance模型能否反映短sgRNA窗口收缩
总体编辑效率、位置编辑效率和outcome:假设某条20nt序列在编辑窗口内只有A5和A7两个A,实验可能观察到4种结果
| outcome | 含义 | 频率示例 |
|---|---|---|
| A5、A7都未编辑 | 未编辑序列 | 40% |
| 只编辑A5 | A5→G | 20% |
| 只编辑A7 | A7→G | 10% |
| A5和A7同时编辑 | A5、A7→G | 30% |
- 总体编辑效率=20%+10%+30%=60%
- A5位置效率=20%+30%=50%
- A7位置效率=10%+30%=40%
具体到模型的输入输出:
pred_eff:至少发生一次编辑的概率,即总体编辑效率pred_freq:某一种具体组合outcome的频率A5_efficiency:所有包含A5→G的outcome频率之和- 原模型输出的是
pred_eff+多个pred_freq,需要把多个outcome重新汇总成位置3–10的边际编辑效率
我们现在有的标签:某个target × 某种sgRNA长度 × 某个A位置 → 该位置的A-to-G效率,所以新模型最自然的输出是position_efficiency_mean
baseline
bash scripts/run_abe8e_baseline.sh
准备baseline输入:
- CRISPRon-ABE使用的目标DNA:
4nt上游+20nt protospacer+3nt PAM+3nt下游 - 其中
30mer第5–24位=20nt protospacer,第25–27位=PAM
| 项目 | 数量 |
|---|---|
| 原始记录 | 11,402 |
| 非NGG PAM排除 | 10,239 |
| 编辑窗口3–10位无A排除 | 58 |
| PAM无效排除 | 13 |
| 最终保留 | 1,092 |
| 唯一30mer | 1,091 |
总体编辑效率预测结果:

- 横轴为真实总体编辑效率,纵轴为原模型预测总体效率,虚线表示理想情况
预测值=真实值
| 指标 | 数值 | 含义 |
|---|---|---|
| 样本数 | 1,092 | - |
| Pearson | 0.728 | 衡量预测值和真实值之间的线性关系 |
| Spearman | 0.795 | 衡量排序关系 |
| MAE(平均绝对误差) | 5.26 | 每条记录预测误差绝对值的平均值 |
| RMSE(均方根误差) | 9.88 | 对大误差给予更高惩罚 RMSE为9.88,明显高于MAE,说明大部分点比较准确,但存在少数误差很大的离群点 |
- 图中间和右上方的大部分点靠近虚线,说明中高效率位点预测较好;但真实效率接近0的部分点,模型仍给出40%–70%的预测,说明原模型存在向数据平均值收缩的现象
- Kissling ABE8e训练数据本身主要集中在60%–80%高效率区域,因此模型不擅长输出极低值是可以理解的
- 需要注意的是,这批数据与CRISPRon-ABE训练使用的Kissling ABE8e数据存在重合,不是严格的独立外部测试结果
编辑窗口预测结果:全部位置合并相关性、各位置内部相关性、平均编辑窗口曲线三类结果都没有异常

- 横轴为protospacer位置3–10,纵轴为该位置所有可编辑A的平均效率
| 指标 | 数值 |
|---|---|
| 可编辑A位点数 | 2,687 |
| Pearson | 0.893 |
| Spearman | 0.872 |
| MAE | 6.98 |
| RMSE | 11.15 |
| 位置 | n | 真实均值 | 预测均值 | 差值 |
|---|---|---|---|---|
| A3 | 317 | 46.68 | 46.43 | −0.25 |
| A4 | 335 | 61.69 | 60.53 | −1.16 |
| A5 | 345 | 62.21 | 62.15 | −0.07 |
| A6 | 389 | 63.82 | 63.69 | −0.13 |
| A7 | 330 | 62.18 | 62.12 | −0.06 |
| A8 | 339 | 52.69 | 53.83 | +1.14 |
| A9 | 352 | 36.92 | 37.62 | +0.70 |
| A10 | 280 | 20.42 | 20.42 | +0.00 |
| 位置 | Pearson | Spearman | MAE |
|---|---|---|---|
| A3 | 0.864 | 0.862 | 8.78 |
| A4 | 0.738 | 0.758 | 6.99 |
| A5 | 0.741 | 0.779 | 6.80 |
| A6 | 0.740 | 0.780 | 6.28 |
| A7 | 0.745 | 0.775 | 6.51 |
| A8 | 0.883 | 0.890 | 6.91 |
| A9 | 0.921 | 0.906 | 6.92 |
| A10 | 0.880 | 0.819 | 6.88 |
- 说明原模型正确恢复了ABE8e的平均位置偏好
数据准备
原模型数据存在./crispron-BE/data_for_model_development_V1.0/中:Supplementary_Data_1.xlsx
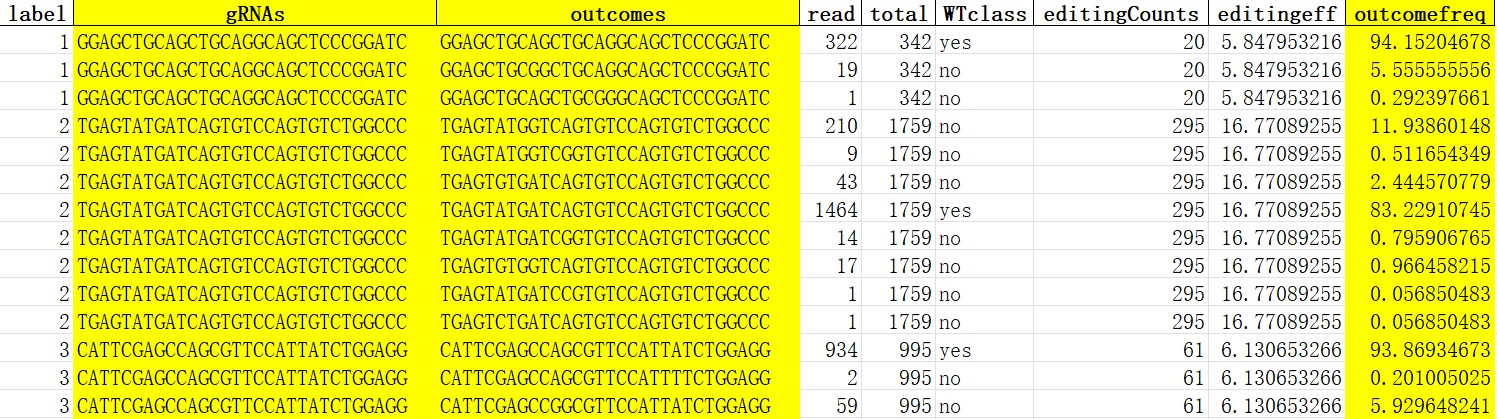
把ABE8e summary V2.xlsx整理成标准长表:预览 | 下载
target_length.tsv:每个target×sgRNA长度一行position_long_all.tsv:保留所有实验位置,包括负位置、A11、A12等position_long_pos3_10.tsv:仅保留原CRISPRon-ABE编辑窗口3–10位(后续第一版模型使用这个文件)
python scripts/prepare_abe8e_short_dataset.py \
    --xlsx "data/ABE8e summary V2.xlsx" \
    --outdir data/ABE8e_short_sgRNA
| 项目 | 结果 |
|---|---|
| target数量 | 12 |
| target×长度条件 | 48(12个target×4组长度) |
| 全部位置记录 | 424 |
| 位置3–10记录 | 208 |
| 缺失重复值 | 0 |
| 重复记录 | 0 |
| 非NGG条件 | 0 |
-
长度不一致记录:
ABE25 18nt:序列19nt,开头有小写g
ABE25 14nt:序列15nt,开头有小写a
PT14 20nt:序列21nt,开头有小写g
PT13 20nt:序列21nt,开头有小写g
S16 15nt:序列实际14nt
S12 15nt:序列实际14nt
去掉开头的小写碱基后,所有序列都能正确匹配对应20nt protospacer的PAM近端后缀(小写g/a很可能是额外添加的5′端碱基,不属于主要的target-complementary spacer)。S16和S12标为15nt,但实际只有14nt,而且没有额外小写碱基,不过暂时不使用短的,所以不会影响
- ABE8的A2不一致:ABE8的20mer为
GTAAACAAAGCATAGACTGA,第2位是T,但原始实验表标为A2,不过A2不在将使用的3–10位窗口内 -
三组平均位置编辑效率分别为:
20nt:76.18%
18/19nt:59.49%
16/17nt:34.41%
随着sgRNA缩短,编辑效率明显下降,说明当前数据提取符合实验的整体变化趋势
生成标准化建模表和distance模板:
- 统一处理小写5′附加碱基和target-matching spacer
-
生成后续填写R-loop distance的标准模板
有些sgRNA序列开头带额外小写g或a,例如
g+18nt真正互补序列,这个额外碱基可能用于转录启动或实验构建,但不与目标DNA互补。因此我们同时保存了raw_spacer_dna、extra_5p_dna、target_matching_spacer_dna、target_matching_length,模型中的“长度”采用真正与target互补的长度(20nt、18nt、16nt)
python scripts/prepare_abe8e_distance_inputs.py \
    --target-length \
    data/ABE8e_short_sgRNA/abe8e_short_target_length.tsv \
    --position \
    data/ABE8e_short_sgRNA/abe8e_short_position_long_pos3_10.tsv \
    --outdir \
    data/ABE8e_short_sgRNA/distance_input
| 检查项 | 结果 |
|---|---|
| target数量 | 12 |
| 全部target×长度条件 | 48 |
| 第一轮20/18/16组条件 | 36 |
| 第一轮位置级记录 | 156 |
| 每组位置记录 | 52(三组完全一致) |
| 缺失重复值 | 0 |
| 非A位置 | 0 |
| 非NGG PAM | 0 |
| 30mer长度错误 | 0 |
| DNA双链不互补 | 0 |
重复af3_id |
0 |
| 未解决长度条件 | 2(仅位于未使用的14/15nt组) |
- 三种长度使用同样的12个target和同样的A位置,因此组间差异不是因为“20nt组恰好测了更多容易编辑的位置”,而更可能来自sgRNA长度变化,提高了长度比较的可解释性
- 每条位置记录有
rep1-rep3,我们保存position_efficiency_mean和position_efficiency_sd,训练时目前用平均值作为标签,SD用于判断实验不确定性
使用AlphaFold网页版进行距离预测:上传的json文件 | 预测结果
-
输入:Cas9蛋白、完整sgRNA=spacer+scaffold、DNA1、DNA2
20nt、18nt、16nt任务中,Cas9、DNA双链和scaffold相同,只改变sgRNA与DNA互补的spacer长度
-
distance:互补DNA碱基之间
C1′原子到C1′原子的欧氏距离使用C1′的优点是每种DNA碱基都有该原子,并且可以较稳定地表示两条DNA糖环之间的间隔
- 约10–11Å:两条DNA仍接近正常双链配对状态
- 20Å以上:两条DNA明显分离
- 30–40Å:R-loop区域高度开放
(这里的20Å只是解释结构时的经验参考,不是已经通过实验确定的真实阈值)
-
最后对AF给出的5个可能模型的distance求均值和SD,作为新模型的输入
python scripts/prepare_all_abe8e_af3_server_jobs.py \
    --xlsx "data/ABE8e summary V2.xlsx" \
    --manifest \
    data/ABE8e_short_sgRNA/distance_input/abe8e_af3_manifest_first_round.tsv \
    --outdir \
    data/ABE8e_short_sgRNA/af3_all_jobs \
    --batch-size 6 \
    --exclude-af3-ids \
    ABE8_L20,ABE8_L18_19,ABE8_L16_17
以ABE8这个target为例:因为distance方差较大,所以又对16nt重新运行了两次以判断是不是AF的问题
-
15条distance曲线:

图中每一条线代表一次AF3候选结构中的位置3–10距离
- 位置3–7大多数模型约10Å,比较闭合
- 位置8–10开始分叉
- 部分模型在位置8后迅速打开
- 部分模型到位置10仍接近闭合
- 还有少数模型在位置5–7出现异常中间状态,说明AF3对16nt条件下R-loop边界没有给出唯一答案
- 但这不是说“AF3预测失败”,因为:
- 模型整体ipTM约0.78–0.84
- 链和碱基映射正确
- 不同预测轮次反复出现相似的开放型和闭合型构象
-
结论:16nt条件下,R-loop远端区域的相对构象不确定性高于20nt和18nt。这并不是由AF运行错误导致的,所以后续都使用运行一次、产生5个模型取均值的方法
但不能进一步直接断言真实分子一定在这些状态之间动态转换,因为AF3候选分布不等同于真实热力学构象分布
对12条target运行原始CRISPRon-ABE:获得每个target的CRISPRoff能量特征、CRISPRon活性分数、原模型总体效率预测、原模型位置3–10效率预测
- 原始CRISPRon-BE不包含sgRNA长度输入和distance,因此同一个target的20nt、18nt、16nt输出相同,只需运行12条唯一30mer
bash scripts/run_abe8e_short_original_model.sh
CRISPRparams.tsv:包含CRISPRoff相关能量(RNA_DNA_eng、RNA_DNA_eng_weighted、DNA_DNA_opening、spacer_self_fold、CRISPRoff_score)- 这里的
DNA_DNA_opening是CRISPRoff热力学模型中的双链打开能量,不是我们从AF3结构中测得的几何distance
- 这里的
crispron.csv:包含CRISPRon预测的Cas9活性分数,是说“这条20nt目标序列在标准Cas9系统中,本身是否容易被Cas9识别并发挥活性”crispronABE_prediction.tsv:包含pred_eff、每种outcome的pred_freq,再通过outcome汇总获得位置3–10预测编辑效率
合并上述结果构建新模型输入
- 样本身份:表示这行是哪一个target、哪一种长度、哪一个A位置(
record_id、target_id、length_group_id、reported_position) - 实验标签:真实实验结果(
rep1、rep2、rep3、position_efficiency_mean、position_efficiency_sd) - 序列信息:表示目标序列、PAM和sgRNA(
target_20mer、target_23mer、target_30mer、PAM、full_sgRNA_rna) - 长度信息:明确20nt、18nt、16nt条件(
target_matching_length、sgRNA_length_numeric、length_group_id) - 结构特征
distance_pos3–10:整条8维结构曲线distance_at_position:当前这行对应A位置的局部distancedistance_sd:AF3候选模型间不确定性
- 原模型特征和预测:CRISPRoff_score、CRISPRon_score、original_pred_total_eff、original_pred_position_efficiency
python scripts/extract_all_abe8e_target_distances.py \
    --manifest \
    data/ABE8e_short_sgRNA/distance_input/abe8e_af3_manifest_first_round.tsv \
    --zip-dir \
    data/ABE8e_short_sgRNA/af3_target_zips/primary \
    --outdir \
    data/ABE8e_short_sgRNA/af3_target_distance
abe8e_short_complete_model_table.tsv:后续训练直接使用abe8e_short_original_baseline_metrics.tsv:分别给出all_lengths、L20、L18_19、L16_17对应的Pearson、Spearman、MAE和RMSE
| 长度 | Pearson | Spearman | MAE | 真实均值 | 预测均值 |
|---|---|---|---|---|---|
| 全部长度 | 0.512 | 0.523 | 24.01 | 56.69% | 45.40% |
| 20nt | 0.787 | 0.862 | 31.35 | 76.18% | 45.40% |
| 18nt | 0.707 | 0.723 | 18.74 | 59.49% | 45.40% |
| 16nt | 0.378 | 0.358 | 21.95 | 34.41% | 45.40% |
可以看到,同一个target、同一个位置在3种长度下的原模型预测完全相同,最大差值为0:因为原模型输入只有30nt目标序列、编辑位置、CRISPRoff、CRISPRon和dataset信息,并没有sgRNA长度或R-loop distance
- 20nt:明显低估,平均低估30.77
- 18nt:平均低估14.08
- 16nt:平均高估11.00
先做一个小规模、按target分组的机器学习检查,确认distance是否提供可用信号:比较4组结果
- 使用了带标准化和L2正则化的Ridge回归,并采用按target留一交叉验证(每次把1个完整target作为测试集、另外11个target训练、重复12次)
- original_crispron:原CRISPRon-ABE直接给出的预测
- base:输入不包含长度
- 30mer one-hot:30×4=120个特征
- 位置3–10 one-hot:8个特征
- CRISPRoff:1个
- CRISPRon:1个
- length:base+sgRNA长度,即20、18、16
- distance:base+8维distance(3-10位置的distance)+当前位点distance
python scripts/replace_group_with_target_specific_distances.py \
    --complete-table \
    data/ABE8e_short_sgRNA/complete_model_input/abe8e_short_complete_model_table.tsv \
    --distance-table \
    data/ABE8e_short_sgRNA/af3_target_distance/abe8e_target_specific_distance_table.tsv \
    --outdir \
    data/ABE8e_short_sgRNA/complete_model_input_target_distance
结果图:每个点是该长度下、该位置所有可用target的平均效率,不是某一条sgRNA的单独窗口,而且各位置样本数不同

- 原模型在pos3–10几乎全部低估,说明原模型与当前短sgRNA实验数据的绝对效率尺度不一致
- length模型在20nt中整体表现最好,但pos3–4低估、pos8–10高估,pos4–6比length低估更多
- distance模型pos3比length更接近真实值,pos8–10的高估程度小于length

- 原模型pos3–4相对接近,pos5–8明显低估,pos9–10严重低估
- length模型能较好表现出pos3–7逐渐升高、os8–10下降,但对真实的pos6–7峰值估计不足、pos10又偏高
- distance模型在窗口中部表现较好,但pos4高估、pos10高估

- 与20nt相比,整体效率明显下降、编辑窗口变窄、高效率平台消失、pos3–4受到明显抑制,这与16nt条件下R-loop缩短、PAM远端开放程度下降的结构预期一致
- 原模型无法感知长度变化,仍然输出与20nt相同的窗口形状
- length模型明显改善了整体尺度,但它在pos4–6仍然高估
- distance模型更接近真实值,但在部分位置还有高估低估的情况
模型平均参数(20/18/16nt混合):
| 模型 | Pearson | Spearman | MAE | RMSE |
|---|---|---|---|---|
| 原CRISPRon-ABE | 0.512 | 0.523 | 24.01 | 28.29 |
| base | 0.267 | 0.305 | 24.04 | 28.81 |
| length | 0.621 | 0.667 | 18.69 | 23.41 |
| distance | 0.634 | 0.668 | 18.73 | 23.12 |
按20/18/16nt统计模型MAE:
| 模型 | 20nt MAE | 18nt MAE | 16nt MAE |
|---|---|---|---|
| length | 13.69 | 19.95 | 22.42 |
| distance | 15.22 | 20.51 | 20.44 |
- base模型只用12个target来训练,且同一输入对应多个效率(没有distance作区分),所以准确度很低
- 加入长度或distance后,整体性能明显优于没有长度信息的模型
- distance模型与length模型整体性能非常接近;distance在相关性和RMSE上略好,length在MAE上略好
- 20nt时length模型更好,18nt时length模型略好,16nt时distance模型明显更好
- distance最主要的价值出现在16nt短sgRNA条件下
具体到target层面:
-
MAE改善最明显的target为:
target length MAE distance MAE 改善 ABS4 15.96 9.95 6.01 HPE6 15.15 11.67 3.47 PT13 25.03 21.85 3.18 - distance与length接近的包括:sgANGPTL3-A6、S7、CS1P、S16
-
distance明显变差的主要是:
target length MAE distance MAE 变化 S12 20.03 25.52 变差5.49 S18 26.33 28.62 变差2.29 PT14 21.60 22.57 变差0.97 - 总体上,distance对5/12个target有改善,对7/12个target没有改善。这说明目前的结构特征存在真实的target-specific信号,但其稳定性还不足
总结:
- 原CRISPRon-ABE流程已经正确跑通
- 原模型能恢复标准ABE8e的平均编辑窗口
- 短sgRNA实验显示20nt→18nt→16nt时,位置编辑效率整体下降
- AF3预测显示sgRNA缩短时,R-loop远端区域开放程度下降
- 加入length或distance后,简单模型能够更好地区分20nt、18nt和16nt
- distance模型的整体结果略优于length模型,主要优势集中在16nt sgRNA条件,值得继续进入神经网络阶段
- 还不能证明AF3候选构象代表真实分子的动态构象比例
- 还没有直接预测bystander减少或脱靶降低
- 只有12个target,样本量很小,且16nt组AF结果不确定性较高;每个位置的target数量不一致,例如pos10只有3个target
新模型构建
plan
最关键问题:目前真正带有真实短sgRNA效率+target-specific AF3 distance的数据只有12个target×20/18/16nt×位置3–10中的可编辑A=156条position-level记录。但是原CRISPRon-ABE的训练规模完全不是这个量级,论文整合后的ABE模型涉及17,941条gRNA,而且原模型还是30nt CNN+多输入+双输出架构
- 如果直接把原模型所有参数重新随机初始化,只拿156条记录训练,CNN要重新学习sequence/position规律以及distance规律,几乎一定严重过拟合
GPT首先推荐了一个方案:基于预训练结果的adapter
- 假设原CRISPRon-ABE对某个target的A6预测:
序列+编辑位置+CRISPRoff+CRISPRon+dataset→A6预测效率=50% -
现在我们知道
20nt时distance=35Å
18nt时distance=25Å
16nt时distance=13Å
真实实验值是
20nt:A6=75%
18nt:A6=60%
16nt:A6=30%
原模型不知道sgRNA长度,所以不管20/18/16nt,它永远还是输出50%
-
adapter的做法不是修改原模型,而是
  原CRISPRon-ABE
        ↓
      50%
        │
        ├──────────────┐
        │              │
sgRNA长度         R-loop distance
        │              │
        └──────┬───────┘
              ↓
          adapter网络
              ↓
        学习一个修正值
例如它可能学出来
20nt:correction=+23 18nt:correction=+8 16nt:correction=-18即:ynew = yCRISPRon + f(distance,length,position)
20nt:50+23=73%
18nt:50+8=58%
16nt:50-18=32%
这里真正训练的只有后面的
f()
之后问了GPT这种方法是否是前述的“真正修改模型”,又给出了一版新的方案:真正改结构,但冻结原模型
-
真的把distance加入CRISPRon-BE,同时不要求156条数据重新训练整个CRISPRon-BE
原CRISPRon-ABE ┌─────────────────────────────┐ 30mer ───→│ CNN │ outcome ─→│ │ energy ──→│ 原有hidden representation │ CRISPRon →│ │ dataset ─→│ │ └──────────────┬──────────────┘ │ pretrained hidden │ ├───────────┐ │ │ │ distance_pos3-10 │ ↓ │ Dense层 │ │ └─────concat┘ ↓ 新prediction head - 关键区别在于我们使用的不是“原模型最终预测结果”,而是原模型内部已经学好的hidden features
-
第一阶段:冻结CRISPRon-ABE原有参数,只训练distance branch+最后prediction head
如果效果正常,再尝试解冻最后1–2个Dense层进行fine-tuning
-
cross-attention:相当于把新输入融合进前面的参数,比如探究“sequence第6位应该重点看distance第几位”、“sequence不同碱基和R-loop不同位置之间有没有特异性交互”
理论上更漂亮,但现在数据的distance只有8个值、target只有12个,现在上attention基本没有必要
总结来说,GPT给出的最终方案是:保留CRISPRon-ABE的预训练backbone,把distance真正作为第6类输入加入网络;第一版冻结原有backbone,只训练新增distance branch和输出层
                   ┌─ sequence CNN(原权重)
                   │
                   ├─ outcome/position
                   │
CRISPRon-ABE ──────┼─ CRISPRoff
                   │
                   ├─ CRISPRon
                   │
                   └─ dataset
                           │
                    原hidden layer
                           │
                           ├──── distance branch ← 新增
                           │
                           ↓
                      fusion Dense
                           ↓
                 position efficiency
如果这个版本有效,再考虑解冻最后Dense层→小学习率fine-tuning→比较是否进一步改善
查看了25个ABE模型的网络结构(它们都采用同一架构):
30nt one-hot
├─Conv3:240 filters
├─Conv5:140 filters
└─Conv7:80 filters
      ↓
Flatten并拼接:6140维
      ↓
Dense1:900维
      ↓
+ outcome/position:8维
+ CRISPRoff:1维
+ CRISPRon:1维
+ dataset:5维
      ↓
共915维
      ↓
Dense2:900维
      ↓
Dense3:200维
      ↓
Output:2维
- 总参数量为6,540,282,其中仅Dense1就有5,526,900个参数
- 现有数据是肯定是没办法从头训练整个网络的,时间上也不允许
一些专业名词补充:
- encoder:在我们这个项目里,把
30mer → Conv3/5/7 → Flatten → Dense1 → 900维表示整体称作sequence encoder,因为它做的是原始DNA序列 → 机器学习能够使用的高级特征 -
backbone:原模型中已经训练好的主体网络
pretrained backbone≈原CRISPRon-ABE中我们想保留的已有神经网络
- pretrained model:已经在大数据上训练完成的模型,比如
CRISPRonBE_models/ABE/model_1_1,我们想读取里面已经学好的Conv1 weights、Conv2 weights、Conv3 weights、Dense1 weights、Dense2 weights、Dense3 weights,这些参数来源于原作者的大规模ABE训练数据 - transfer learning:迁移学习,
原作者的大数据 → 已经训练出的CRISPRon-ABE → 保留已有知识 → 用我们的数据适应新任务 - 冻结参数:神经网络学习实际上就是不断修改内部的weights。例如Dense1有
6140×900+900=5,526,900个参数,如果在python中设置layer.trainable = False,就是告诉TensorFlow训练的时候这一层可以正常参与计算,但不要修改它已经学好的参数 -
prediction head:整个网络可以粗略拆成
输入 → 特征提取部分 → prediction head → 最终预测值,其中前半部分负责“理解输入是什么”,后半部分负责“把这种理解转换成我们真正想预测的数值”。在这个模型中最后的一段Dense3的200维内部表示 → Output → 2个最终预测值就可以理解为原模型最末端的prediction headbackbone负责把很多复杂输入转成“模型理解后的特征”,head则负责回答一个具体任务。例如同样一个DNA特征表示,理论上可以接不同的head,比如
编辑效率head→效率%、是否高效head→0/1、位置效率head→A6效率%- 原模型最终回答的是
gRNA总体editing efficiency+当前这个outcome的frequency,而不是直接预测某个单独A位置的边际效率,但我的短sgRNA实验数据给的却是某个A位置的编辑效率,所以我们真正需要的模型输出变成了某个位置的position efficiency -
所以我们现在要做的是“换head”,保留Conv和Dense,只把最后
Dense3(200) → Output(2)改成Dense3(200) → PositionOutput(1)例如原模型中的
[0,0,1,0,1,0,0,0]表示一个outcome中A5和A7同时发生了编辑,我们现在把它改成预测A3[1,0,0,0,0,0,0,0]+预测A4[0,1,0,0,0,0,0,0]+预测A5[0,0,1,0,0,0,0,0] - 在实际代码中,可以用原output的
outcome frequency来初始化新head。因为outcome frequency和“位置是否被编辑”虽然不是同一个量,但显然有一定关系,所以我们不是让新的PositionOutput从完全随机状态开始,而是先把它初始化成“原模型判断编辑outcome概率”的那套权重,然后再用真实的position efficiency重新训练
- 原模型最终回答的是
- warm-up和fine-tuning
- warm-up:先不要碰原模型,只让新的输出层学习怎么把原模型200维内部表示转换成position efficiency
- fine-tuning(微调):在已有权重附近做小调整,使用更低的学习率
可以理解成:
- pretraining:原作者已经把模型训练好了
- warm-up:我们先装上一个新的输出头
- fine-tuning:允许模型最后几层稍微调整,以适应我们的新任务
- learning rate决定每次更新参数走多大一步
- dropout=0.1:训练时每个batch会随机暂时屏蔽大约10%的神经元,目的就是不让模型过度依赖某几个特征,从而降低过拟合。是一种正则化手段(regularization)
-
验证集选取:在这里不能随机拆分,因为同一条30mer可能有A4/A6/A8三条记录,随机的话可能会在训练集和验证集中都用了这个序列的不同记录,验证集看似“没见过A8”,但它已经知道这条target是什么了,于是验证成绩会偏高
所以这里要确保某条30mer要么所有A位置都在train,所有A位置都在validation
- early stopping:代码允许最多300 epochs,如果连续30轮不再改善则训练停止
code
主要流程:
- 第一步:把原CRISPRon-ABE迁移成position-level模型
- 第二步:在position模型内部加入R-loop distance,迁移到20/18/16nt
1. train_abe8e_position_transfer.py
- 这时原outcome输入和新position输入都是8维,这样dense2也不需要因为shape改变而重建,保留conv1/2/3和Dense1/2/3,只把原来的
Output:200→2换成PositionOutput:200→1,该步骤用大约2687条20nt真实位置效率训练
module load miniconda3/base
conda activate crispronbe
root="/public/home/GENE_proc/wth/crispron-BE"
python "${root}/scripts/train_abe8e_position_transfer.py" \
    --position-table \
    "${root}/results/ABE8e_baseline/report/abe8e_baseline_position.tsv" \
    --crisproff \
    "${root}/results/ABE8e_baseline/crispronbe_output/CRISPRparams.tsv" \
    --crispron \
    "${root}/results/ABE8e_baseline/crispronbe_output/crispron.csv" \
    --pretrained-model \
    "${root}/data/CRISPRonBE_models/ABE/model_1_1" \
    --outdir \
    "${root}/results/ABE8e_transfer_model/position_model_1_1"
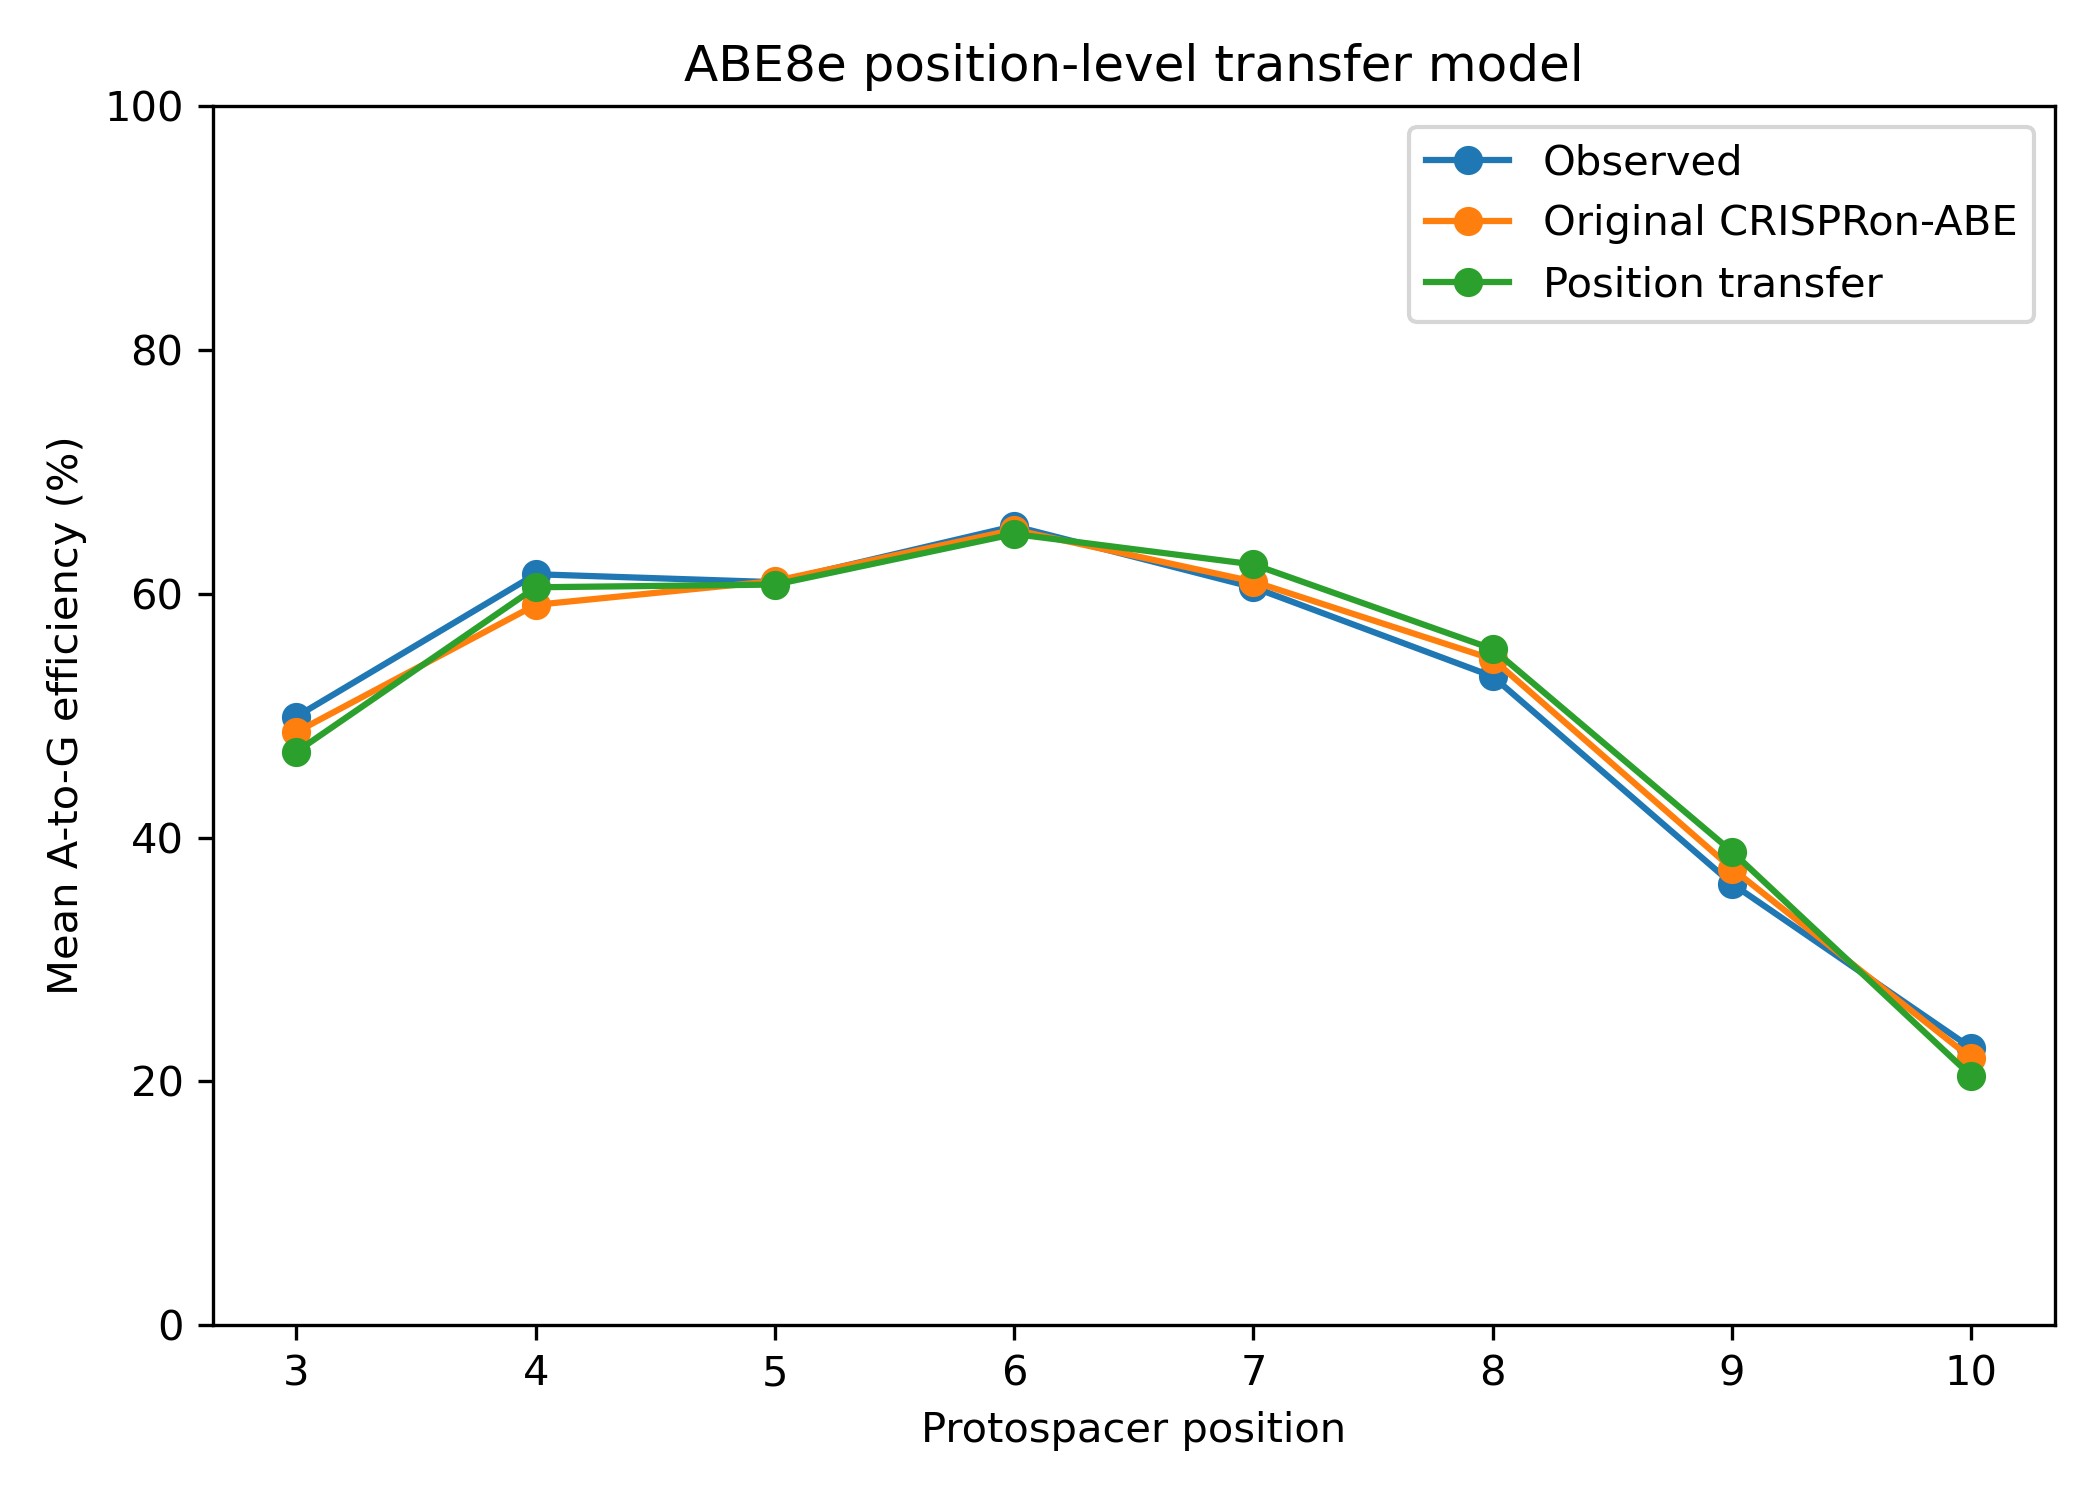
- 虽然Observed、Original CRISPRon-ABE、Position transfer这三条线几乎重合,但是逐样本指标
                      Pearson   Spearman   MAE
Original CRISPRon        0.889      0.869   6.90
Position transfer        0.869      0.811   8.38
表明实际上模型性能下降了
平均编辑窗口吻合,不代表每条sgRNA的每个位置预测准确,因为平均曲线会抵消误差,例如真实效率是20,80,预测是40,60,平均值都是50,但两个样本都错了20
- 可能原因:
- fine-tuning过头了:第一版先只训练新Output,随后又解冻了Dense2(824,400参数)/Dense3(180,200参数)/PositionOutput(201参数),加起来大约1,004,801个可训练参数,而训练记录只有约2000条,是不是小数据把原模型已经学好的Dense2/Dense3破坏了?
- 任务语义本身变了:原来的
[0,0,1,0,0,0,0,0]在CRISPRon-ABE中表示“只有A5发生编辑”的outcome,而我们重新解释成“请预测A5的边际编辑效率”,但实际上A5边际效率=P(A5)+P(A5+A6)+P(A5+A7)+P(A5+A6+A7)+...,是不是Dense2/Dense3已经学的是outcome语义,不能简单把outcome向量改名叫position向量
2. Head-only vs Dense2/3 fine-tune
python "${root}/scripts/train_abe8e_position_transfer_diagnostic.py" \
    --position-table \
    "${root}/results/ABE8e_baseline/report/abe8e_baseline_position.tsv" \
    --crisproff \
    "${root}/results/ABE8e_baseline/crispronbe_output/CRISPRparams.tsv" \
    --crispron \
    "${root}/results/ABE8e_baseline/crispronbe_output/crispron.csv" \
    --pretrained-model \
    "${root}/data/CRISPRonBE_models/ABE/model_1_1" \
    --outdir \
    "${root}/results/ABE8e_transfer_model/position_model_diagnostic"
-
Head-only:冻结conv1/2/3和Dense1/2/3,只训练PositionOutput(只有201个参数),如果这个模型很好,就说明原网络已经提供了足够好的representation,之前只是fine-tuning破坏了它
Pearson≈0.727
Spearman≈0.722
MAE≈12.19
明显很差,而且loss曲线表现为train和validation都持续下降,但到150 epoch仍然不够低,更像是模型容量不足/欠拟合
只在原来的200维outcome-specific hidden representation后接一个线性输出,并不能完成position efficiency任务
-
Dense2/3 fine-tune
Pearson≈0.869
Spearman≈0.811
MAE≈8.38
比head-only的12.19强很多,所以Dense2和Dense3确实包含很多有用的信息。但loss曲线非常典型——train MAE不断下降到约6.3,validation MAE下降到约8.5后基本停住,也就是train继续变好、validation不再变好,这是明显的过拟合趋势
Head-only模型自由度太少 → 欠拟合;Dense2/3全部解冻 模型自由度太大 → 有过拟合
-
不用outcome-specific Dense2/Dense3,只保留真正学习DNA序列的encoder,再接一个中等大小的新head
3. train_abe8e_encoder_position.py
- 保留
30mer → Conv1/2/3 → Flatten → Dense1:900,因为在原CRISPRon-ABE中,到Dense1为止只接触DNA序列,还没有接触outcome,因此我们把这部分定义成pretrained sequence encoder,它负责从30nt序列中提取与ABE活性相关的序列特征 - 完全舍弃原Dense2+原Dense3+原Output,重新建立:
Dense1 sequence feature:900
+
position:8
+
CRISPRoff:1
+
CRISPRon:1
+
dataset:5
↓
915
↓
Dense64
↓
Dense16
↓
PositionOutput
只有约6万个参数,设计逻辑是:
201参数 →太少 ≈60,000参数 →尝试中间规模 1,000,000参数 →太多 - 探究“只利用原模型的sequence知识,再重新学习position任务”,能不能解决前面的语义冲突
python "${root}/scripts/train_abe8e_encoder_position.py" \
    --position-table \
    "${root}/results/ABE8e_baseline/report/abe8e_baseline_position.tsv" \
    --crisproff \
    "${root}/results/ABE8e_baseline/crispronbe_output/CRISPRparams.tsv" \
    --crispron \
    "${root}/results/ABE8e_baseline/crispronbe_output/crispron.csv" \
    --pretrained-model \
    "${root}/data/CRISPRonBE_models/ABE/model_1_1" \
    --outdir \
    "${root}/results/ABE8e_transfer_model/encoder_position_model_1_1"
                      Pearson   Spearman    MAE
Original CRISPRon        0.889      0.869    6.90
Dense2/3 fine-tune       0.869      0.811    8.38
Encoder+new head         0.786      0.735   11.14
Head only                0.727      0.722   12.19
- 而且encoder_position在A3–A10每一个位置的MAE都比原模型高
- 问题并不只是head大小。真正的问题是我们把原来的outcome预测问题改造成position直接回归问题以后,丢失了CRISPRon-ABE原本非常有价值的outcome-level知识
- 原模型不是直接
30mer → A5 efficiency,而是先枚举一个target所有可能的编辑组合分别进行预测,模型给每个outcome分别的pred_eff和pred_freq,然后把负的pred_freq截成0,并计算同一target的总体pred_eff,把所有pred_freq重新归一化,使其总和等于pred_eff,最终再把相关outcome求和得到position efficiency
4. train_abe8e_internal_structure_transfer.py
- 不再把CRISPRon-ABE改造成另一个任务,而是完整保留原模型“预测总体编辑效率+outcome频率”的逻辑,只在原模型内部加入一个新的length/distance分支,再利用我们已有的短sgRNA位置编辑效率去训练这个新分支
- 理论上最直观的做法:
Dense1             900
outcome              8
CRISPRoff            1
CRISPRon             1
dataset               5
distance              8
──────────────────────
                    923
↓
Dense2
原来的Dense2权重shape是
(915,900),如果直接改成923维,新的Dense2应该是(923,900),shape不一样,所以原来的Dense2权重不能直接set_weights到新的Dense2:原915维 ↓ 原Dense2线性变换 \ + → ReLU → 原Dense3 → 原Output / distance ↓ 新增线性变换 - preactivation:假设一个神经元是
y=ReLU(Wx+b),则Wx+b就是preactivation(激活前的值),ReLU(Wx+b)才是神经元真正的输出,所以把distance加入的位置是Wx+b(在ReLU之前加入distance的影响),而不是模型已经输出最终editing efficiency后再加一个distance修正-
W:权重矩阵(weight/kernel),决定每一个输入特征对每一个神经元影响多大例如distance有8维,Dense2有900个神经元,所以distance模型的W_distance的shape为
8×900=7200个weight -
b:偏置(bias),900个Dense2神经元就有900个bias,因此distance分支总参数7200+900=8100
-
-
distance分支一开始要全部为0(Wdistance=0 bdistance=0):我们希望训练开始时
新模型=原模型,然后只有数据真的支持distance效应时,distance分支才逐渐产生非零权重,而不是加了distance后整个Dense2随机初始化,导致原来已经学好的模型直接被破坏Zero-extra equivalence check就是检测
extra输入=0时我们重新构造的新模型和原模型pred_eff/pred_freq的最大差异,程序要求<1e-4,如果通过,就说明没有distance时,我们的新网络在数学上确实恢复了原CRISPRon-ABE -
我们实际训练了三个版本:
模型 额外输入 目的 calibration_internal0 实验体系校准 length_internalsgRNA长度16/18/20 长度对照 distance_internal8维R-loop distance 结构模型 因为我们的短sgRNA数据和CRISPRon-ABE训练数据不完全是同一个实验体系,所以如果重新训练以后模型变好了,有两种完全不同的可能:
- 可能A:只是模型适应了我们这批实验的总体效率
- 可能B:模型真的利用了sgRNA长度/distance
calibration_internal就是专门排除可能A的
8维R-loop distance提供的信息不只是sgRNA长度,还包括在这一个特定target、这一个特定sgRNA长度下,R-loop从哪个位置开始明显打开、每个位置的DNA双链分离程度是多少,这就是distance相对于length真正可能提供的额外信息
-
我们的真实实验数据只有
A5 efficiency=50%/A7 efficiency=40%,所以代码先让模型产生pred_freq(A5)/pred_freq(A7)/pred_freq(A5+A7),再计算pred_A5=pred_freq(A5)+pred_freq(A5+A7)/pred_A7=pred_freq(A7)+pred_freq(A5+A7),然后和真实值40%50%比较,反向传播:position error ↓ outcome aggregation ↓ pred_freq ↓ Dense3 ↓ Dense2 ↓ distance branch由于原模型全部冻结,真正被修改的最后只有
distance branch weights - 局限:因为只知道position marginal,所以不能唯一确定真实outcome分布。但是我们的目的不是精确恢复短sgRNA的完整outcome distribution,而是预测position efficiency+预测编辑窗口,并且原CRISPRon-ABE本身已经提供了一个非常强的outcome distribution先验,我们只允许一个很小的distance branch去修正它,所以这个问题目前是可以接受的
-
训练数据划分方法:当前数据大约是
12 targets×3组长度=36个target×length conditions,共156条position labels,使用外层LOTO(Leave-One-Target-Out)的方法。例如Fold1的test是ABE8全部20/18/16数据,然后再从这剩下的11个target中拿1个作validation,剩下的10个训练10 targets → train 1 target → validation 1 target → test然后12个target轮流做test,一共12个这样的组合(fold)
每次把所有训练条件完整学习一遍叫1 epoch,最多400 epochs,但实际通常不会跑满——如果连续40 epochs都没有新的最好validation结果就停止并选最好的那个epoch
- Train真正更新模型参数,Validation选最佳epoch、判断什么时候停止训练,Test看模型对完全没参与训练决策的新target表现怎样
- 神经网络更容易训练近似中心化的变量,所以distance进行了标准化
- 结果中的模型除了上面提到的三个以外,还有:
- original_ensemble:原来的官方方式——25个模型平均
- original_model_1_1:只使用model_1_1,这个是现阶段最公平的baseline,因为calibration/length/distance目前也都是在model_1_1上改的
- 在看结果时,除了看这几个模型的MAE是不是递减,还要特别看16nt,如果MAE下降程度从16-18-20递减,就说明“R-loop在更短sgRNA条件下发生明显重排时,真实三维结构开始提供额外预测价值”
                           原CRISPRon-ABE
                     ┌──────────────────────┐
30nt sequence ──────→│ Conv1/2/3 → Dense1  │
outcome ─────────────→│                      │
CRISPRoff ───────────→│ concat → Dense2     │
CRISPRon ────────────→│          ↑           │
dataset ─────────────→│          │           │
                     │     distance branch  │
AF3 distance ────────────────→│           │
                     │          ↓           │
                     │ Dense3 → Output      │
                     └──────────┬───────────┘
                                │
                     pred_eff + pred_freq
                                │
                       outcome normalization
                                │
                ┌───────────────┴───────────────┐
                ↓                               ↓
         A5相关outcome求和                A7相关outcome求和
                ↓                               ↓
        predicted A5 efficiency        predicted A7 efficiency
                │                               │
                └───────────┬───────────────────┘
                            ↓
                   与真实位置效率比较
                            ↓
                           MAE
                            ↓
                     backpropagation
                            ↓
              只更新length/distance branch
python "${root}/scripts/train_abe8e_internal_structure_transfer.py" \
    --input \
    "${root}/data/ABE8e_short_sgRNA/complete_model_input_target_distance/abe8e_short_complete_model_table_target_distance.tsv" \
    --pretrained-model \
    "${root}/data/CRISPRonBE_models/ABE/model_1_1" \
    --outdir \
    "${root}/results/ABE8e_transfer_model/internal_structure_model_1_1"
-
总体结果:
模型 Pearson Spearman MAE RMSE original ensemble 0.512 0.523 24.01 28.29 original model_1_1 0.504 0.522 24.01 28.32 calibration internal 0.464 0.486 21.89 27.25 length internal 0.704 0.744 16.77 21.43 distance internal 0.692 0.697 18.24 22.57 - 之前的模型设计是有效的:新增信息真的已经进入CRISPRon-ABE内部,并且能显著改变短sgRNA预测
- 目前8维raw distance并没有整体超过一个简单的sgRNA length变量,distance的MAE比length高约8.8%
-
16/17nt:
模型 L16/17 Pearson MAE RMSE 平均偏差 length 0.355 19.52 23.31 +4.80 distance 0.471 19.62 23.24 +1.33 -
在最关心的最短sgRNA条件下,Pearson从0.355→0.471,整体偏高值从4.80→1.33,RMSE从23.31→23.24
虽然MAE基本没变,但distance更好地恢复了target之间的变化,而且整体尺度更准确
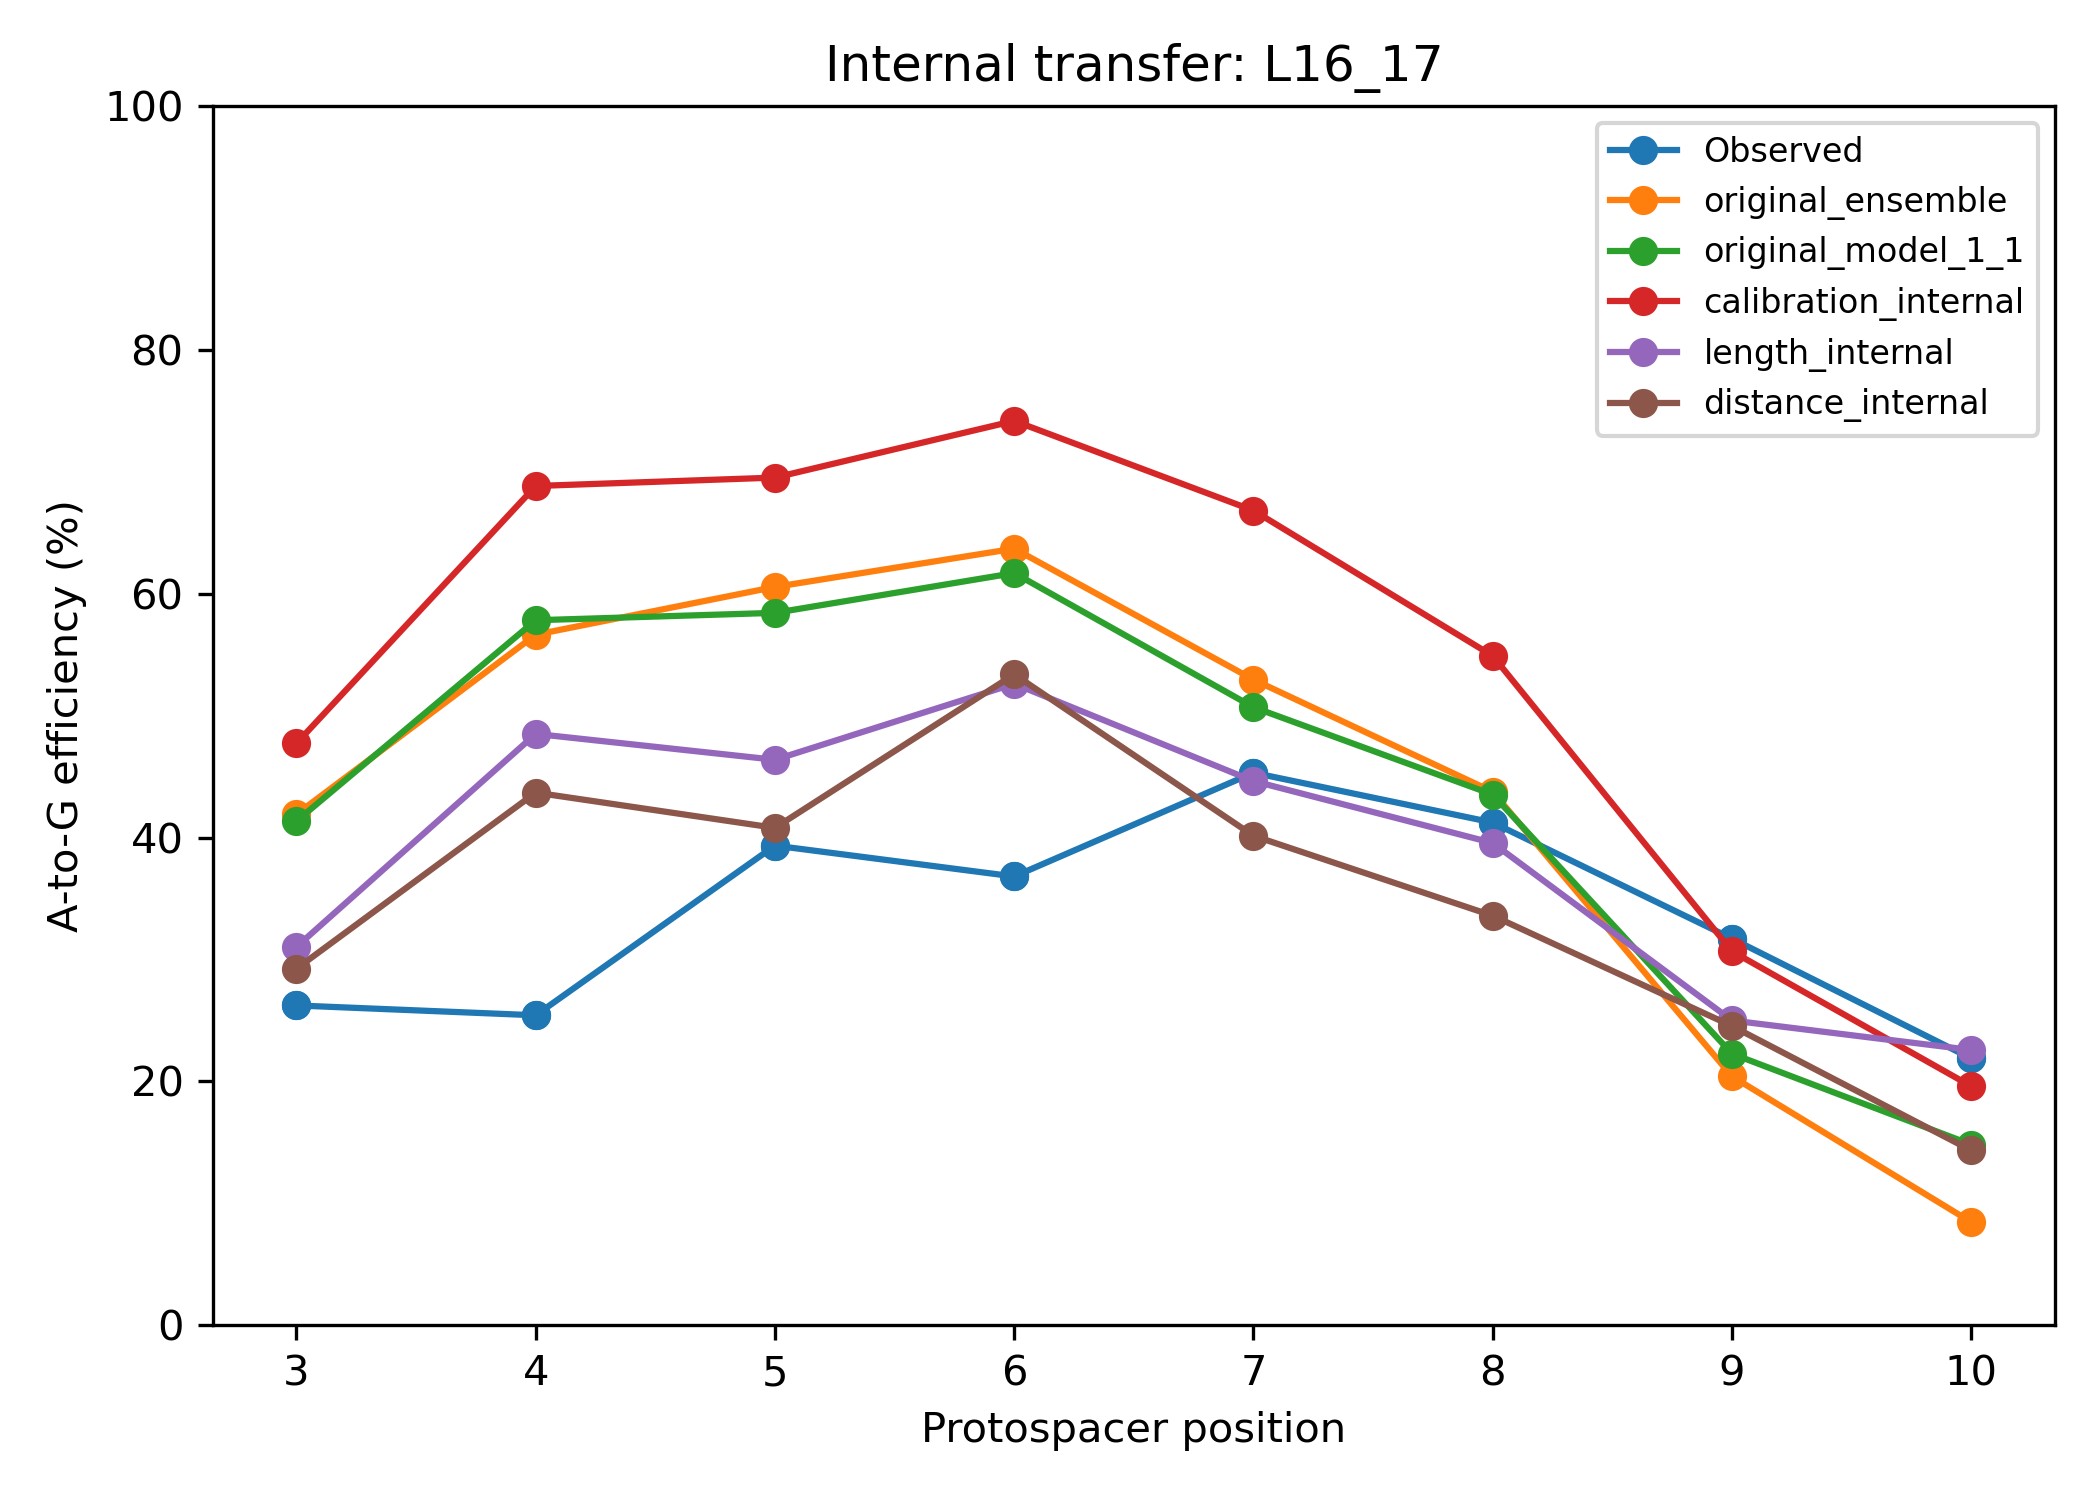
- 具体来说,length_internal在position3–6整体偏高,而distance(尤其position3–5)更接近真实窗口收缩趋势,这意味着distance确实可能在学习“短sgRNA以后R-loop不同位置开放程度变化”,而length只能告诉模型“这是16nt,所以总体应该降低”,不知道具体哪个位置受到的影响更大
-
- L18/19也出现了类似现象,但逐target误差并不稳定,所以最终MAE反而是length更好。说明当前raw distance含有有价值的信息,但同时也存在较大的target-specific噪声
- 20nt中length明确优于distance:因为我们的主要假设本来就是
sgRNA缩短→R-loop构象变化→编辑窗口改变,20nt是参考状态,raw distance模型同时需要学习不同target本身的结构差异+20→18→16造成的结构变化,而当前只有12个target,很难把两者完全拆开 - 逐target结果说明distance目前是“有时很好,但不稳定”:12个LOTO test target中,7个length最好、4个distance最好、1个calibration最好
- distance提供了target-specific结构信息,但在当前12-target数据量下,直接让8维raw distance独立承担“长度变化+结构变化”两个任务,泛化还不稳定
5. train_abe8e_length_delta_structure.py
- 已经告诉模型sgRNA长度以后,R-loop结构变化还能不能提供额外预测信息:
CRISPRon-ABE + length + distance change,因为distance本来就和sgRNA长度高度相关,所以不要求distance完全取代length - sgRNA缩短以后,这个target的R-loop相对于自己的20nt状态发生了多大改变:把raw distance改成Δdistance
- Δdistance(18nt)=distance(18nt)-distance(20nt)
- Δdistance(16nt)=distance(16nt)-distance(20nt)
- Δdistance(20nt)=0
这样还能解决当前L20中distance表现下降的问题:新模型中L20的Δdistance=0,结构分支对L20严格没有作用。也就是说L20预测=已经比较好的length_internal预测,只有18/16nt进行length prediction+结构变化修正
-
进一步限制了distance分支大小:上一版raw distance直接把
8维distance→900维Dense2,大约有7200多个结构参数,对于12个target仍然偏多;新版本改成8维Δdistance→4维structural latent factors→900维Dense2 correction,只有约8×4+4×900=3632个可训练参数4维latent factor不需要理解成4种明确的生物学结构,它只是让模型先把8个位置的distance变化压缩成少数几种整体变化模式(只是内部数学表示),例如模型可能自己形成类似“PAM远端收缩/窗口中部变化/整体开放程度下降”的判断
- 新模型从length模型原地出发:这次代码不是随机重新训练,每个fold都会读取你上一轮保存的
branch_weights/length_foldXX.npz,然后完全冻结length branch,新增Δdistance branch,并让初始输出严格为0。因此如果新模型最后在LOTO测试集变好,改善只能来自新增的结构变化分支
python "${root}/scripts/train_abe8e_length_delta_structure.py" \
    --input \
    "${root}/data/ABE8e_short_sgRNA/complete_model_input_target_distance/abe8e_short_complete_model_table_target_distance.tsv" \
    --pretrained-model \
    "${root}/data/CRISPRonBE_models/ABE/model_1_1" \
    --previous-outdir \
    "${root}/results/ABE8e_transfer_model/internal_structure_model_1_1" \
    --outdir \
    "${root}/results/ABE8e_transfer_model/length_delta_structure_model_1_1"
| 模型 | Pearson | Spearman | MAE | RMSE |
|---|---|---|---|---|
| length | 0.7038 | 0.7442 | 16.7687 | 21.4325 |
| length+Δdistance | 0.7100 | 0.7458 | 16.5782 | 21.1452 |
| 条件 | length MAE | length+Δdistance MAE | 变化 |
|---|---|---|---|
| 20nt | 14.458 | 14.458 | 完全相同 |
| 18/19nt | 16.331 | 15.699 | 改善0.632 |
| 16/17nt | 19.517 | 19.577 | 变差0.060 |
- 20nt表现符合预期,18/19nt有一定提升,但16/17nt没有提升:
length+Δdistance出现了小幅、但不够稳定的增益。它证明结构变化有补充信息,但还没有达到“可以直接宣布distance显著优于length”的程度 -
在12个fold中,有6个fold的最佳validation epoch出现在前5轮以内,其中好几个直接是
best epoch=1,意思是说对这些validation target而言,一开始几乎不改变length模型就是最佳选择,继续学习Δdistance反而使validation表现变差;而另一些fold,例如ABE8、S7,则需要几十轮才找到更好的distance修正正好符合前面看到的现象:对于某些target结构信息很有用,而对于另些target结构信息作用很弱甚至方向不稳定
- 主要瓶颈已经不是网络结构设计了,而是12个target对target-specific structural effect的支持仍然太少
目前的尝试总结:
Ridge→ distance存在信号CRISPRon-BE内部raw distance→ 能改善短sgRNA预测,但不如length稳定length + Δdistance→ 整体进一步小幅改善,尤其18/19nt改善,但16/17nt不稳定
6. summarize_abe8e_backbone_robustness.py
- 目前所有结果都来自
CRISPRon-ABE model_1_1,而官方baseline是25个模型ensemble。我们现在需要确认:当前这0.19 MAE的改善,是model_1_1偶然产生的,还是更换pretrained CRISPRon-ABE以后仍然存在 - 又选择了模型model_2_2、model_3_3、model_4_4、model_5_5,判断在5个独立pretrained backbone中,length+Δdistance是否普遍比length好
module load miniconda3/base
conda activate crispronbe
root="/public/home/GENE_proc/wth/crispron-BE"
input="${root}/data/ABE8e_short_sgRNA/complete_model_input_target_distance/abe8e_short_complete_model_table_target_distance.tsv"
result_root="${root}/results/ABE8e_transfer_model/backbone_robustness"
mkdir -p "${result_root}"
for model_name in model_2_2 model_3_3 model_4_4 model_5_5
do
    echo "Running ${model_name}"
    internal_out="${result_root}/${model_name}/internal"
    delta_out="${result_root}/${model_name}/length_delta"
    python "${root}/scripts/train_abe8e_internal_structure_transfer.py" \
        --input "${input}" \
        --pretrained-model \
        "${root}/data/CRISPRonBE_models/ABE/${model_name}" \
        --outdir "${internal_out}"
    python "${root}/scripts/train_abe8e_length_delta_structure.py" \
        --input "${input}" \
        --pretrained-model \
        "${root}/data/CRISPRonBE_models/ABE/${model_name}" \
        --previous-outdir "${internal_out}" \
        --outdir "${delta_out}"
done
python "${root}/scripts/summarize_abe8e_backbone_robustness.py" \
    --model1-dir \
    "${root}/results/ABE8e_transfer_model/length_delta_structure_model_1_1" \
    --robustness-dir \
    "${root}/results/ABE8e_transfer_model/backbone_robustness" \
    --out \
    "${root}/results/ABE8e_transfer_model/backbone_robustness_summary.tsv"
| backbone | length MAE | length+Δdistance MAE | 改善 |
|---|---|---|---|
| model_1_1 | 16.769 | 16.578 | +0.191 |
| model_2_2 | 16.651 | 16.442 | +0.209 |
| model_3_3 | 16.521 | 16.248 | +0.273 |
| model_4_4 | 15.922 | 15.885 | +0.037 |
| model_5_5 | 16.270 | 16.243 | +0.028 |
如果把5个模型的结果汇总取平均:
| 条件 | 5-model length ensemble | 5-model length+Δdistance ensemble |
|---|---|---|
| 总体MAE | 15.828 | 15.364 |
| 总体RMSE | 20.258 | 19.712 |
| 总体Pearson | 0.740 | 0.756 |
| 总体Spearman | 0.780 | 0.789 |
| 18/19nt MAE | 15.482 | 14.583 |
| 16/17nt MAE | 18.999 | 18.506 |
| 20nt MAE | 13.004 | 13.004 |
对于单个模型来说,16/17nt的distance增益不稳定,但汇总之后稳定性增加:不同backbone对结构信号的噪声有一部分会互相抵消,而真正共同存在的distance信息被保留下来
7. 运行全部25个模型,使用25个模型预测的平均值作为最终结果
- train_abe8e_internal_structure_transfer_rawout.py
- train_abe8e_length_delta_structure_rawout.py
- summarize_abe8e_25ensemble_rawfirst.py
- 在原模型中,作者先对25个模型的原始神经网络输出取平均,再normalize作为最终结果。所以这里我们也模仿这个顺序,把25个modified CRISPRon-ABE模型的raw outcome-level预测先平均,再按照官方CRISPRon-BE方法normalize,最后汇总为position efficiency
root="/public/home/GENE_proc/wth/crispron-BE"
input="${root}/data/ABE8e_short_sgRNA/complete_model_input_target_distance/abe8e_short_complete_model_table_target_distance.tsv"
internal_script="${root}/scripts/train_abe8e_internal_structure_transfer_rawout.py"
delta_script="${root}/scripts/train_abe8e_length_delta_structure_rawout.py"
summary_script="${root}/scripts/summarize_abe8e_25ensemble_rawfirst.py"
model_root="${root}/data/CRISPRonBE_models/ABE"
outroot="${root}/results/ABE8e_transfer_model/full_25_backbones"
final_out="${root}/results/ABE8e_transfer_model/final_25ensemble_rawfirst"
module load miniconda3/base
conda activate crispronbe
mkdir -p "${outroot}" "${final_out}"
echo "ABE8e 25-backbone transfer training"
for i in {1..5}
do
    for j in {1..5}
    do
        model="model_${i}_${j}"
        pretrained="${model_root}/${model}"
        model_out="${outroot}/${model}"
        internal="${model_out}/internal"
        delta="${model_out}/length_delta"
        mkdir -p "${internal}" "${delta}"
        echo "Running ${model}"
        if [[ \
            -s "${internal}/abe8e_internal_transfer_predictions.tsv" \
            && -s "${internal}/abe8e_internal_transfer_raw_outcomes.tsv" \
            && -s "${internal}/abe8e_internal_transfer_metrics.tsv" \
        ]]
        then
            echo "${model}: internal stage already finished"
        else
            echo "${model}: running internal stage"
            python "${internal_script}" \
                --input "${input}" \
                --pretrained-model "${pretrained}" \
                --outdir "${internal}" \
                2>&1 | tee "${model_out}/internal.log"
        fi
        if [[ \
            -s "${delta}/abe8e_length_delta_predictions.tsv" \
            && -s "${delta}/abe8e_length_delta_raw_outcomes.tsv" \
            && -s "${delta}/abe8e_length_delta_metrics.tsv" \
        ]]
        then
            echo "${model}: length+delta stage already finished"
        else
            echo "${model}: running length+delta stage"
            python "${delta_script}" \
                --input "${input}" \
                --pretrained-model "${pretrained}" \
                --previous-outdir "${internal}" \
                --outdir "${delta}" \
                2>&1 | tee "${model_out}/length_delta.log"
        fi
        echo "${model}: finished"
    done
done
echo "Checking completed backbones"
internal_n=$(find "${outroot}" \
    -path "*/internal/abe8e_internal_transfer_raw_outcomes.tsv" \
    -type f -size +0c | wc -l)
delta_n=$(find "${outroot}" \
    -path "*/length_delta/abe8e_length_delta_raw_outcomes.tsv" \
    -type f -size +0c | wc -l)
if [[ "${internal_n}" -ne 25 || "${delta_n}" -ne 25 ]]
then
    echo "ERROR: 25个backbone尚未全部完成。" >&2
    exit 1
fi
echo "Running official raw-outcome-first 25-model ensemble"
python "${summary_script}" \
    --root "${outroot}" \
    --outdir "${final_out}" \
    2>&1 | tee "${final_out}/ensemble_summary.log"
echo "Final results: ${final_out}"
| 模型 | Pearson | Spearman | MAE | RMSE |
|---|---|---|---|---|
| 原CRISPRon-ABE | 0.512 | 0.523 | 24.01 | 28.29 |
| Length ensemble | 0.732 | 0.777 | 16.19 | 20.58 |
| Length+Δdistance ensemble | 0.743 | 0.787 | 15.89 | 20.19 |
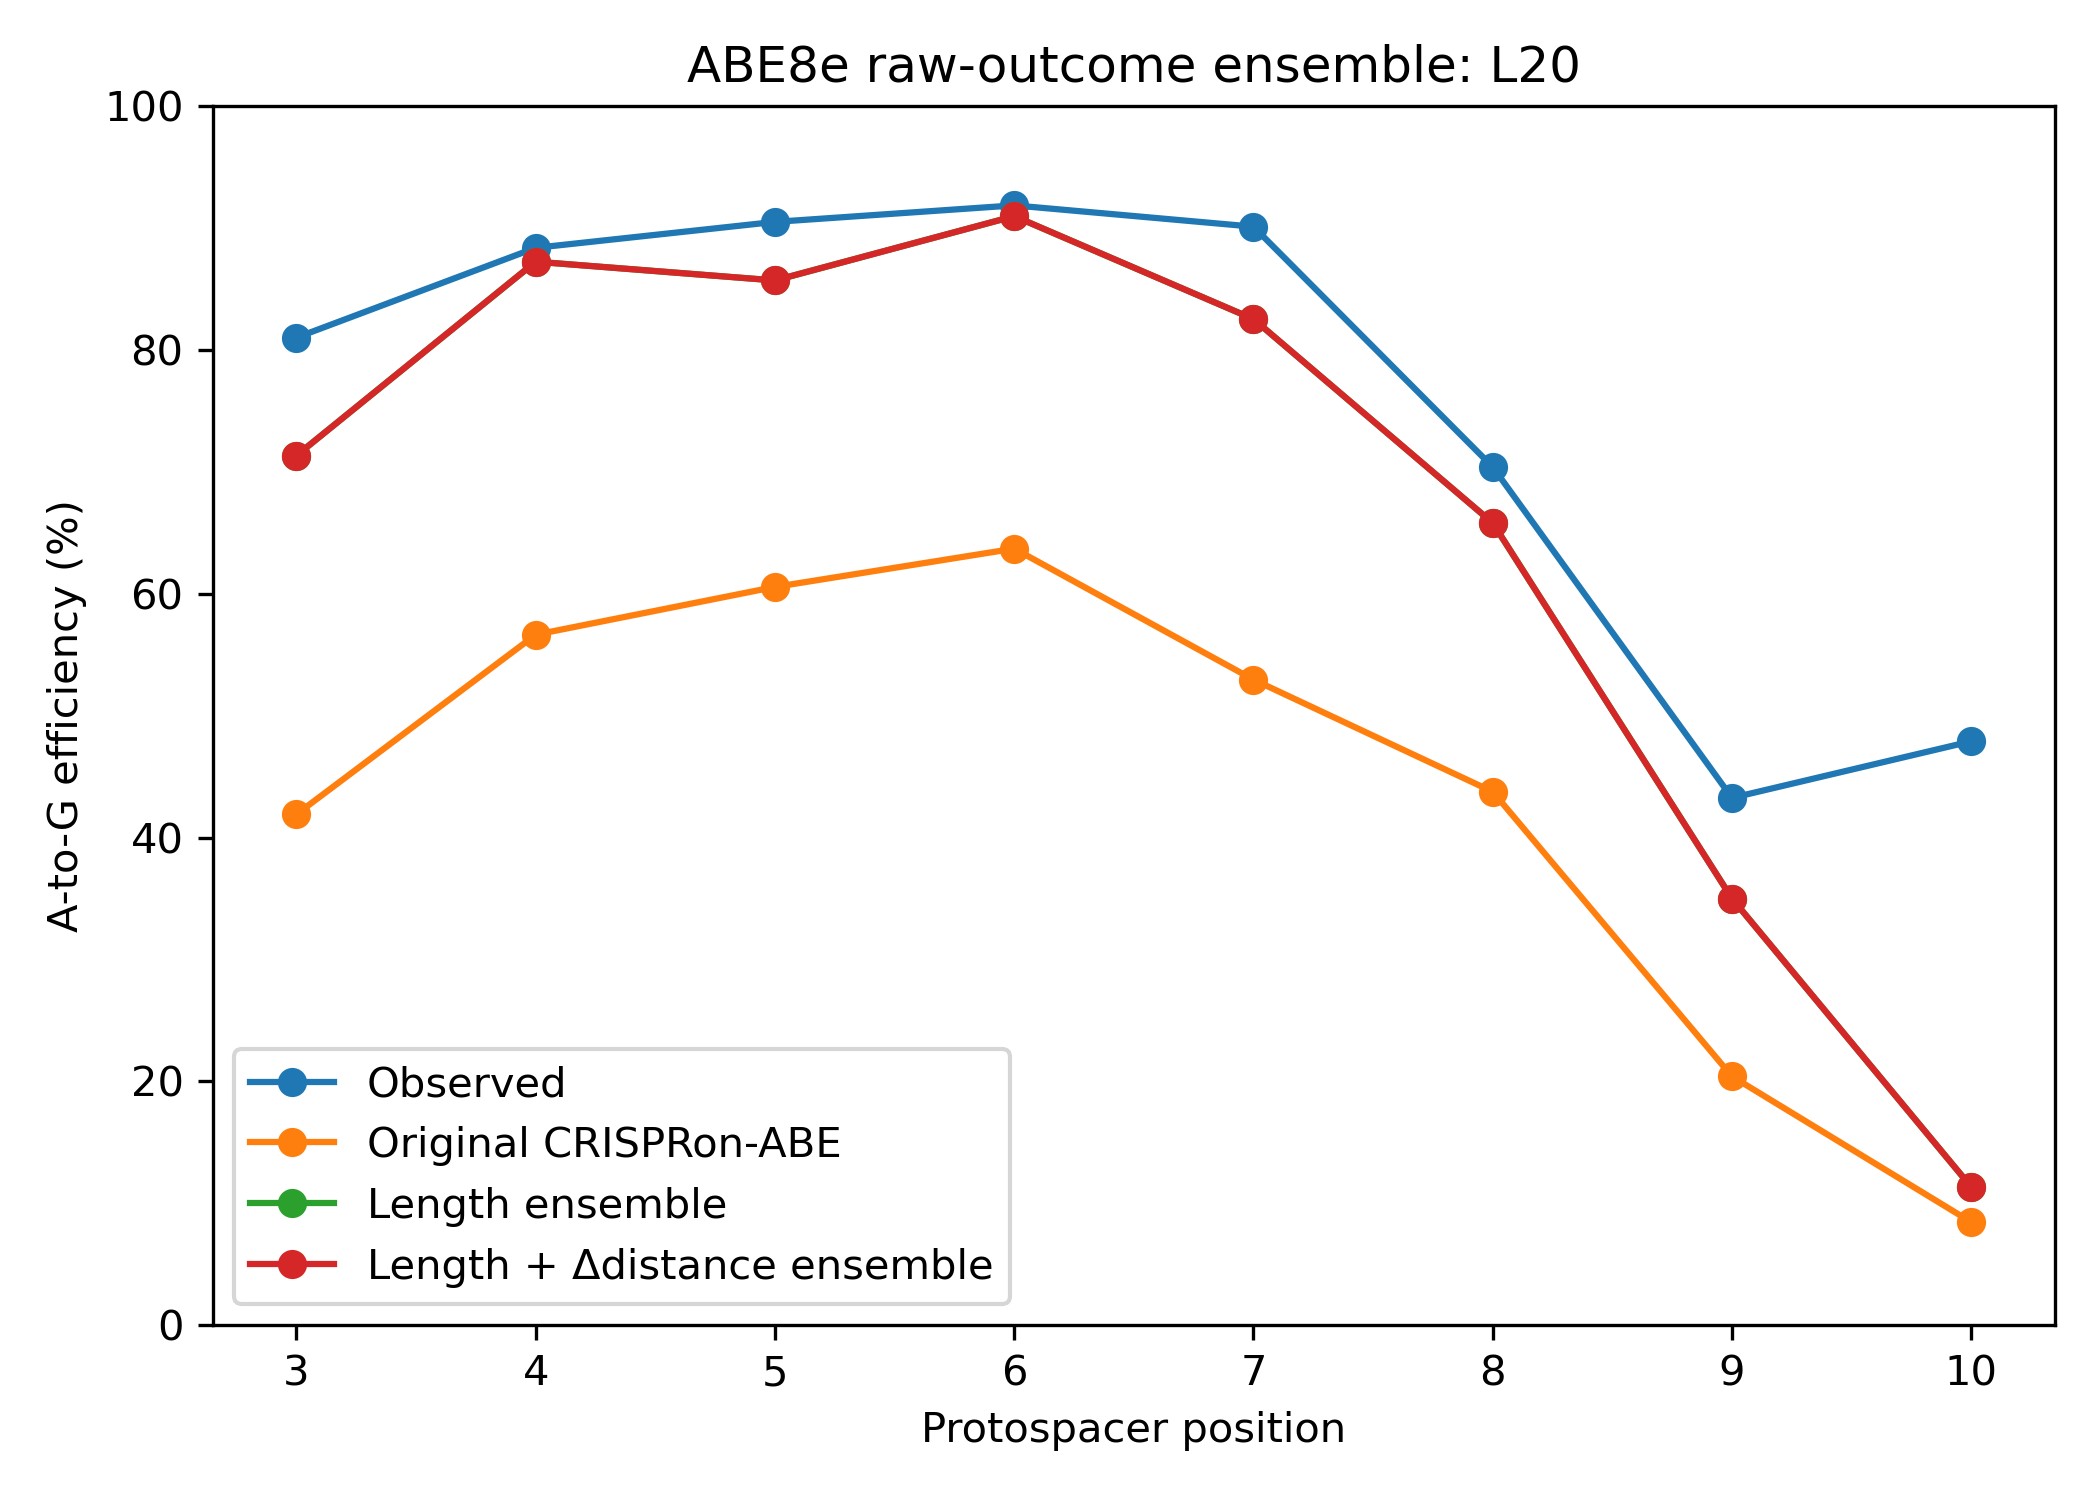
20nt:Length = Length+Δdistance,符合预期
18/19nt:Length+Δdistance多数位置的修正方向都朝向真实曲线
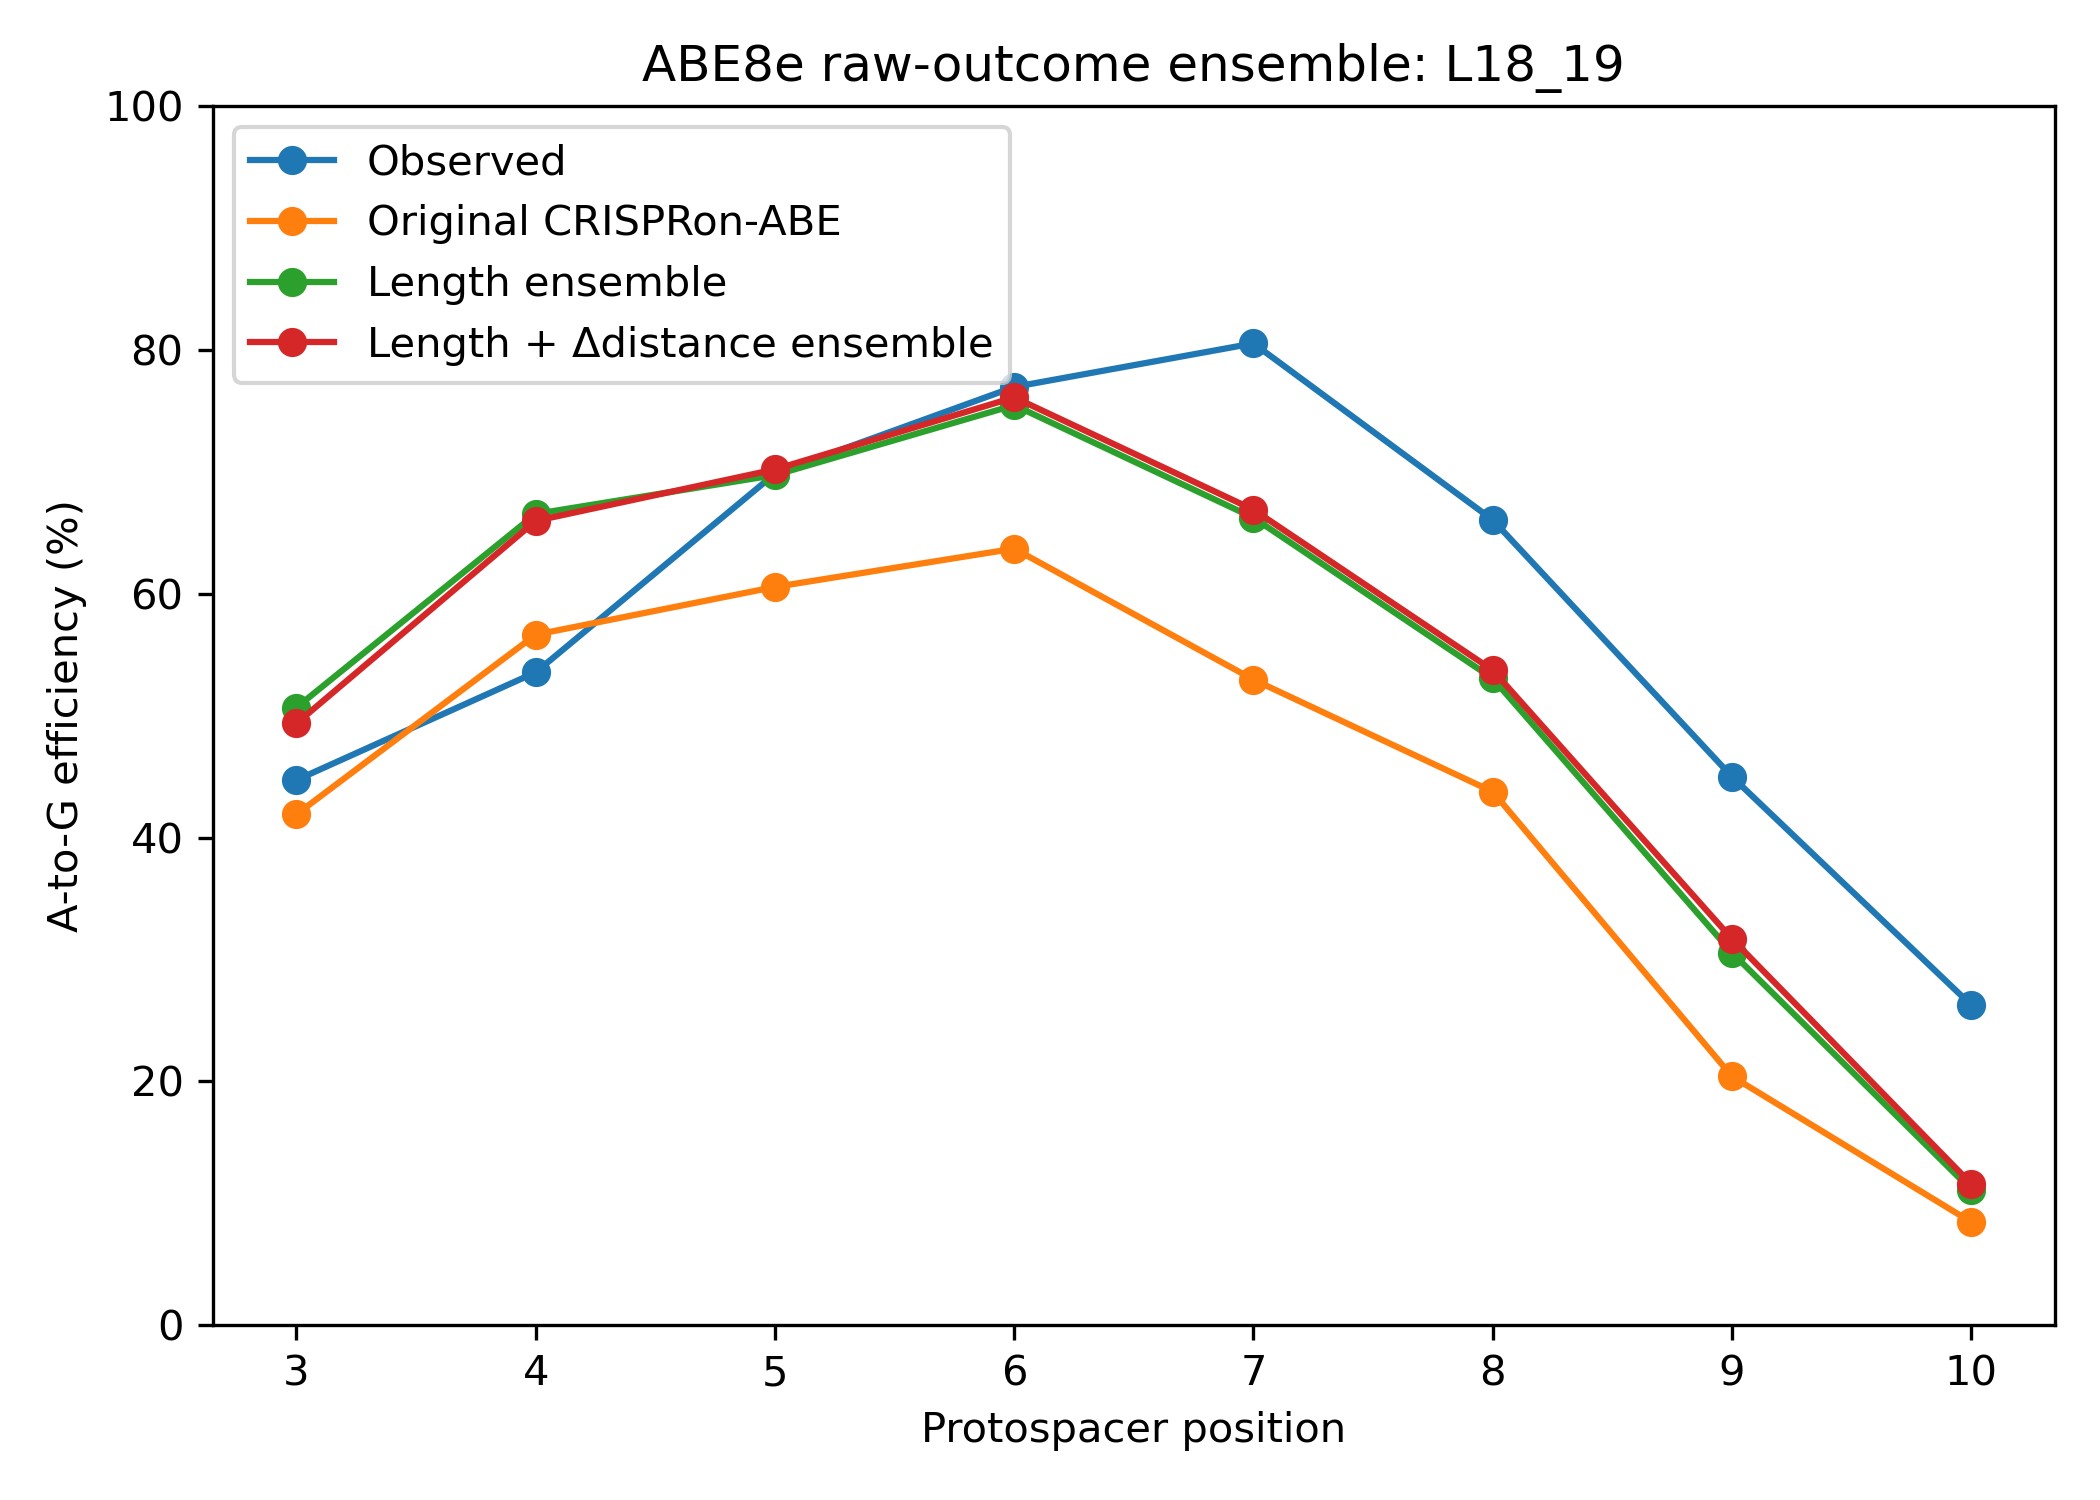
| 指标 | Length | Length+Δdistance |
|---|---|---|
| Pearson | 0.661 | 0.681 |
| Spearman | 0.692 | 0.712 |
| MAE | 15.806 | 15.444 |
| RMSE | 20.615 | 20.087 |
16/17nt:Length+Δdistance的改善更稳定了
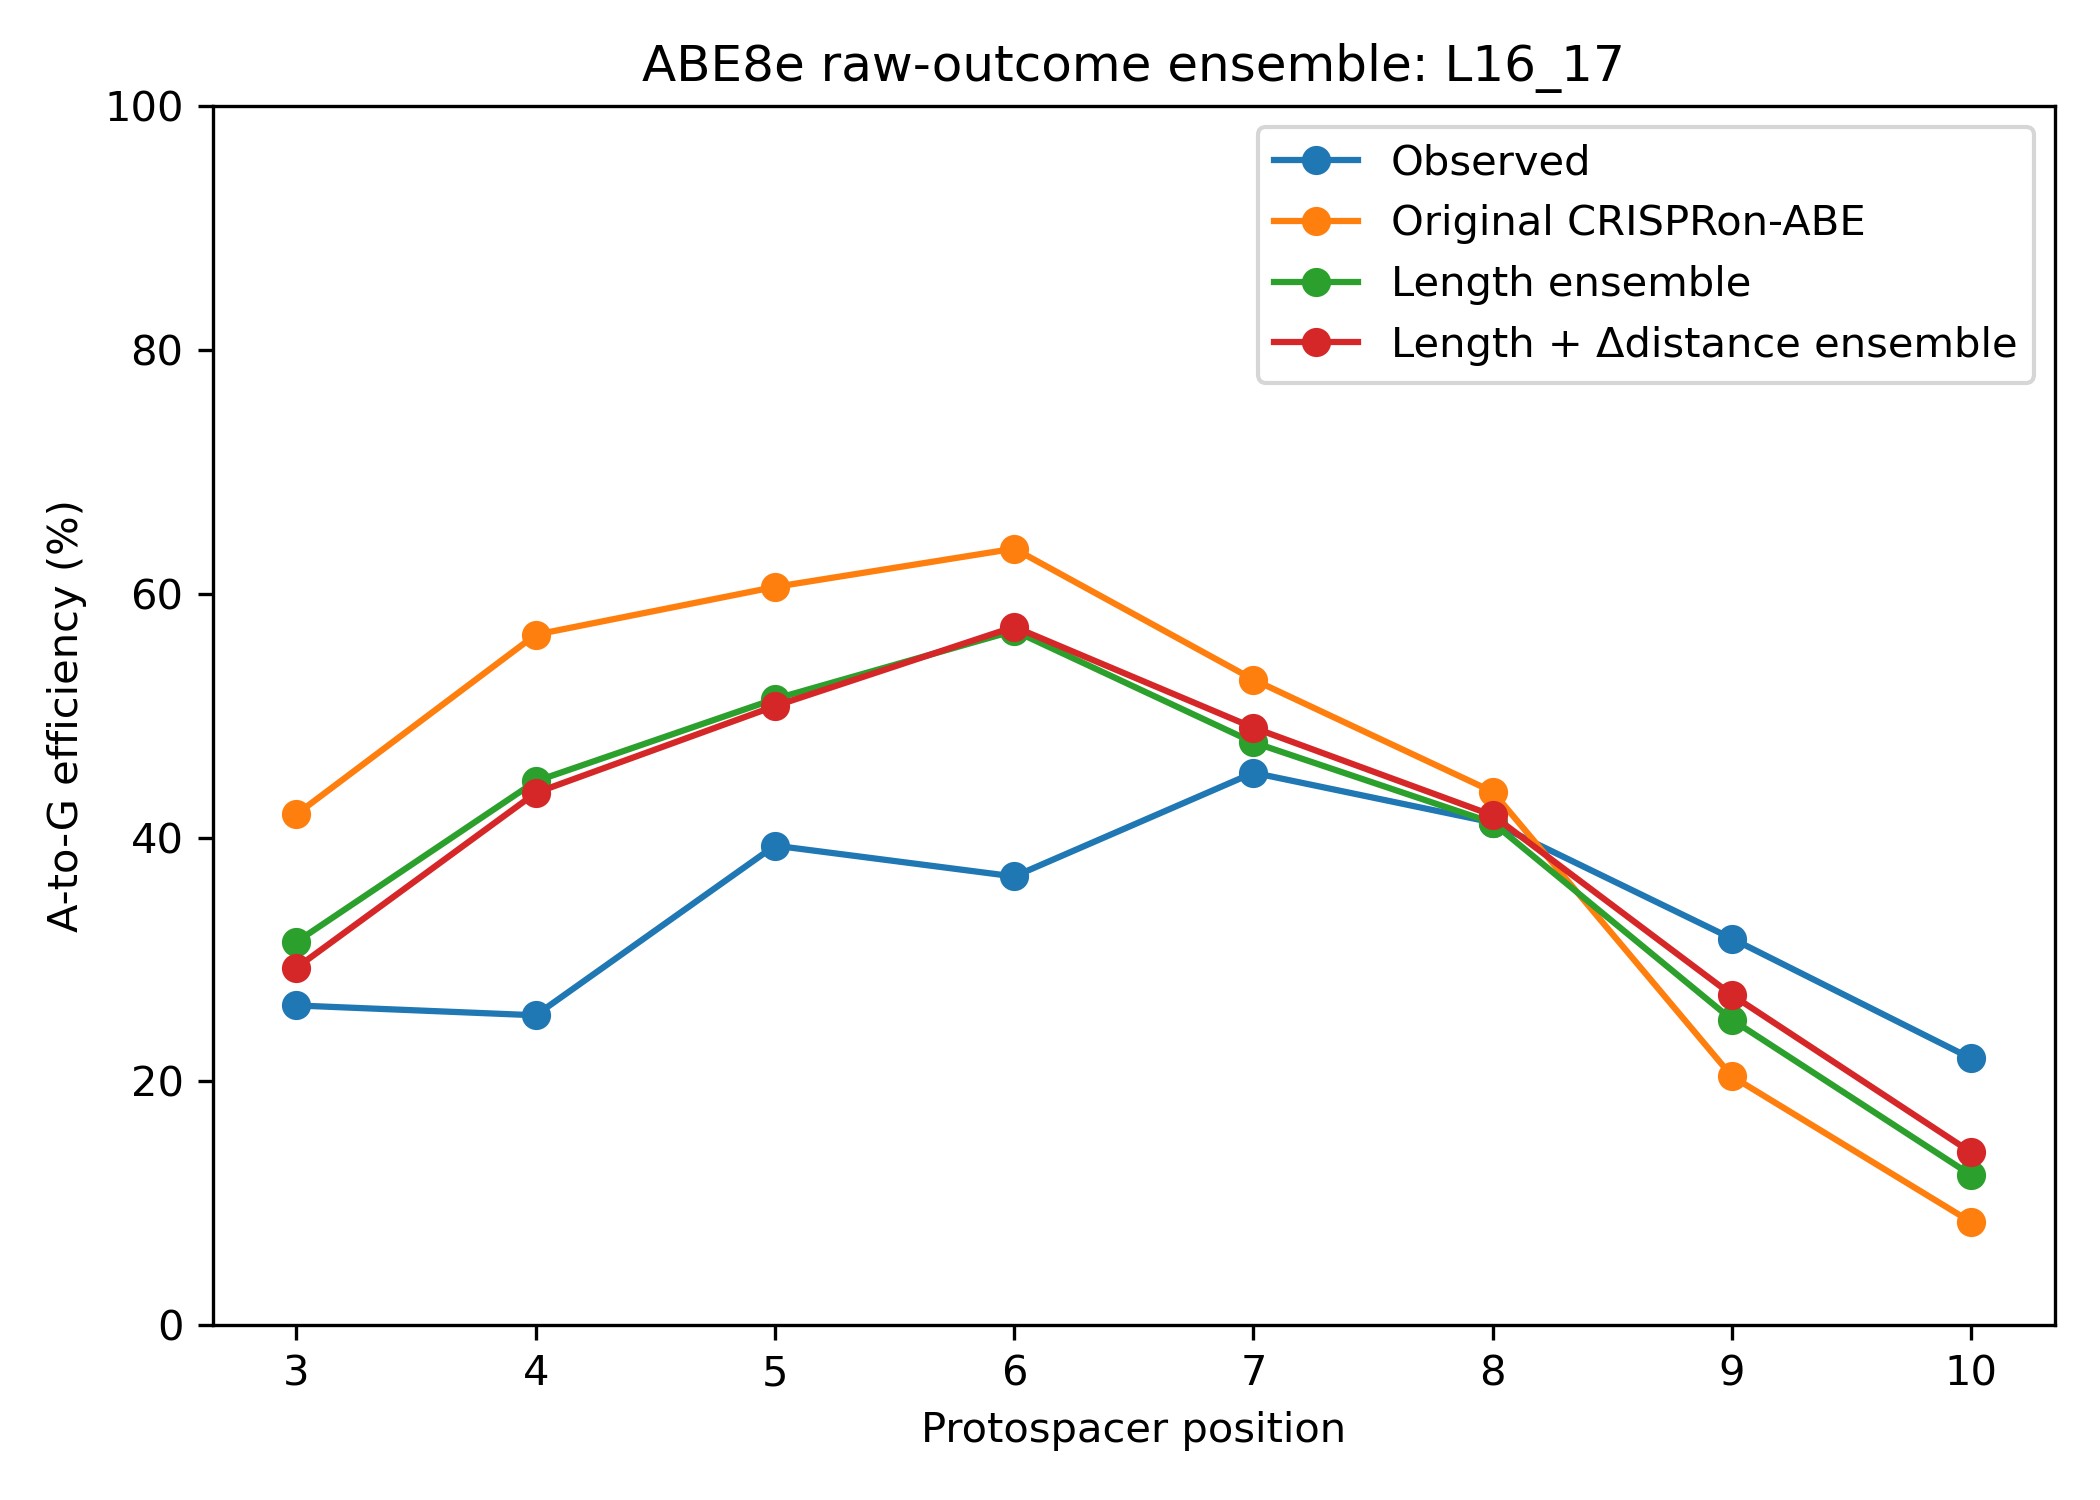
| 指标 | Length | Length+Δdistance |
|---|---|---|
| Pearson | 0.427 | 0.461 |
| Spearman | 0.393 | 0.449 |
| MAE | 19.266 | 18.730 |
| RMSE | 22.943 | 22.367 |
对于每个target:9/12加入Δdistance后MAE下降
- 不过如果把12个target当作独立单位做配对统计,
one-sided sign test p≈0.073、one-sided Wilcoxon p≈0.055,所以不能说Δdistance显著改善了预测
结果中唯一有点小问题的地方:有5条position prediction超过100%
- 原CRISPRon-BE最终Output层没有sigmoid约束,而是一个普通Dense,所以理论上raw pred_eff可以超过100
- 官方normalize只是让
Σpred_freq=pred_eff,不会把pred_eff本身截到100以内(只截断了负的pred_freq,没有限制pred_eff≤100) - 原始CRISPRon-ABE在这组数据上没有遇到这个问题;但经过length branch修正以后,这两个高效L20 target被推到了100以上
- 会略微拉高两种模型总体MAE,但对于
Length和Length+Δdistance的比较没有影响
总的来说:sgRNA length解释了短sgRNA效应的主要部分,而AF3预测的target-specific R-loop structural change在length基础上提供了额外但幅度较小的预测信息
新数据重运行
综上最后使用length+Δdistance的方法:一个嵌入预训练CRISPRon-ABE中的两层MLP adapter branch,通过transfer learning学习结构信息
原CRISPRon-ABE backbone
        ↓
得到原始Dense2前的900维表示
        │
        ├───────────────┐
        │               │
length linear adapter   Δdistance two-layer MLP adapter
        │               │
        ↓               ↓
   900维修正量       900维修正量
        │               │
        └──────┬────────┘
               ↓
与原始900维表示相加
               ↓
       原Dense2 activation
               ↓
          原Dense3
               ↓
          原Output
               ↓
pred_eff + pred_freq
length linear adapter:length输入实际上只有一个数字,只用线性变换把1维变成900维(与原始Dense2同步)Δdistance two-layer MLP adapter:输入8个位点的distance变化,相当于8维数据,连续经过两个Dense层8维Δdistance ↓ Dense(4) ↓ tanh ↓ 4维latent representation4个值就是latent factors,数学上表达类似:远端整体收缩、窗口中部变化、整体开放程度、曲线梯度变化
4维
↓
Dense(900)
↓
900维结构修正
可以理解成要求模型“先概括结构变化,再使用结构变化”,而不是记住每一个distance值,核心目的是减少参数(因为只有12条序列)
- length和distance是两个并行的adapter,最后是把它们输出的向量相加
数据整理:
# try1:ABS4/6X19(18nt)缺失
python "${root}/scripts/prepare_abe8e_outcome_dataset.py" \
    --allele-zip \
    "${root}/data/ABE8e_short_sgRNA/outcome_raw/truncated_sgRNA.zip" \
    --model-table \
    "${root}/data/ABE8e_short_sgRNA/complete_model_input_target_distance/abe8e_short_complete_model_table_target_distance.tsv" \
    --outdir \
    "${root}/data/ABE8e_short_sgRNA/outcome_model" \
    --replicate-match-rmse 0.05 \
    --min-replicates-per-condition 2 \
    --max-missing-replicates-total 1
# 正常情况
python "${root}/scripts/prepare_abe8e_outcome_dataset_fixed.py" \
    --allele-zip \
    "${root}/data/ABE8e_short_sgRNA/outcome_raw/truncated sgRNA.zip" \
    --model-table \
    "${root}/data/ABE8e_short_sgRNA/complete_model_input_target_distance/abe8e_short_complete_model_table_target_distance.tsv" \
    --outdir \
    "${root}/data/ABE8e_short_sgRNA/outcome_model" \
    --max-match-rmse 0.5
一个模型测试:
- 针对上次出现的预测效率超过100%的情况,加了一个soft range penalty作为约束(对应结果的bounded raw-first,不加的叫strict raw-first)
bash "${root}/scripts/run_abe8e_outcome_single_model_test.sh"
问题:在训练过程中出现了
Fold 10: test=S18, validation=S7, raw length-equivalence max diff=7.10543e-15
epoch=  1 train_MSE=134.384 val_MSE=75.490
epoch= 25 train_MSE=111.835 val_MSE=64.480
epoch= 50 train_MSE=96.531 val_MSE=59.063
epoch= 75 train_MSE=87.060 val_MSE=57.383
epoch=100 train_MSE=79.033 val_MSE=56.950
epoch=125 train_MSE=71.894 val_MSE=56.629
epoch=150 train_MSE=66.400 val_MSE=56.301
epoch=175 train_MSE=62.184 val_MSE=56.388
MSE都很大的情况,之前训练时MSE基本都在10-30左右,这合理吗
- 这个数不能和之前的10–30直接比较,因为现在loss已经换了,换句话说这里的
xxx_MSE实际上是xxx_loss,data_loss=0.5*eff_MSE + 0.5*freq_MSE + range_penalty
25-model ensemble:
bash "${root}/scripts/run_abe8e_outcome_25ensemble_v2.sh"
outcome prediction汇总:
| 模型 | Outcome Pearson | Spearman | MAE | RMSE |
|---|---|---|---|---|
| Original CRISPRon-ABE | 0.569 | 0.483 | 2.934 | 7.815 |
| Length | 0.663 | 0.576 | 2.767 | 7.037 |
| Length+Δdistance | 0.676 | 0.604 | 2.740 | 6.914 |
-
尤其16/17nt:
模型 Pearson Spearman MAE RMSE Original 0.472 0.324 2.778 6.518 Length 0.512 0.573 2.322 5.450 Length+Δdistance 0.555 0.621 2.257 5.114 - 结构变化不仅改变position marginal,而且确实帮助预测了具体的多位点编辑outcome组合
-
但对于编辑效率,Δdistance并未比length提供更多信息
模型 Pearson Spearman MAE RMSE Original 0.223 0.231 19.061 21.882 Length 0.691 0.763 11.688 14.938 Length+Δdistance 0.678 0.745 11.784 15.215 -
对于Pearson相关性,总体结果很好,但具体到每个length内(即同length的序列进行排序)结果并不好:模型更擅长学习length-group之间的总体趋势。overall Pearson高,很大一部分来自跨length的巨大均值差异
overall Pearson = 0.691 L20 Pearson ≈ 0.001 L18/19 Pearson ≈ 0.219 L16/17 Pearson ≈ 0.137 -
对于position-level结果,没有之前拿position数据的训练结果好
模型 Pearson Spearman MAE RMSE 旧Length 0.732 0.777 16.188 20.576 新Length 0.715 0.756 17.106 21.432 旧Length+Δdistance 0.743 0.787 15.889 20.187 新Length+Δdistance 0.724 0.758 16.844 21.114 -
distance有额外信息,但受12个独立target的小样本限制,增益比较弱:9/12个target改善(outcome-level),6/12个target改善(position-level)
target Length MAE Length+Δdistance MAE 改善 S7 23.43 20.40 +3.03 PT14 22.51 19.70 +2.81 ABS4 18.28 17.74 +0.54 - bounded raw-first确实比较有效果,真正>100的position只剩
sgANGPTL3-A6 - L20 - pos6,不过总体MAE变化很小(不到0.1),因此无论是选用strict raw-first还是bounded raw-first都不影响结论
| 目标 | 哪一版更适合 |
|---|---|
| 预测position efficiency | 旧position-supervised模型更好 |
| 预测具体outcome frequency | 新outcome-supervised模型明显更合理,也更好 |
| 模拟原CRISPRon-ABE原生任务 | 新outcome-supervised模型 |
| 解释length效应 | 两版都支持 |
| 检验Δdistance增量信息 | 两版都看到小幅信号,新版outcome层面更直接 |
distance差别
概览
python /public/home/GENE_proc/wth/crispron-BE/scripts/extract_abe8e_full_target_distances.py \
  --manifest /public/home/GENE_proc/wth/crispron-BE/data/ABE8e_short_sgRNA/distance_input/abe8e_af3_manifest_first_round.tsv \
  --zip-dir /public/home/GENE_proc/wth/crispron-BE/data/ABE8e_short_sgRNA/af3_target_zips/primary \
  --outdir /public/home/GENE_proc/wth/crispron-BE/data/ABE8e_short_sgRNA/af3_full_target_distance \
  --reference-table /public/home/GENE_proc/wth/crispron-BE/data/ABE8e_short_sgRNA/af3_target_distance/abe8e_target_specific_distance_table.tsv
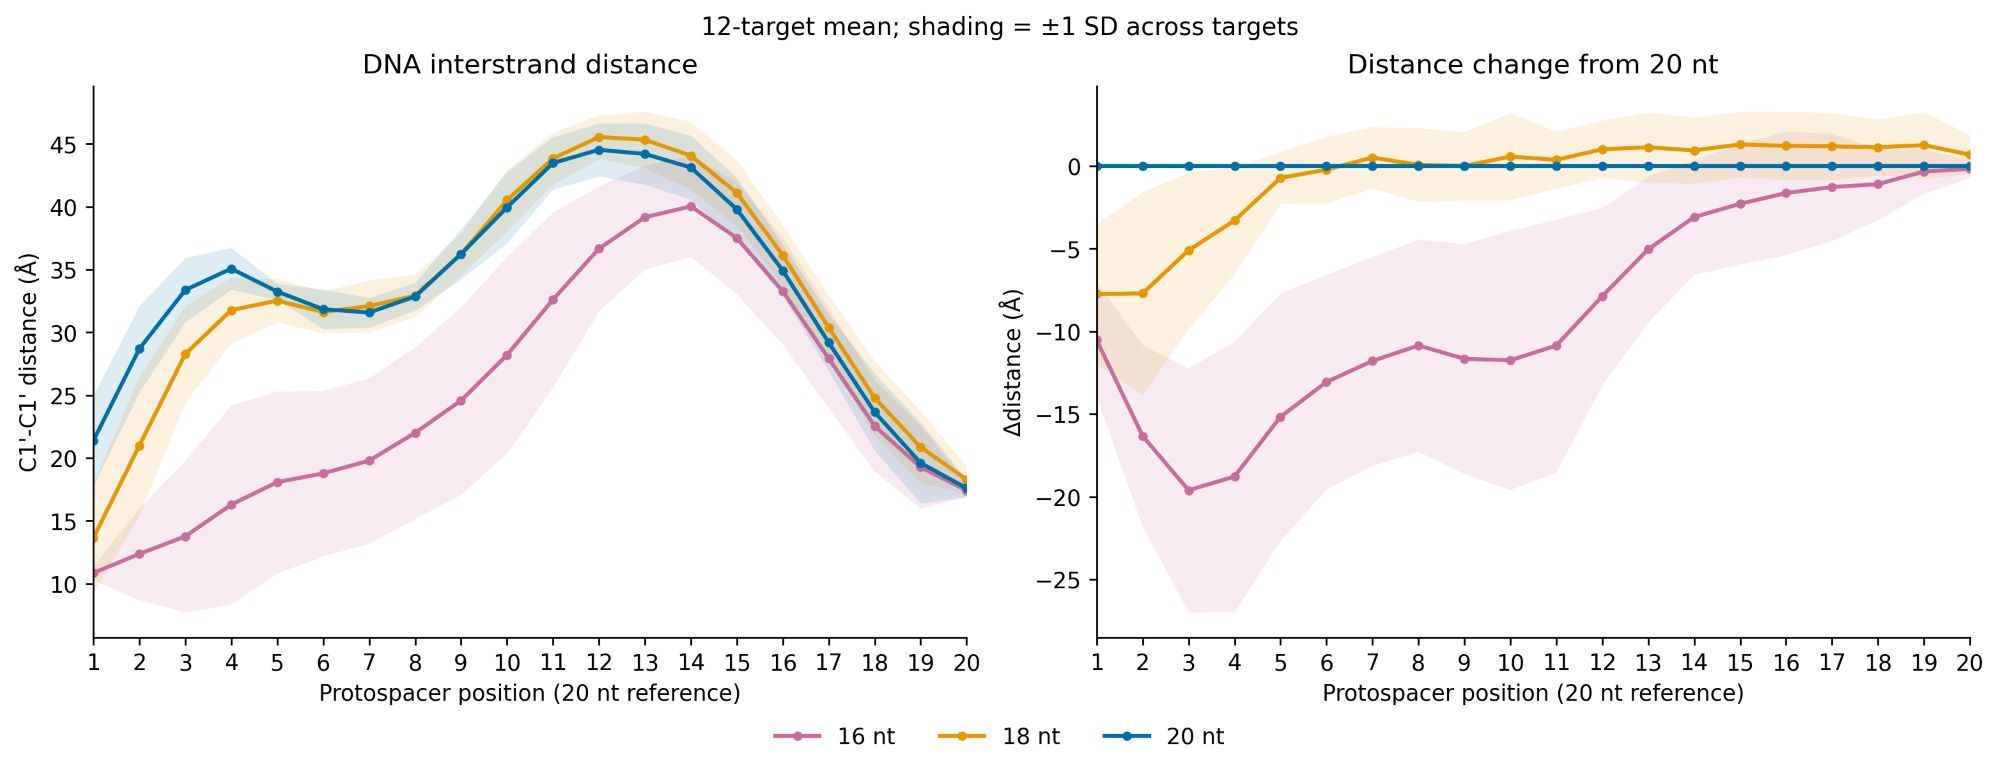
不同length
| 长度 | position3–10平均distance |
|---|---|
| 20nt | 34.27Å |
| 18nt | 33.24Å |
| 16nt | 20.18Å |
| Position | 20nt平均distance(Å) | 18nt平均distance(Å) | 16nt平均distance(Å) | 18−20(Å) | 16−20(Å) | 16−18(Å) |
|---|---|---|---|---|---|---|
| 3 | 33.37 | 28.27 | 13.77 | -5.10 | -19.61 | -14.51 |
| 4 | 35.07 | 31.77 | 16.29 | -3.30 | -18.78 | -15.48 |
| 5 | 33.25 | 32.52 | 18.08 | -0.72 | -15.17 | -14.45 |
| 6 | 31.84 | 31.62 | 18.78 | -0.22 | -13.06 | -12.84 |
| 7 | 31.58 | 32.09 | 19.79 | +0.51 | -11.79 | -12.30 |
| 8 | 32.85 | 32.92 | 22.00 | +0.07 | -10.85 | -10.92 |
| 9 | 36.23 | 36.23 | 24.57 | -0.00 | -11.66 | -11.66 |
| 10 | 39.95 | 40.52 | 28.20 | +0.57 | -11.75 | -12.32 |
20nt和18nt整体R-loop开放程度其实很接近,但16nt出现了明显的结构状态转换
- 20nt和18nt之间的差异其实主要集中在PAM-distal侧的position3–4,pos6以后几乎一样
- 16nt在所有position3–10的distance都明显下降
同length不同target
结果:同一sgRNA length下,不同target的AF3预测distance确实有差别,而且这种差别在16/17nt条件下最明显;18/19nt和20nt也存在target-specific差异,但幅度小很多
16/17nt:各位置的between-target SD基本都在6–8Å,同一个position在不同target之间也可能相差20Å左右
| 位置 | between-target SD | target间range |
|---|---|---|
| 3 | 6.05Å | 17.25Å |
| 4 | 7.94Å | 23.02Å |
| 5 | 7.25Å | 22.54Å |
| 6 | 6.59Å | 21.62Å |
| 7 | 6.59Å | 20.86Å |
| 8 | 6.84Å | 19.38Å |
| 9 | 7.47Å | 21.76Å |
| 10 | 7.83Å | 22.90Å |
- 例如position4,有些target仍然接近10–12Å,而sgANGPTL3-A6已经超过33Å
- position10有些target只有18Å左右,而另一些已经达到37–41Å
18/19nt的target间差异明显收窄(平均between-target SD≈2.22Å,平均range≈7.53Å);20nt更小(平均between-target SD≈1.70Å,平均range≈5.30Å)
| 长度 | 不同target整条pos3–10曲线平均两两差异 | 最大两两差异 |
|---|---|---|
| 16/17nt | 7.90Å | 20.97Å |
| 18/19nt | 2.54Å | 4.65Å |
| 20nt | 1.96Å | 3.91Å |
同target的AF3预测结果
16/17nt:
| 位置 | target间SD | AF3内部SD | ratio |
|---|---|---|---|
| 3 | 6.05 | 2.13 | 2.84 |
| 4 | 7.94 | 3.70 | 2.15 |
| 5 | 7.25 | 5.71 | 1.27 |
| 6 | 6.59 | 6.33 | 1.04 |
| 7 | 6.59 | 6.66 | 0.99 |
| 8 | 6.84 | 7.85 | 0.87 |
| 9 | 7.47 | 9.20 | 0.81 |
| 10 | 7.83 | 10.66 | 0.73 |
between_target_sd:相同length、相同position,不同target均值之间的SDmean_within_AF3_sd:同一个target、同一个length、同一个position,AF3产生的5个候选结构之间的平均SD- ratio = between-target variation / within-AF3 variation(
target间差异是AF3自身预测波动的几倍) - 在position3–4,ratio>2
- 但到了position8–10,ratio<1
18/19nt虽然target之间的绝对差异没有16/17nt那么大,但AF3自身也稳定很多,这也解释了前面建模时length+Δdistance在18/19nt条件下的增益比16/17nt稳定
一些问题
原模型评估方法是什么,用Pearson相关性了吗
训练阶段,作者把数据划成6个partition,其中5个用于5-fold cross-validation,第6个保留为独立test set。训练和validation阶段使用的是MSE,early stopping也是看validation MSE。但是到了最终独立test set的benchmark,论文的主指标不是MSE,而是R2,即extended two-dimensional Pearson correlation coefficient;以及对应的二维Spearman——ρ2
- 因为模型同时输出两个变量——预测的编辑效率和各outcome频率,所以使用二维Pearson和二维Spearman联合评价二者
Pearson相关性是什么,对于outcome这种向量能用Pearson吗
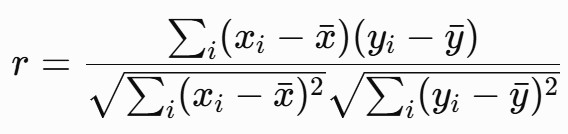
- 主要问:真实值高的时候,预测值是不是也高;真实值低的时候,预测值是不是也低?
- 这里计算的方式是:用
[f1,f2,…,fm]表示一个target所有可能outcome的频率向量,和预测值[f^1,f^2,…,f^m]计算Pearson - 在论文中,作者把结果整合成一个二维矩阵,每一行一个outcome,两列分别是editing efficiency和outcome frequency
-
缺点:它评价趋势,不评价绝对准确度
真实值
x=[5,10,20,30],预测值y=[20,30,50,70],Pearson仍然是r=1
在迁移学习中,两个900维修正能不能用其它方法加一下
我们现在实际上是:z=zoriginal+Δzlength+Δzdistance,采用的是典型的additive residual fusion(加性残差融合),结构简单,而且我们能够让新增分支初始输出严格为0
- 缺点:length correction和distance correction主要是“线性叠加”,它们之间没有显式交互
| 方法 | 形式 | 特点 |
|---|---|---|
| 当前加法 | base + length + distance | 最稳、参数少 |
| 加权加法 | base + α·length + β·distance | 显式学习两种修正的重要性 |
| Gated fusion | base + g·distance,其中g由length决定 | 可直接表示length调控distance作用 |
| Concatenation | concat(base,length,distance)→projection | 表达力强,但参数量非常大 |
| FiLM/modulation | γ⊙base+β | 让length/distance调节原hidden representation |
| 低秩交互 | length×distance latent interaction→900 | 显式建模二者协同,参数较少 |
- 最推荐的是gated fusion,让length决定distance修正的权重
- 如果是其它方法或cross-attention/Transformer,就需要更大的参数量
gated fusion
z=zoriginal+zlength+g(L)⋅zΔdistance
其中,g(L)=1+tanh(wLstd+b)
所以gate是一个由sgRNA length决定的标量,范围在0<g<2
g<1:当前长度下削弱structure correctiong≈1:保持原distance correctiong>1:当前长度下放大structure correction
因为训练数据过少,这里没有用900维gate,而只用了一个scalar gate,这样只多了1个weight+1个bias两项参数。distance branch仍然是之前固定的,只有distance_900→gate(length) × distance_900
root="/public/home/GENE_proc/wth/crispron-BE"
bash "${root}/scripts/run_abe8e_outcome_gated_25ensemble.sh"
总结:gated fusion确实学到了length-dependent的结构权重,并且相对纯length模型改善了outcome-frequency和position-level预测;但是它仍然轻微牺牲了overall editing-efficiency,而且按照原论文的二维R2 / ρ2评价,它与之前的additive Δdistance几乎没有差别
| 层级 | Length | Gated Δdistance | 变化 |
|---|---|---|---|
| Editing Pearson | 0.691 | 0.676 | 下降 |
| Editing Spearman | 0.763 | 0.746 | 下降 |
| Editing MAE | 11.688 | 11.910 | 变差0.222 |
| Editing RMSE | 14.938 | 15.244 | 变差 |
| Outcome Pearson | 0.663 | 0.678 | 提高 |
| Outcome Spearman | 0.576 | 0.604 | 提高 |
| Outcome MAE | 2.767 | 2.725 | 改善 |
| Outcome RMSE | 7.037 | 6.897 | 改善 |
| Position Pearson | 0.712 | 0.728 | 提高 |
| Position Spearman | 0.756 | 0.762 | 提高 |
| Position MAE | 17.076 | 16.725 | 改善 |
| Position RMSE | 21.403 | 20.891 | 改善 |
- 在不同target内,Gated模型也像之前的Additive一样是有好有坏
| 模型 | R2 | ρ2 |
|---|---|---|
| Original | 0.255 | 0.301 |
| Length | 0.6725 | 0.6411 |
| Additive Δdistance | 0.6663 | 0.6484 |
| Gated Δdistance | 0.6668 | 0.6482 |
但值得肯定的是,gate本身学到了distance权重随长度缩短而增加的趋势:
| 长度 | Gate mean | SD |
|---|---|---|
| L20 | 1.013 | 0.079 |
| L18/19 | 1.125 | 0.169 |
| L16/17 | 1.214 | 0.269 |
- 即sgRNA越短,模型越倾向于增强R-loop structural correction,这和我们的建模假设是相符的
- 但这个趋势在各长度的12条序列中并不稳定,只有大约2/3的是这个方向
各指标最好的模型:
- Overall editing efficiency:Length only
- Outcome frequency:Gated Δdistance
- Position efficiency:Gated Δdistance
- 原论文联合R2:Length only
- 原论文联合ρ2:Additive Δdistance / Gated Δdistance
最终结果应该保留三个层级:
| 模型 | 作用 |
|---|---|
| Original CRISPRon-ABE | 原始baseline |
| Length | 证明truncation length是主要效应 |
| Length+gated Δdistance | 最终structure-aware模型 |
- gated相比additive:outcome略好、position略好、参数增加极少、而且有更合理的length-structure交互解释
汇总
围绕短sgRNA条件下的ABE8e编辑预测,对CRISPRon-BE中的ABE预训练模型进行了扩展,解决的核心问题是“sgRNA缩短造成的编辑效率和编辑窗口变化,能否通过长度信息进行预测”以及“在已知长度的基础上,AF3(AlphaFold 3)预测的R-loop结构变化是否还能提供额外信息”。共分为三个预测层级:
- 总体编辑效率:编辑事件的总体发生比例
- outcome frequency:某一种具体编辑组合的频率
- position efficiency:某一A位点发生编辑的比例
1. 在公开ABE8e数据上验证预测流程,并用原模型预测我们的不同长度的数据(来自12个靶点,每个靶点包含多个sgRNA长度条件和3次重复)
-
公开ABE8e数据上的流程验证结果
评价层级 记录数 Pearson Spearman MAE RMSE 总体编辑效率 1,092 0.728 0.795 5.26 9.88 A3–A10位置效率 2,687 0.893 0.872 6.98 11.15 输入构建、预测和outcome到位置效率的汇总流程基本正确
-
原模型在短sgRNA实验中的位置效率表现
长度条件 实测均值 原模型预测均值 Pearson Spearman MAE 全部长度 56.69% 45.40% 0.512 0.523 24.01 L20 76.18% 45.40% 0.787 0.862 31.35 L18/19 59.49% 45.40% 0.707 0.723 18.74 L16/17 34.41% 45.40% 0.378 0.358 21.95 在相同靶点和位置集合中,实测平均位置效率随sgRNA缩短而下降,而原模型三组预测完全相同
2. AF3结构特征及其不确定性
以Cas9蛋白、完整sgRNA和两条DNA链为输入,预测不同长度条件下的复合物结构,并提取互补DNA碱基之间C1′原子的欧氏距离,作为局部双链分离程度的几何指标。每个条件使用AF3返回的5个候选结构,计算各位置距离的均值和标准差,形成A3–A10的8维距离曲线
| 位置 | 20nt距离(Å) | 18nt距离(Å) | 16nt距离(Å) |
|---|---|---|---|
| A3 | 33.37 | 28.27 | 13.77 |
| A4 | 35.07 | 31.77 | 16.29 |
| A5 | 33.25 | 32.52 | 18.08 |
| A6 | 31.84 | 31.62 | 18.78 |
| A7 | 31.58 | 32.09 | 19.79 |
| A8 | 32.85 | 32.92 | 22.00 |
| A9 | 36.23 | 36.23 | 24.57 |
| A10 | 39.95 | 40.52 | 28.20 |
| A3–A10平均 | 34.27 | 33.24 | 20.18 |
- 20nt与18nt的平均距离较为接近,差异主要集中在PAM远端的A3–A4;16nt在整个A3–A10区间均出现明显下降
- 同一长度下,不同靶点也存在结构差异:L16/17各位置的靶点间标准差约为6–8Å,部分位置的最大与最小距离相差20Å以上;整条A3–A10曲线的平均两两差异为7.90Å,而L18/19和L20分别为2.54Å和1.96Å
- 另一方面,L16/17的候选结构波动也较大:A3–A4的靶点间标准差约为AF3候选结构内部标准差的2倍以上,而A8–A10的这一比值低于1,表明后几个位置的靶点差异容易受到结构预测不确定性的影响
3. 从简单模型到内部结构分支的探索
最开始的数据只有位置标签(每个位点的编辑效率),为了做出适配这种数据,在公开20nt数据上尝试将预训练模型直接转换为位置效率回归模型:
| 方案 | Pearson | Spearman | MAE |
|---|---|---|---|
| 原模型对照 | 0.889 | 0.869 | 6.90 |
| 只训练位置输出层 | 0.727 | 0.722 | 12.19 |
| 微调Dense2和Dense3 | 0.869 | 0.811 | 8.38 |
| 序列编码器加新预测头 | 0.786 | 0.735 | 11.14 |
- 只训练201个输出层参数不足以完成任务转换 → 解冻约100万个参数后,训练误差继续下降而验证改善停滞,出现过拟合迹象 → 换用约6万个参数的新预测头也未超过原模型
- 问题不只是可训练参数数量:原模型中的outcome向量表示一个具体编辑组合,不能在保持其余含义不变的情况下,直接改作某一位置的查询向量。位置效率又是多个outcome频率的总和,直接回归可能无法充分保留原模型已学到的组合信息
- 因此,后续保留原模型的总体编辑效率和outcome频率输出,只在模型内部加入一个小型分支,用来学习短sgRNA造成的变化
4. 保留原模型的预测方式,在内部加入长度或距离分支
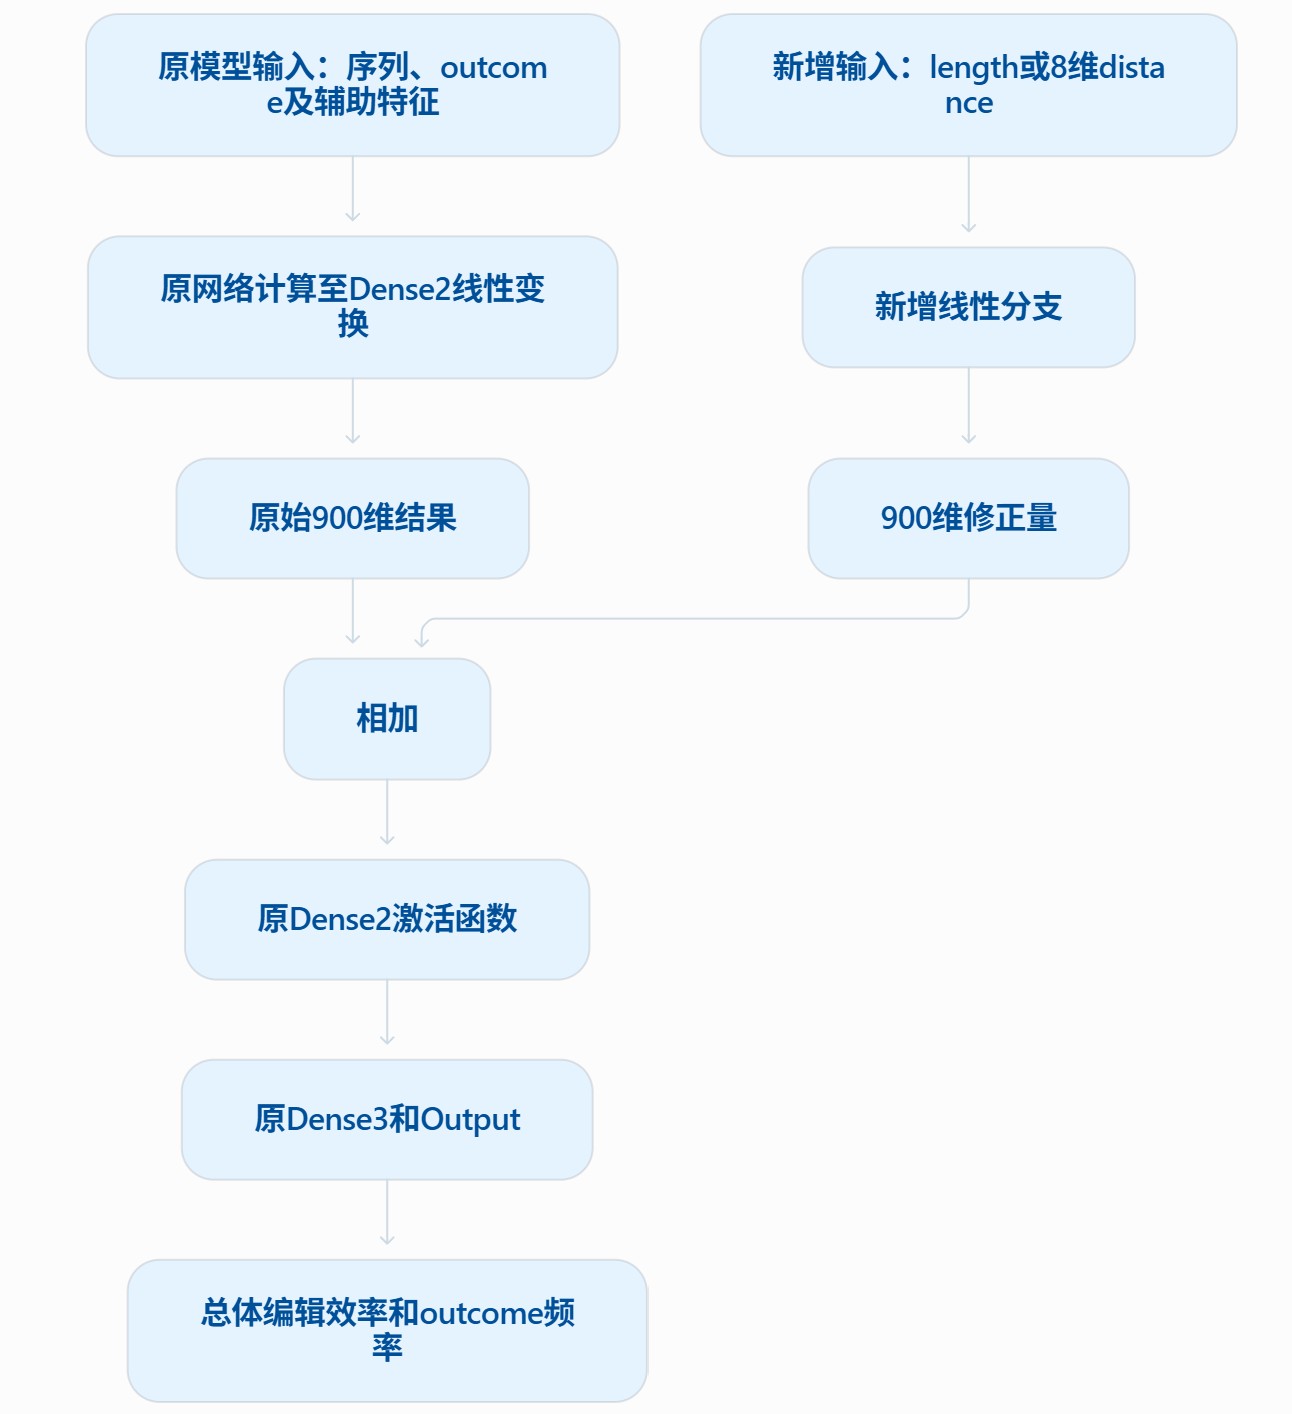
- 原模型参数保持不变,只训练新增分支
- 由于当时只有位置效率标签,训练时先把预测的outcome频率汇总成位置效率,再与实测值比较,用误差更新新增分支
| 模型 | 新增部分 | 想回答的问题 |
|---|---|---|
| Calibration | 不随长度变化的内部偏移量 | 仅适应本批实验的效率水平,能改善多少? |
| Length | 长度经线性变换,生成900维修正量 | 明确告诉模型sgRNA长度,能改善多少? |
| Distance | 8维绝对距离经线性变换,生成900维修正量 | 结构距离能否用于预测短sgRNA的编辑变化? |
为检验对新靶点的预测能力,每次完整留出一个靶点作为测试集,该靶点的所有长度条件都不参与训练,12个靶点轮流测试
| 模型 | Pearson | MAE |
|---|---|---|
| 原模型model_1_1 | 0.504 | 24.01 |
| Calibration | 0.464 | 21.89 |
| Length | 0.704 | 16.77 |
| Distance | 0.692 | 18.24 |
- 加入长度后,预测改善最明显;加入绝对距离也有帮助,但整体不如长度模型
- 长度是首先需要加入的信息;距离可能包含额外信息,但直接让它同时解释“sgRNA变短”和“不同靶点的结构差异”,在当前小样本下不够稳定
5. 在Length模型上加入Δdistance分支
新的结构输入不再使用绝对距离,而是使用同一靶点相对于20nt状态的距离变化:Δdistance(L)=distance(L)−distance(20nt),即“这个靶点的sgRNA缩短后,A3–A10的结构距离分别改变了多少”。模型保留两个独立分支:
- 长度分支:1维length→900维修正量,学习不同长度条件下共同存在的编辑变化
- 结构分支:8维Δdistance→4维→900维修正量,学习不同靶点在截短后表现出的结构变化
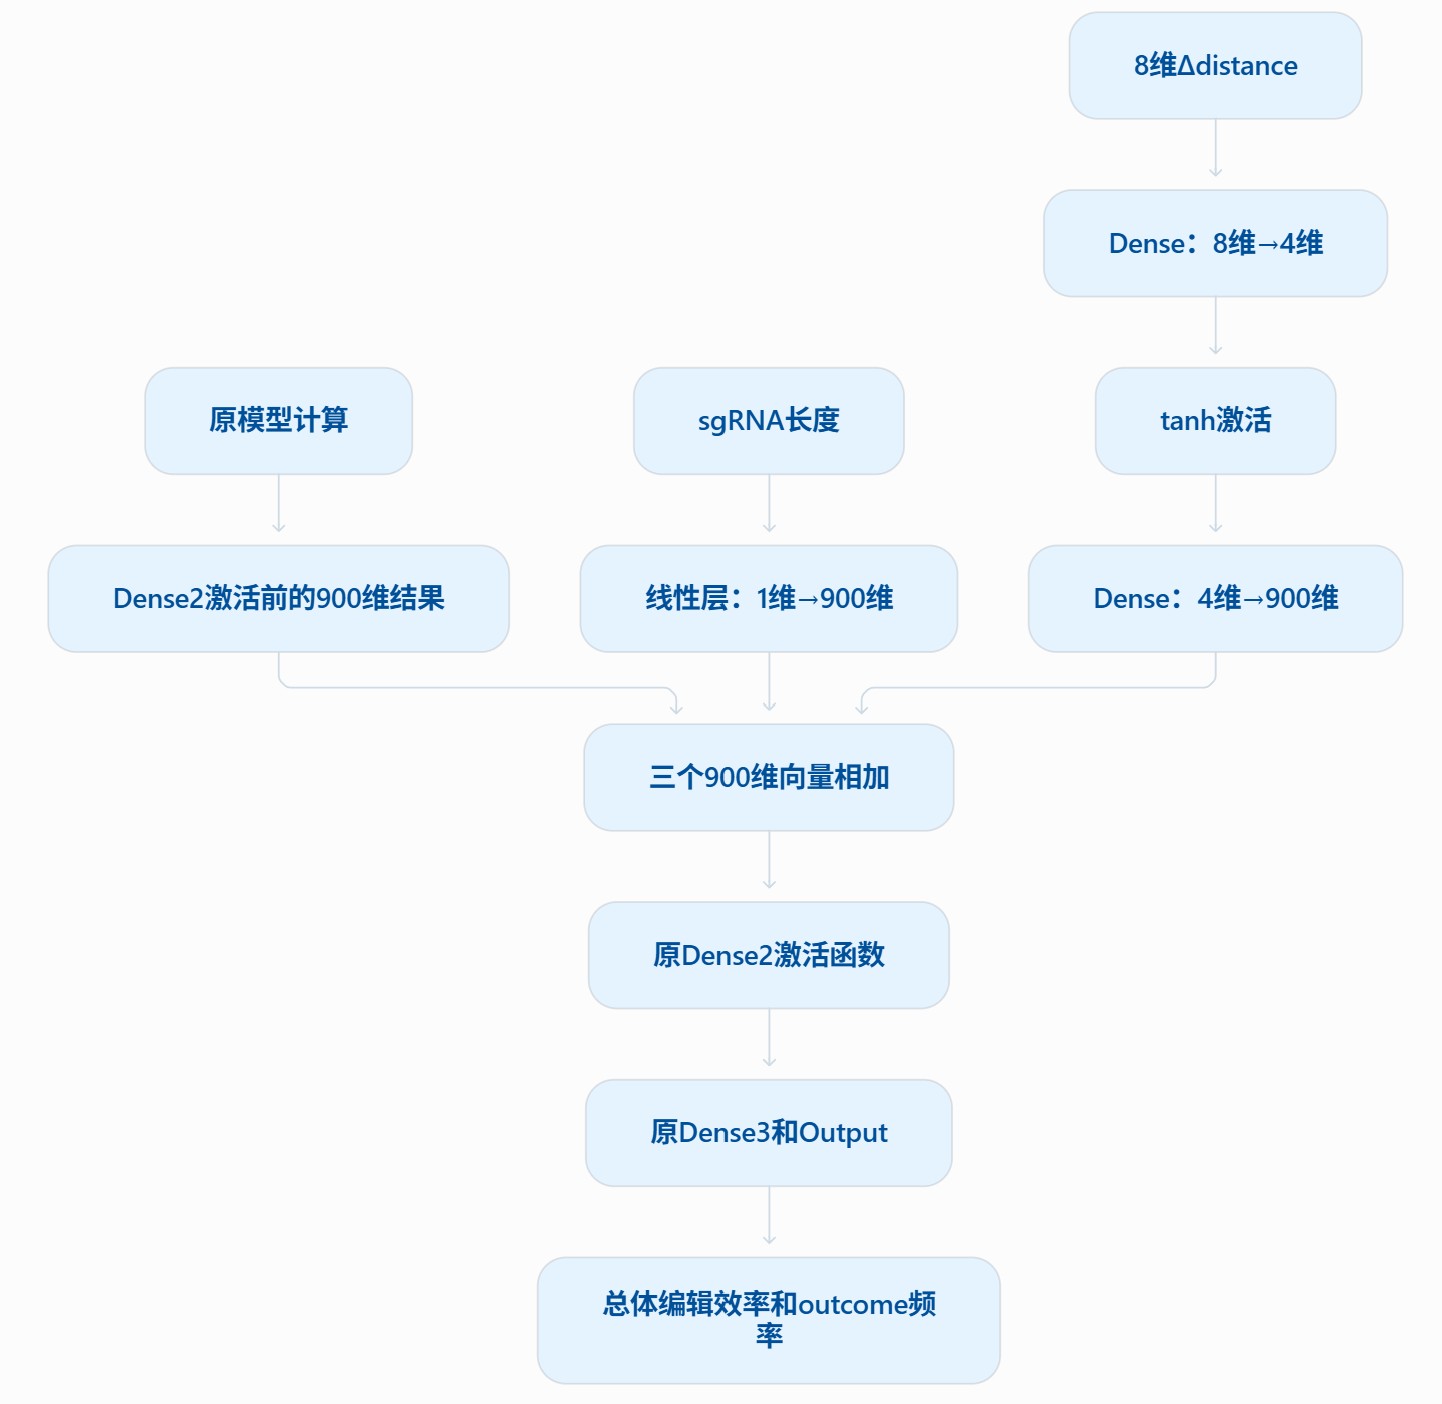
- 这里的“two-layer MLP”就是结构分支连续经过两个全连接层:先从8维压缩到4维,再转换成900维
- 中间的4维用来概括距离变化,减少需要训练的参数,不对应预先定义的四种生物学结构
- 训练分两步进行:先训练Length模型,再固定原模型和长度分支,训练新增的Δdistance分支。结构分支设计为在Δdistance为0时不产生修正,因此20nt条件仍保留Length模型的预测
| 模型 | Pearson | MAE |
|---|---|---|
| Length | 0.704 | 16.769 |
| Length+Δdistance | 0.710 | 16.578 |
- 加入Δdistance后,整体有小幅改善,但单模型中的改善主要来自L18/19,L16/17没有明显改善
- 扩展到25个预训练模型,检验结构增益是否依赖某一个模型:每个预训练模型都分别训练Length和Length+Δdistance版本。汇总时,先对25个模型的原始outcome输出取平均,再按原流程归一化,使outcome频率之和与总体编辑效率一致,最后汇总为位置效率
| 模型 | Pearson | Spearman | MAE |
|---|---|---|---|
| 原模型集成 | 0.512 | 0.523 | 24.01 |
| Length集成 | 0.732 | 0.777 | 16.19 |
| Length+Δdistance集成 | 0.743 | 0.787 | 15.89 |
- 长度带来了主要改善,Δdistance在此基础上进一步降低了误差。12个靶点中有9个在加入Δdistance后改善,但靶点层面的统计检验尚未达到显著水平
- 因此,多模型结果仍支持相同判断:结构变化可能提供额外信息,但增益较小,尚不能说已经得到稳定、显著的提升
6. 获得真实outcome数据后,改为直接训练编辑效率和编辑组合频率
前面的模型虽然输出outcome频率,但训练时只知道位置效率。不同的编辑组合分布可能产生相同的位置效率,因此这种训练方式不能充分判断模型是否预测对了具体编辑组合。获得原始编辑产物数据后,继续使用Length和Length+Δdistance结构,但改为直接用真实的总体编辑效率和outcome频率训练新增分支
- 只更换训练标签,而不是重新设计网络
| 评价层级 | 模型 | Pearson | MAE |
|---|---|---|---|
| 总体编辑效率 | 原模型 | 0.223 | 19.061 |
| 总体编辑效率 | Length | 0.691 | 11.688 |
| 总体编辑效率 | Length+Δdistance | 0.678 | 11.784 |
| Outcome频率 | 原模型 | 0.569 | 2.934 |
| Outcome频率 | Length | 0.663 | 2.767 |
| Outcome频率 | Length+Δdistance | 0.676 | 2.740 |
- 总体编辑效率主要受益于长度信息,加入Δdistance后没有进一步改善
- 具体编辑组合的频率可以从Δdistance中获得小幅帮助:L16/17条件下,outcome的Pearson由0.512提高到0.555,MAE由2.322降至2.257
7. 加入门控融合,让长度决定结构修正的强度
- 此前两个分支的结果直接相加:
内部结果=原模型结果+长度修正+结构修正 - 进一步考虑到不同长度条件下,结构信息的作用强度可能不同,因此增加一个由长度决定的权重
g(L):内部结果=原模型结果+长度修正+g(L)×结构修正
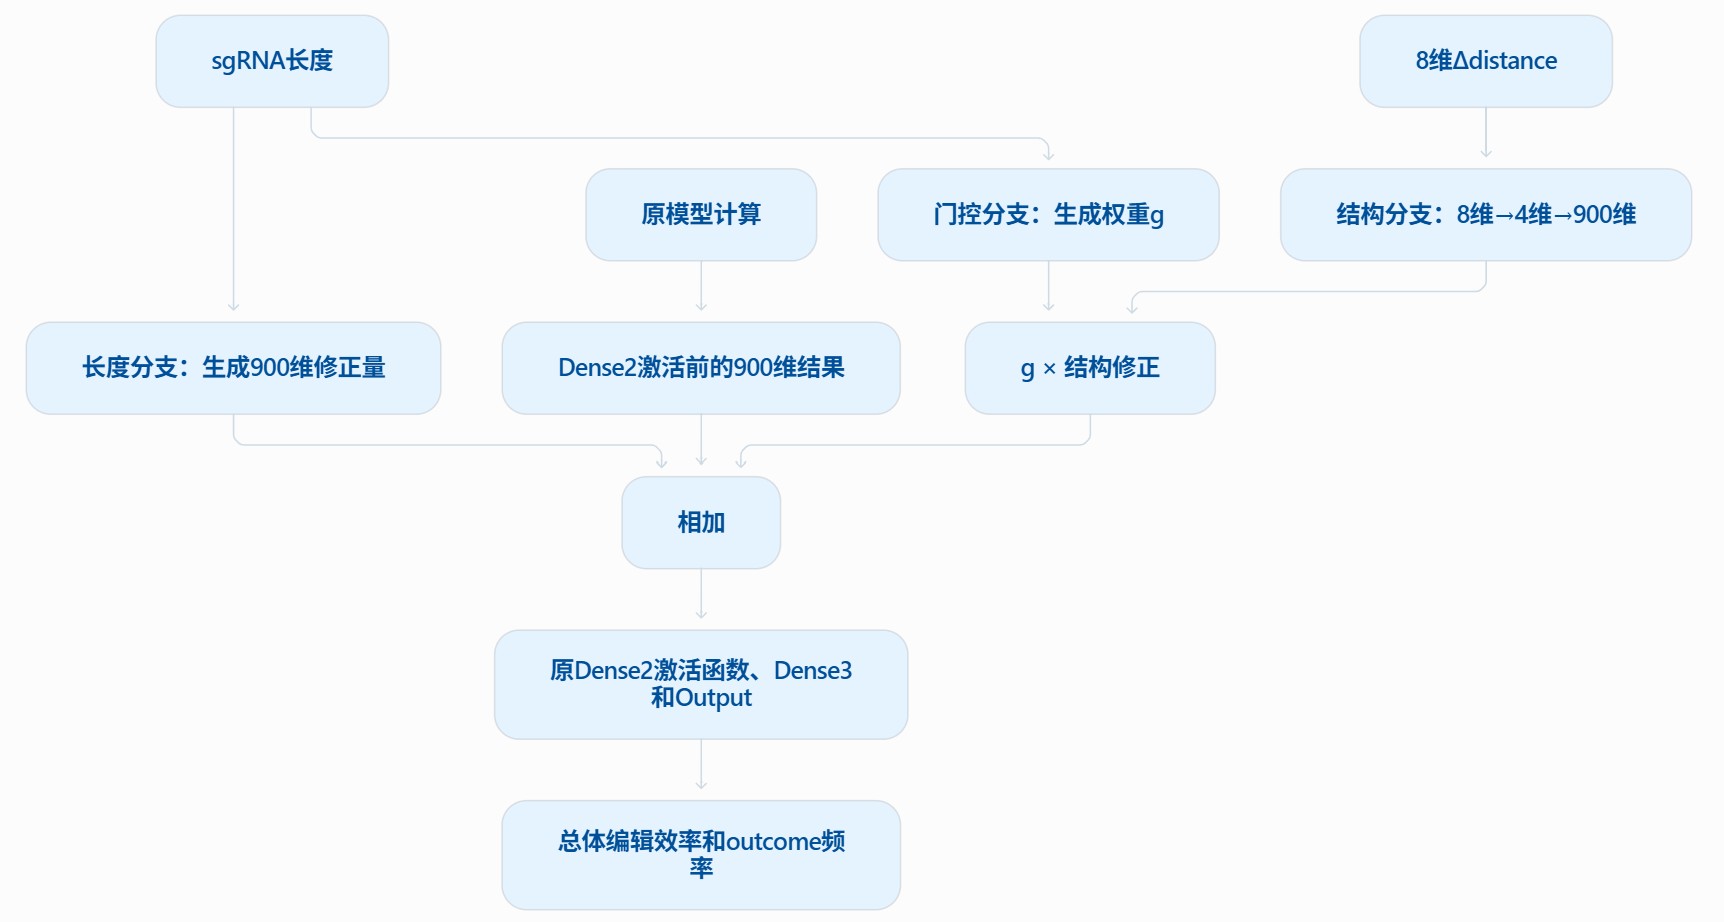
- 门控只输出一个数,用它统一调节900维结构修正:
g<1:减弱结构修正g=1:保持原来的修正强度g>1:增强结构修正
- 具体采用g(L)=1+tanh(wLstd+b),只增加一个权重和一个偏置,避免在小样本下引入过多参数
| 评价层级 | Length Pearson | 门控模型Pearson | Length MAE | 门控模型MAE |
|---|---|---|---|---|
| 总体编辑效率 | 0.691 | 0.676 | 11.688 | 11.910 |
| Outcome频率 | 0.663 | 0.678 | 2.767 | 2.725 |
| 位置效率 | 0.712 | 0.728 | 17.076 | 16.725 |
| 模型 | 二维Pearson R₂ | 二维Spearman ρ₂ |
|---|---|---|
| 原模型 | 0.2550 | 0.3010 |
| Length | 0.6725 | 0.6411 |
| Additive Δdistance | 0.6663 | 0.6484 |
| Gated Δdistance | 0.6668 | 0.6482 |
| 长度条件 | Gate均值 | 标准差 |
|---|---|---|
| L20 | 1.013 | 0.079 |
| L18/19 | 1.125 | 0.169 |
| L16/17 | 1.214 | 0.269 |
- 门控模型改善了outcome频率和位置效率,但总体编辑效率略有下降
- 与直接相加的Δdistance模型相比,额外提升也很有限,二维联合评价结果几乎相同
- 平均门控权重随长度下降而增加,说明模型平均给更短sgRNA的结构修正更大权重
总结:
- sgRNA长度是扩展短sgRNA预测时必须考虑的信息:原模型对同一DNA序列的不同长度条件无法加以区分,而加入长度后,无论采用简单回归、位置监督迁移还是outcome监督迁移,均明显降低了总体误差
- 16nt条件下DNA双链距离普遍下降,同一长度下还存在靶点间差异
- 将结构表示从绝对距离改为相对同一靶点20nt状态的Δdistance后,能够在保留长度效应的基础上获得小幅预测增益
- 保留预训练outcome任务、仅训练小型内部修正分支,是本研究在现有数据规模下较有效的扩展方式
- 直接替换为位置回归头、较大范围微调和重新建立位置预测头均未超过原对照;保留原有输出和聚合关系则能较好利用已有模型
- 多模型集成减少了部分单模型波动,门控机制又以极少新增参数表达了长度对结构修正强度的调节
- 当前结论仍受样本量和评价设计限制。独立靶点只有12个,多种模型设计也在这批数据上反复探索,因而留一交叉验证仍不能替代最终锁定方案后的独立测试
- 当前分析集中于A3–A10及本轮三组长度,不能直接外推到14/15nt、更宽编辑窗口、其他编辑器或其他实验体系。现有结果也没有直接证明stand-by或脱靶减少,更没有建立AF3结构变化与编辑结果之间的因果关系
结果图以及正文
# distance
bash /public/home/GENE_proc/wth/crispron-BE/scripts/abe8e_distance_only/run_distance_only.sh test  # /public/home/GENE_proc/wth/crispron-BE/results/ABE8e_transfer_model/distance_only_single_test/
bash /public/home/GENE_proc/wth/crispron-BE/scripts/abe8e_distance_only/run_distance_only.sh all  # /public/home/GENE_proc/wth/crispron-BE/results/ABE8e_transfer_model/distance_only_25_backbones
# Δdistance
bash /public/home/GENE_proc/wth/crispron-BE/scripts/abe8e_delta_only/run_structure_single_test.sh delta  # /public/home/GENE_proc/wth/crispron-BE/results/ABE8e_transfer_model/delta_only_single_test/
bash /public/home/GENE_proc/wth/crispron-BE/scripts/abe8e_delta_only/run_structure_13models.sh delta
bash /public/home/GENE_proc/wth/crispron-BE/scripts/abe8e_delta_only/run_structure_12models.sh delta
bash /public/home/GENE_proc/wth/crispron-BE/scripts/abe8e_delta_only/summarize_structure_25models.sh delta  # /public/home/GENE_proc/wth/crispron-BE/results/ABE8e_transfer_model/delta_only_25_backbones/summary
bash /public/home/GENE_proc/wth/crispron-BE/scripts/abe8e_length_distance/run_length_distance_13models.sh
bash /public/home/GENE_proc/wth/crispron-BE/scripts/abe8e_length_distance/run_length_distance_12models.sh
bash /public/home/GENE_proc/wth/crispron-BE/scripts/abe8e_length_distance/summarize_length_distance.sh
# /public/home/GENE_proc/wth/crispron-BE/results/ABE8e_transfer_model/length_distance_25_backbones
# /public/home/GENE_proc/wth/crispron-BE/results/ABE8e_transfer_model/final_length_distance_25ensemble/
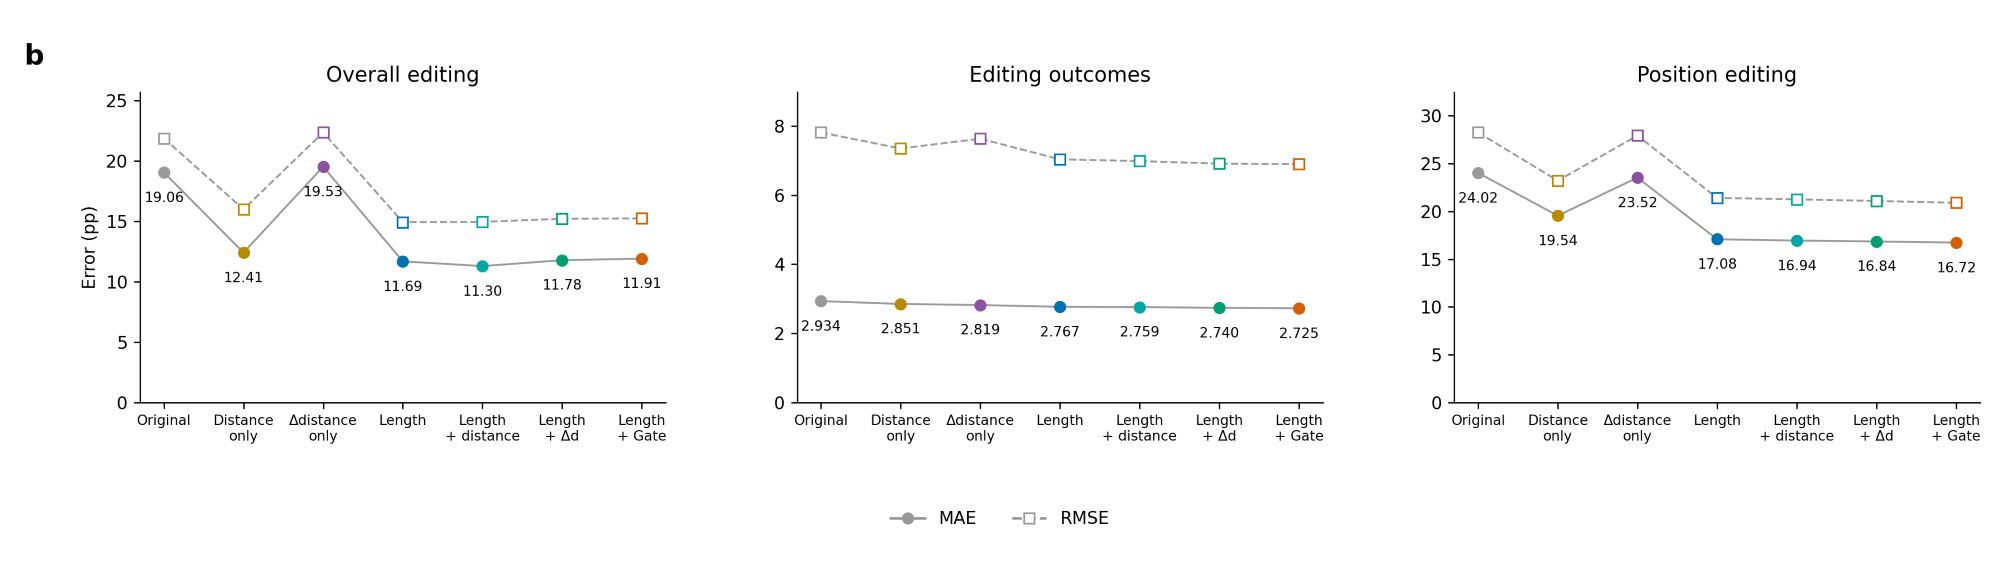
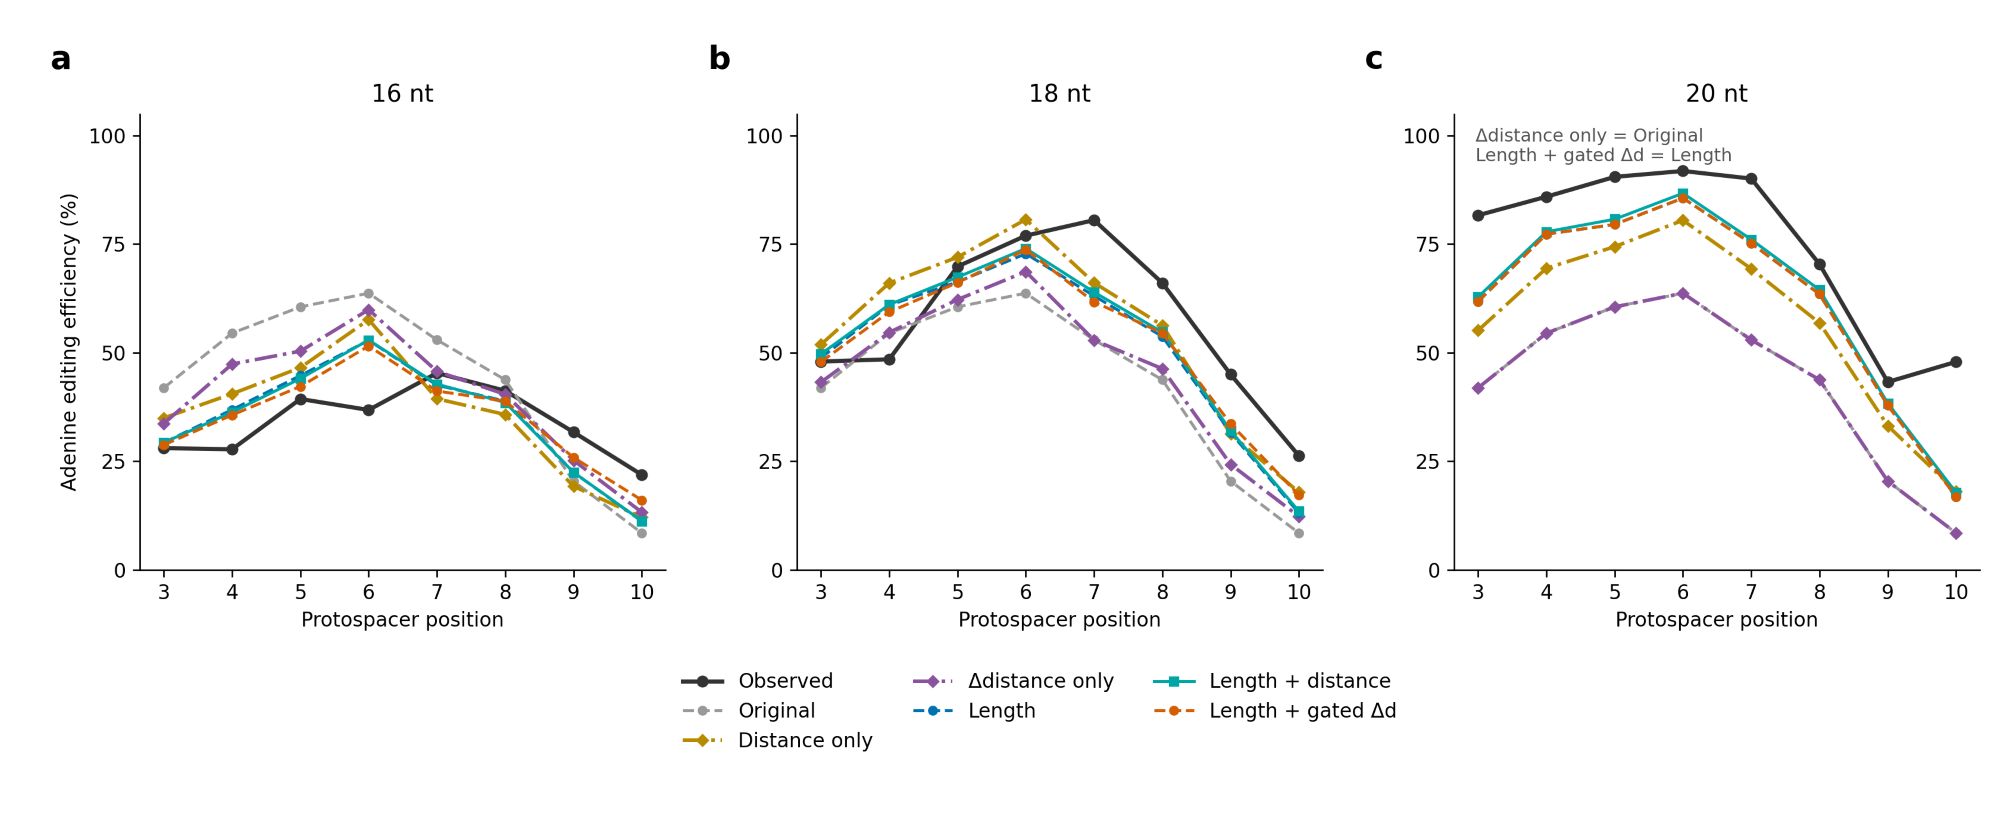
bash /public/home/GENE_proc/wth/crispron-BE/scripts/ABE8e_holdout2/run_part1.sh
bash /public/home/GENE_proc/wth/crispron-BE/scripts/ABE8e_holdout2/run_part2.sh
bash /public/home/GENE_proc/wth/crispron-BE/scripts/ABE8e_holdout2/run_part3.sh
# /public/home/GENE_proc/wth/crispron-BE/results/ABE8e_transfer_model/holdout2_25_backbones/summary/
| 模型 | 总体编辑效率 | Outcome频率 | 位置编辑效率 |
|---|---|---|---|
| Original | 19.571 | 1.400 | 17.748 |
| 仅distance | 11.497 | 1.372 | 15.076 |
| 仅Δdistance | 19.766 | 1.372 | 17.862 |
| Length | 10.292 | 1.380 | 15.187 |
| Length+Δdistance | 11.060 | 1.380 | 15.626 |
| Length+gated Δdistance | 11.082 | 1.380 | 15.585 |
- Length明显改善了总体效率和位置效率预测,仅distance也有改善
- 两个联合模型的总体效率和位置MAE均略高于Length,outcome MAE差异很小,没有显示结构分支在Length基础上的明确优势
| 评价层级 | 之前Length | 之前门控模型 | 这次Length | 这次门控模型 |
|---|---|---|---|---|
| 总体编辑效率 | 11.688 | 11.910 | 10.292 | 11.082 |
| Outcome频率 | 2.767 | 2.725 | 1.380 | 1.380 |
| 位置编辑效率 | 17.076 | 16.725 | 15.187 | 15.585 |
- 总体编辑效率:两次都是Length更好。之前加入门控后MAE增加0.222,这次增加0.790,方向一致
- Outcome频率:之前小幅改善,这次基本持平。之前MAE降低0.042,约1.5%;这次保留三位小数后没有差异
- 位置编辑效率:之前小幅改善,这次略有变差。之前降低0.351,约2.1%;这次增加0.398,约2.6%
- 所以,之前的结构增益本来就比较小。换成两个特定target后,出现持平或反向变化,并不奇怪
- 为什么这次很多MAE更低,却不能说模型整体更好了:
- 因为评价对象换了,一个直接证据是:Original没有重新训练,但它的outcome MAE也从之前的2.934降到了这次的1.400。这主要反映测试集组成发生了变化
- Outcome MAE还受各target的产物数量及频率分布影响。例如,包含大量低频产物的靶点,即使少数主要产物预测不准,逐条outcome平均后的MAE也可能较低。因此,这次1.380和之前2.767不能直接用来判断哪种训练方式更好
不同的distance定义
| 特征 | 计算方式 | 主要描述什么 |
|---|---|---|
| 互补位置C1′距离(原来使用的定义) | 第i位C1′到另一DNA链原配对位置C1′的距离 | 原配对碱基在空间中分开多远 |
| 最近C1′距离(新的主要目标) | 第i位C1′到另一DNA链所有C1′的最小距离 | 该糖环与另一DNA链最近糖环的间隔 |
| C1′到最近碳原子距离 | 第i位C1′到另一DNA链全部碳原子的最小距离 | 固定糖环参考点到另一链的最近碳原子间隔 |
| 核苷酸最近碳原子距离 | 第i个核苷酸全部碳原子与另一DNA链全部碳原子之间的最小距离 | 该核苷酸与另一链的最近碳原子接触距离 |
我们之前的AF3预测考虑了什么条件:
| 项目 | 我的AF3预测 | structure AF3.zip |
|---|---|---|
| 蛋白输入 | 1367aa的Cas9序列 | 1367aa的Cas9序列 |
| sgRNA输入 | 114nt,包含spacer和scaffold | 90–96nt,包含spacer和scaffold |
| DNA输入 | 两条60nt的互补DNA | 两条50nt的互补DNA |
| 覆盖条件 | - | 同一套DNA的14–20nt共7种guide长度 |
| 是否含完整TadA–Cas9融合编辑器 | 未包含 | 未包含 |
| 是否区分三种编辑器构建体 | 未区分 | 未区分 |
- 如果三种碱基编辑器的cas9不同,也许需要另外两种编辑器的cas9序列
- 以下结果基于ABE8e(原有数据)来做
module load miniconda3/base
conda activate crispronbe
cd /public/home/GENE_proc/wth/crispron-BE
python scripts/extract_four_distances.py \
    --input data/ABE8e_short_sgRNA/af3_target_zips/primary \
    --outdir data/ABE8e_short_sgRNA/af3_four_distances
结果 |
-
四种distance的总体变化:L16_17组在靶区前中部的链间距离总体较小,L18_19和L20较接近
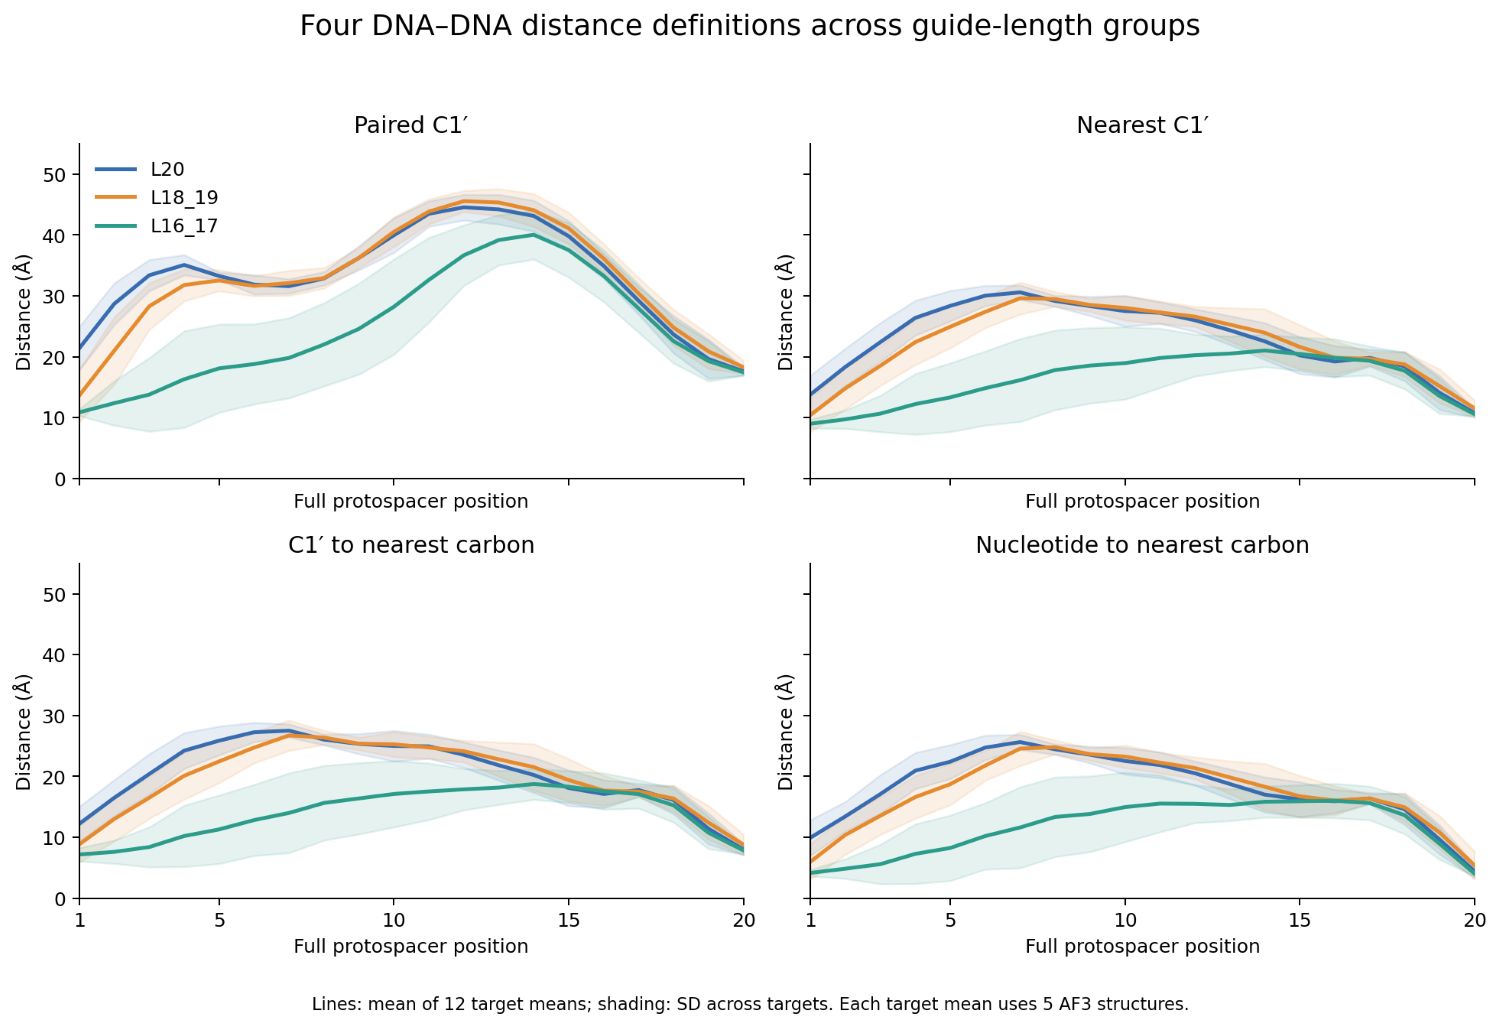
每条线先对同一条件的5个结构取均值,再对12个target等权平均;阴影表示不同target之间的SD
-
不同target的最近C1′距离:相同长度组下,不同target的曲线并不相同。例如ABE8、CS1P的最短组与较长组差别明显,而sgANGPTL3-A6的三条曲线较接近,因此,distance包含一定的target相关变化
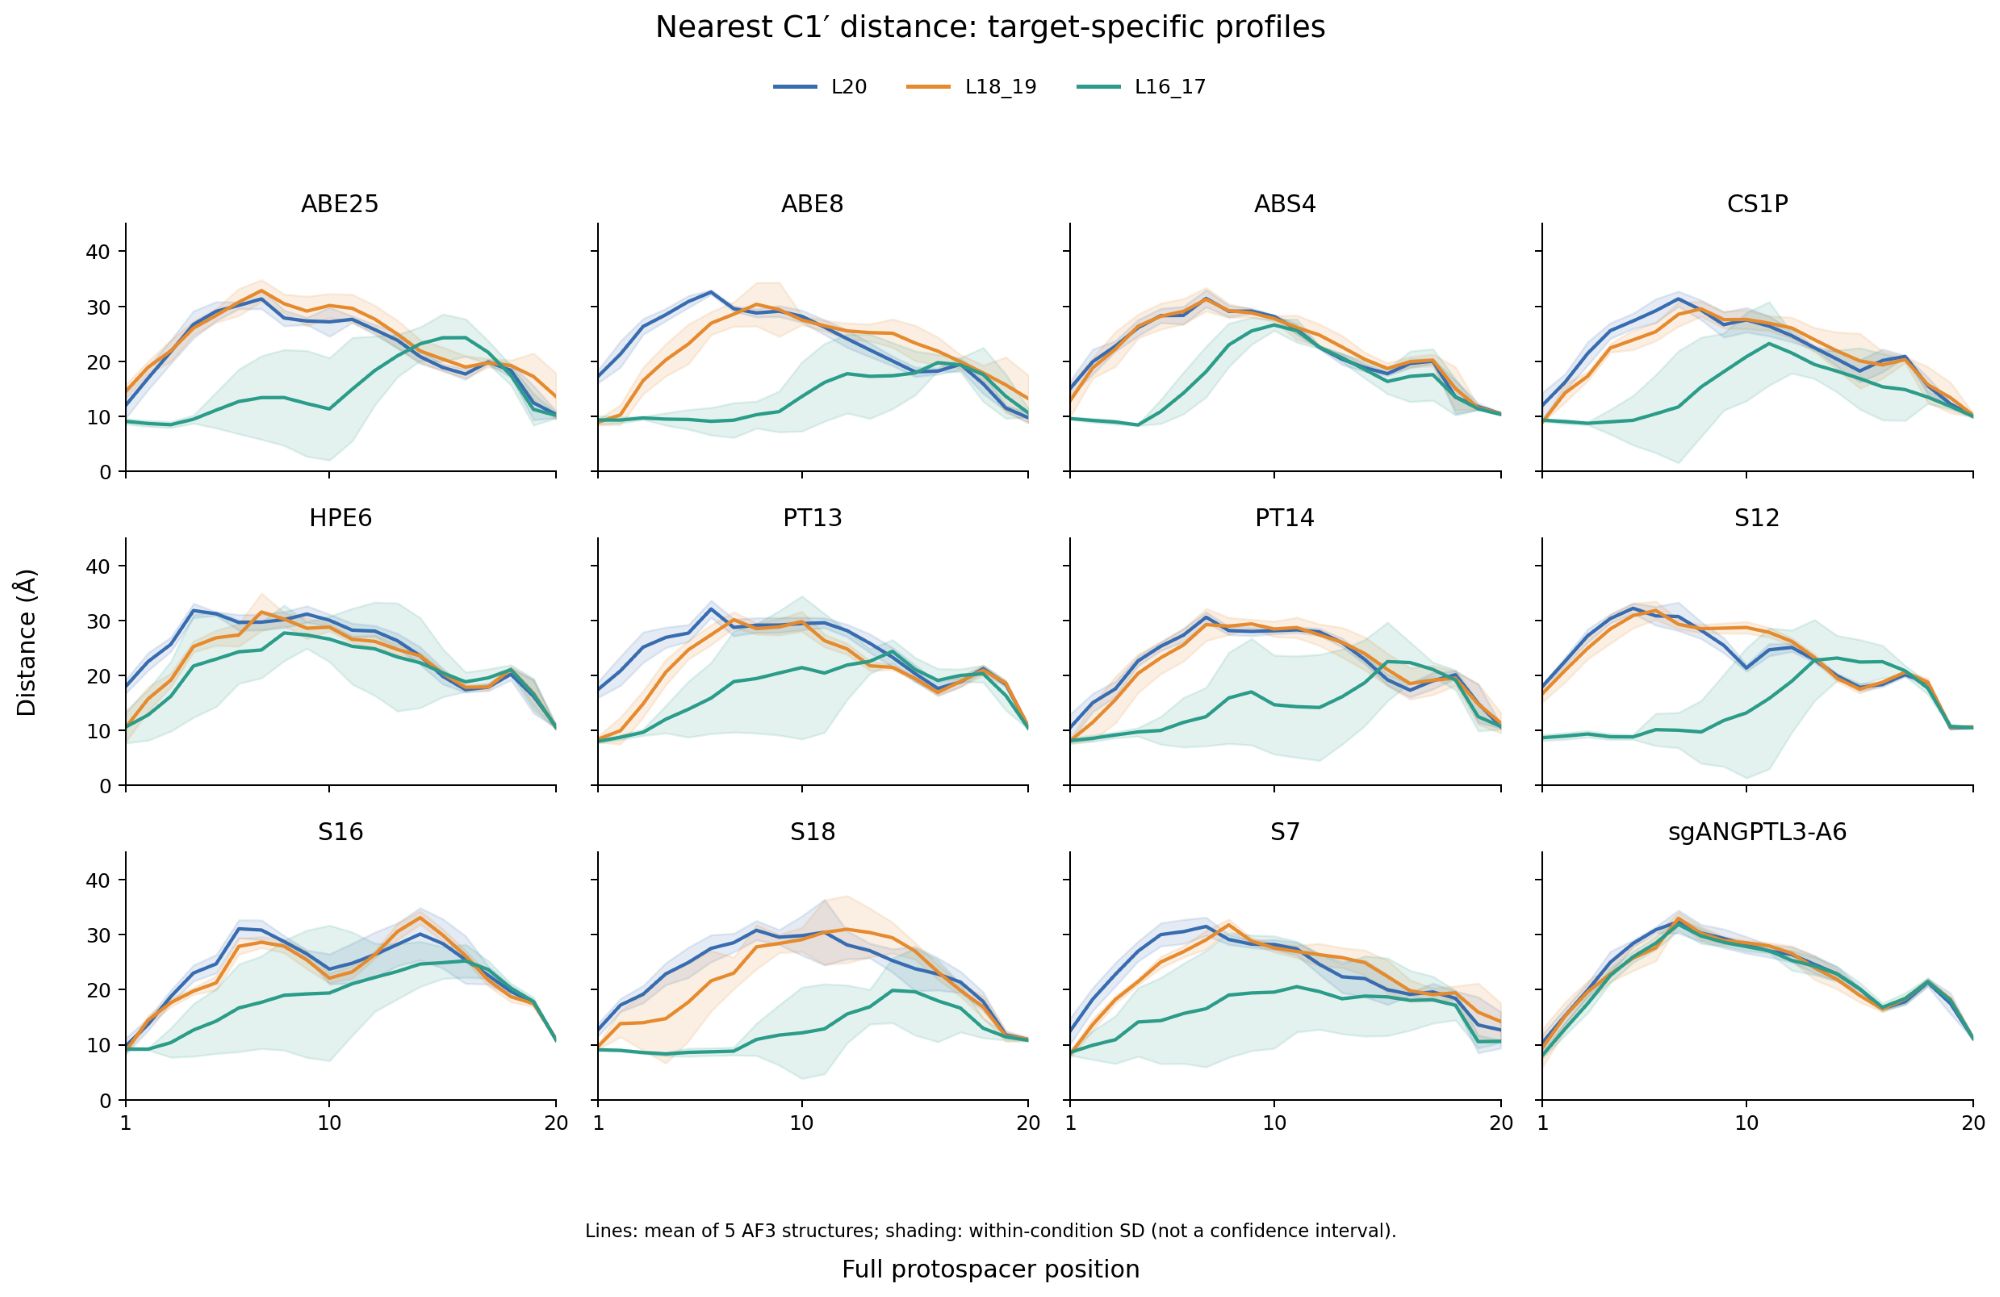
每个小图对应一个target,阴影表示同一条件5个AF3结构之间的SD
-
四种distance的信息是否重复:三种最近距离在当前数据中提供的信息高度重叠;原配对距离与最近距离描述的空间关系存在差别,值得分别比较
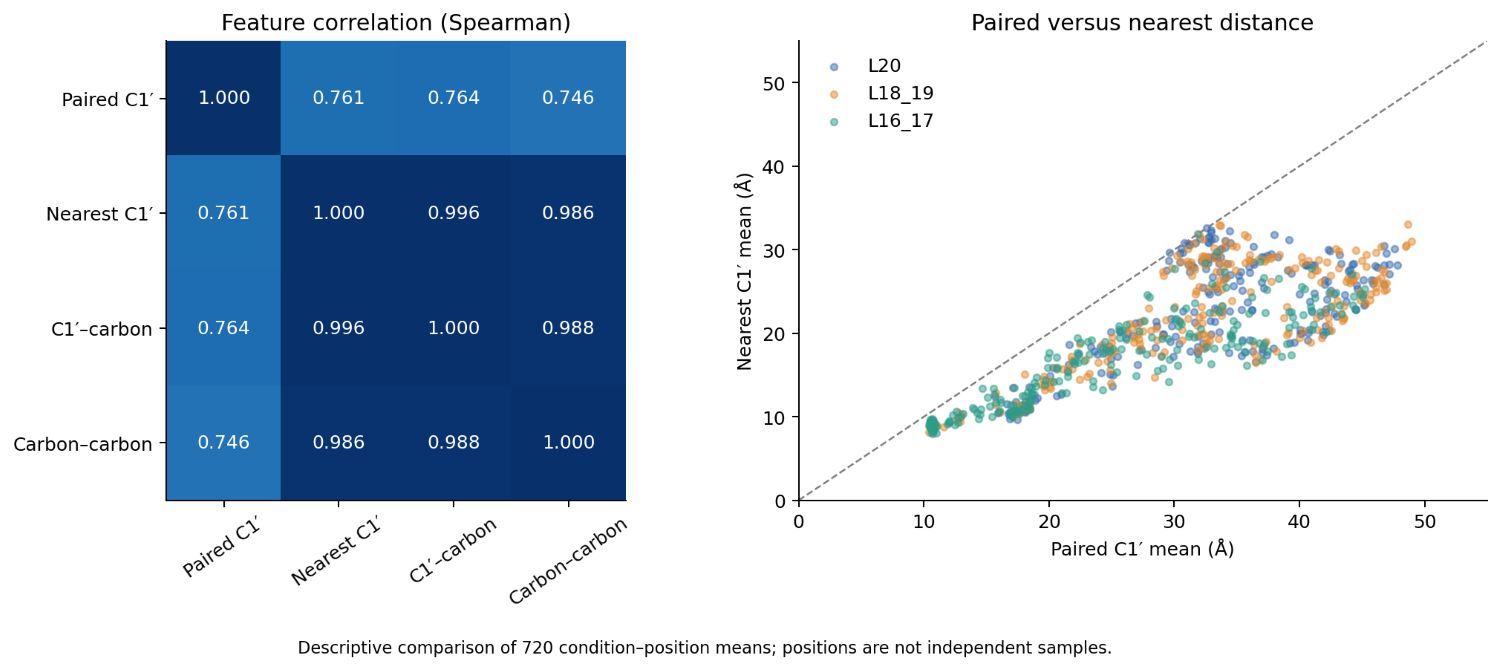
Spearman相关系数为0.986–0.996;原配对距离与三种最近距离的相关系数为0.746–0.764
-
短guide条件的结构间变异更大
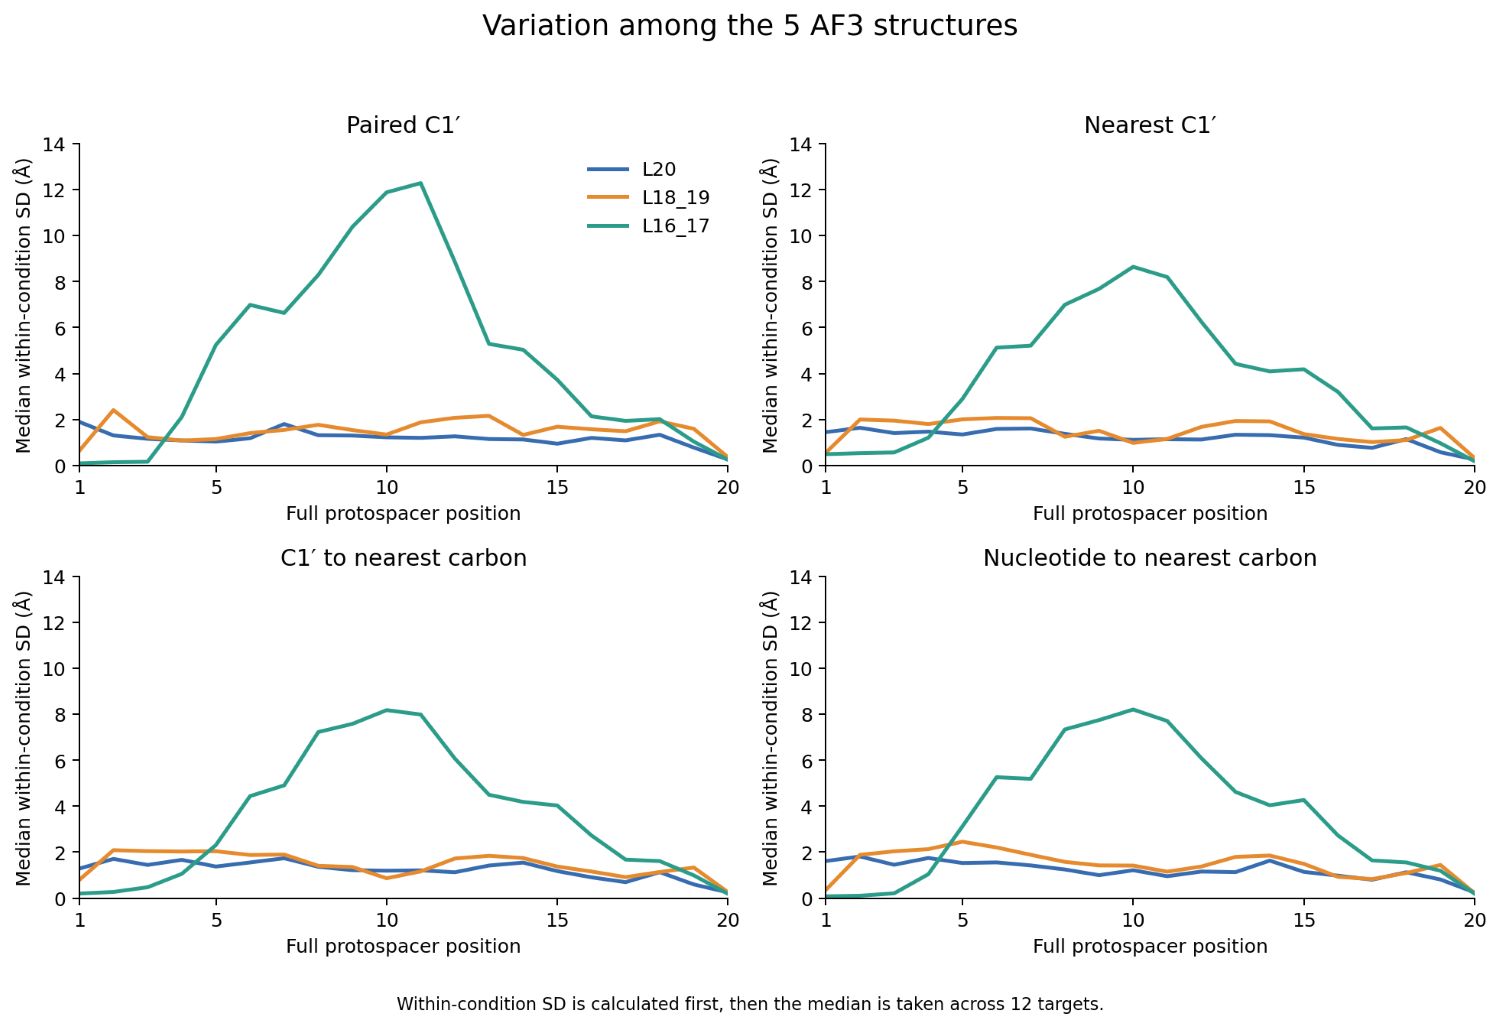
先计算每个条件5个结构之间的SD,再对12个target取中位数
加碱基编辑器种类 try1
先进行特征选择,看看在三种碱基编辑器中哪种distance最能体现差异:代码
module load miniconda3/base
conda activate crispronbe
cd /public/home/GENE_proc/wth/crispron-BE
# ABE8e
bash scripts/ABE8e_distance_feature_selection/run_abe8e.sh \
    scripts/ABE8e_distance_feature_selection/outcomes_reference_20260826.tsv \
    data/ABE8e_short_sgRNA/af3_four_distances/distance_per_model.tsv \
    data/ABE8e_short_sgRNA/af3_four_distances/structure_audit.tsv \
    res/ABE8e_distance_feature_selection
# TeABE
bash scripts/multi_editor_distance_selection/run_TeABE.sh \
    data/ABE8e_short_sgRNA/af3_four_distances/distance_per_model.tsv \
    data/ABE8e_short_sgRNA/af3_four_distances/structure_audit.tsv \
    res/TeABE_distance_feature_selection
# D699
bash scripts/multi_editor_distance_selection/run_D699.sh \
    data/ABE8e_short_sgRNA/af3_four_distances/distance_per_model.tsv \
    data/ABE8e_short_sgRNA/af3_four_distances/structure_audit.tsv \
    res/D699_distance_feature_selection
# 汇总
python scripts/multi_editor_distance_selection/compare_editors.py \
    --results \
    ABE8e=res/ABE8e_distance_feature_selection \
    TeABE=res/TeABE_distance_feature_selection \
    D699=res/D699_distance_feature_selection \
    --outdir res/editor_distance_comparison
-
整体MAE:三种编辑器都是原配对距离最低,原配对距离与最近C1′距离的差距都不大
输入特征 ABE8e TeABE D699 无distance基线 6.938 2.021 6.283 原配对C1′距离 6.315 1.782 5.812 最近C1′距离 6.342 1.806 5.877 C1′到最近碳原子 6.343 1.874 6.035 核苷酸最近碳原子 6.447 1.952 6.254 原配对Δdistance 6.735 1.962 6.295 最近C1′Δdistance 6.632 1.948 6.299 C1′到最近碳原子Δdistance 6.714 2.006 6.311 核苷酸最近碳原子Δdistance 6.676 1.917 6.375 原配对距离相对各自基线的MAE降低:
编辑器 MAE降低 相对降低 改善的target数 ABE8e 0.622个百分点 8.97% 10/12 TeABE 0.239个百分点 11.82% 10/12 D699 0.470个百分点 7.49% 8/12 -
各编辑器的选择确实不同,但稳定性有限
-
各外层fold内部,根据训练target的内层验证选择特征,结果如下:
内层选择的特征 ABE8e TeABE D699 无distance基线 0 1 0 原配对C1′距离 8 4 1 最近C1′距离 2 4 4 C1′到最近碳原子 1 0 6 核苷酸最近碳原子 1 3 1 任一种Δdistance 0 0 0 D699有6折选择“C1′到最近碳原子”,但该特征的整体外层MAE仍不如原配对距离。原因是:内层验证中领先的特征,不一定能在未见过的测试target上继续领先
-
“内层选择→外层预测”的改善幅度:
编辑器 基线MAE nested_selected的MAE相对降低 ABE8e 6.938 6.290 9.33% TeABE 2.021 1.960 3.00% D699 6.283 6.073 3.33% TeABE和D699的自动选择流程,改善明显小于事后查看所有外层结果后选出的最佳固定候选。这提示特征排序对训练target的组成较敏感
-
单个模型试运行:代码
module load miniconda3/base
conda activate crispronbe
cd /public/home/GENE_proc/wth/crispron-BE
bash scripts/editor_length_distance_nn/run_summarize_all.sh model_1_1
三种计算MAE的方式:
- outcome等权:把所有outcome行放在一起平均。因此,一个target包含的outcome越多,它对最终成绩的影响越大
- 靶点等权:先在每个条件内部平均outcome误差,再平均同一target的三个长度,最后平均12个target。因此,每个target对最终成绩的贡献都是1/12
- 真实频率加权:按outcome的真实频率加权
| 编辑器 | 模型 | outcome等权MAE | 靶点等权MAE | 真实频率加权MAE |
|---|---|---|---|---|
| ABE8e | original | 3.2522 | 5.1524 | 20.0830 |
| ABE8e | length-only | 2.9403 | 4.7047 | 19.4516 |
| ABE8e | length+absolute paired | 2.9777 | 4.7694 | 19.8413 |
| ABE8e | length+absolute nearest | 2.9995 | 5.0017 | 20.4446 |
| ABE8e | length+Δpaired | 2.8930 | 4.6138 | 19.5473 |
| ABE8e | length+gated Δpaired | 2.8857 | 4.6055 | 19.5128 |
| ABE8e | length+Δnearest | 2.8707 | 4.5682 | 19.5167 |
| ABE8e | length+gated Δnearest | 2.9191 | 4.6411 | 19.7058 |
| ABE8e | 全零基线 | 2.8205 | 6.0009 | 30.3378 |
| TeABE | original | 3.7656 | 6.5518 | 13.4452 |
| TeABE | length-only | 1.7990 | 3.1431 | 11.3417 |
| TeABE | length+absolute paired | 1.7911 | 3.1348 | 11.3354 |
| TeABE | length+absolute nearest | 1.7036 | 2.9691 | 10.8989 |
| TeABE | length+Δpaired | 1.6976 | 3.0179 | 11.0192 |
| TeABE | length+gated Δpaired | 1.7302 | 2.9965 | 11.1186 |
| TeABE | length+Δnearest | 1.6744 | 2.8864 | 10.7108 |
| TeABE | length+gated Δnearest | 1.6786 | 2.8708 | 10.7683 |
| TeABE | 全零基线 | 0.9911 | 1.6847 | 13.4828 |
| D699 | original | 3.5015 | 6.4792 | 18.7656 |
| D699 | length-only | 2.5341 | 4.5681 | 16.8163 |
| D699 | length+absolute paired | 2.5239 | 4.5558 | 16.7830 |
| D699 | length+absolute nearest | 2.5132 | 4.5300 | 16.7882 |
| D699 | length+Δpaired | 2.4514 | 4.4484 | 16.7412 |
| D699 | length+gated Δpaired | 2.4748 | 4.4913 | 16.9212 |
| D699 | length+Δnearest | 2.4256 | 4.4440 | 16.7729 |
| D699 | length+gated Δnearest | 2.4765 | 4.4780 | 16.7601 |
| D699 | 全零基线 | 2.3138 | 5.2030 | 24.1287 |
目前TeABE的Δnearest改善最明确,相对length-only,靶点等权MAE降低8.17%,真实频率加权MAE降低5.56%;ABE8e和D699的收益较小,Gate也没有一致优势
25模型运行:
# 旧版
cd /public/home/GENE_proc/wth/crispron-BE/scripts/editor_nn_25_sbatch9
for job in *.sbatch; do
    sbatch "$job"  # /public/home/GENE_proc/wth/crispron-BE/res/editor_length_distance_nn/clean/ABE8e
done
cd /public/home/GENE_proc/wth/crispron-BE/
module load miniconda3/base
conda activate crispronbe
python scripts/editor_nn_metric_alignment/summarize_25.py \
  --input res/editor_length_distance_nn/clean \
  --mode all \
  --outdir res/editor_length_distance_nn/summary_25_new_metrics
# 新版
cd /public/home/GENE_proc/wth/crispron-BE/scripts/editor_nn_paper_joint/sbatch/
bash scripts/editor_nn_paper_joint/submit_15.sh all  # /public/home/GENE_proc/wth/crispron-BE/res/editor_nn_paper_joint/clean/ABE8e/
python scripts/editor_nn_paper_joint/summarize_25.py --mode all
| 设置 | 旧版 | 新版(模仿原论文) |
|---|---|---|
| 监督目标 | outcome频率 | 总体效率+outcome频率 |
| 损失聚合 | 条件内平均,再平均条件 | outcome行等权、两个输出等权 |
| checkpoint | 验证outcome MAE最低 | 验证原始联合MSE最低 |
| 学习率 | 默认0.001 | 0.0001 |
| 最大epoch/patience | 400/40 | 2000/100 |
| 正则及范围惩罚 | 有 | 无 |
| 初始模型epoch0 | 可被选中 | 不参与选择 |
针对MAE的问题,gpt说即使频率加起来等于100也不影响MAE的统计功效(因为使用了绝对值),推荐了TV(总变差距离,total variation distance)这种方法,预测的整个产物分布与真实分布相差多少
- 可以直观地解释为:要把预测比例调整到真实比例,至少需要重新分配多少比例
假设某个“target×长度×编辑器”条件中,有三种编辑产物:
| 类别 | 真实频率 | 预测频率 | 绝对误差 |
|---|---|---|---|
| 产物A | 40% | 30% | 10个百分点 |
| 产物B | 15% | 30% | 15个百分点 |
| 产物C | 5% | 10% | 5个百分点 |
| 补足项 | 40% | 30% | 10个百分点 |
| 合计 | 100% | 100% | 40个百分点 |
- 前三种真实频率之和为60%,所以真实补足项为40%;预测频率之和为70%,所以预测补足项为30%,于是TV=1/2(10+15+5+10)=20个百分点
- 这里的20表示整个分布需要重新分配的比例,不是每种产物平均误差20个百分点,也不能直接解释成20%的测序reads被预测错误
类似于MAE,但忽略样本总数(outcome总数)的影响:
- 避免MAE因类别数量增加而被稀释:上例的完整分布MAE为40/4=10个百分点。如果增加6个真实和预测都为0的类别,MAE会降到40/10=4个百分点,但分布实际上没有改善,V仍为20个百分点
- 同时保留编辑总量和各产物比例的信息:上述结果中的“补足项”就是
100%-编辑效率,因此模型把总编辑比例预测得过高或过低,也会影响TV - 能评价错误预测出来的产物:真实频率为0、预测频率大于0时,TV仍会计入误差,此前的真实频率加权MAE会给这种产物0权重
TV值:
| 架构 | ABE8e旧版 | ABE8e新版 | TeABE旧版 | TeABE新版 | D699旧版 | D699新版 |
|---|---|---|---|---|---|---|
| Original | 58.5760 | 58.5760 | 88.0829 | 88.0829 | 67.6247 | 67.6247 |
| Length | 50.4515 | 50.4965 | 33.9617 | 36.1280 | 45.2214 | 47.6088 |
| Length+absolute paired | 49.9916 | 50.3677 | 33.4112 | 36.6014 | 44.9433 | 46.8256 |
| Length+absolute nearest | 49.8710 | 50.2661 | 32.8986 | 36.4666 | 45.2659 | 48.0022 |
| Length+Δpaired | 49.5764 | 51.4164 | 32.9906 | 33.0194 | 45.3667 | 46.0539 |
| Length+Δnearest | 49.9902 | 50.9683 | 33.0850 | 34.1941 | 44.9878 | 45.4380 |
| Length+gated Δpaired | 49.2542 | 51.1076 | 33.2142 | 32.8028 | 45.1836 | 45.7191 |
| Length+gated Δnearest | 49.7274 | 50.8534 | 32.7960 | 32.7449 | 44.6168 | 45.1102 |
没有哪个架构在所有指标上都最好:
| 编辑器 | 模型 | outcome等权MAE | 靶点等权MAE | 真实频率加权MAE | TV |
|---|---|---|---|---|---|
| ABE8e | Length | 2.9410 | 5.2898 | 20.9530 | 50.4965 |
| ABE8e | Length+absolute nearest | 2.9362 | 5.2966 | 20.9386 | 50.2661 |
| TeABE | Length | 1.7473 | 2.3761 | 11.6973 | 36.1280 |
| TeABE | Length+gated Δnearest | 1.5507 | 2.1606 | 11.5708 | 32.7449 |
| D699 | Length | 2.5322 | 4.3365 | 16.2972 | 47.6088 |
| D699 | Length+gated Δnearest | 2.4305 | 4.2534 | 16.1930 | 45.1102 |
如果按照原文的评估方式:
| 编辑器 | 联合R₂最高的模型 | R₂ | ρ₂ | 总体效率MAE |
|---|---|---|---|---|
| ABE8e | Length | 0.4884 | 0.6138 | 9.6896 |
| TeABE | Length+absolute nearest | 0.7326 | 0.5747 | 8.9227 |
| D699 | Length+gated Δnearest | 0.5898 | 0.6505 | 12.4272 |
基于上述结果,gpt推荐选用Length+Δnearest的方式
加碱基编辑器种类 try2
try1有一个bug就是只算了3-10的outcome,像TeABE这种编辑窗口靠后的误差就比较大
cd /public/home/GENE_proc/wth/crispron-BE
bash scripts/editor_full20_nn/submit_all.sh 5
TV值:
| 模型或基线 | ABE8e TV | TeABE TV | D699 TV |
|---|---|---|---|
| Length+Editor | 75.6907 | 87.0405 | 84.2446 |
| +absolute nearest | 75.4955 | 86.0747 | 84.2562 |
| +Δnearest | 75.8036 | 87.6904 | 83.7227 |
| 独立位点基线 | 71.2775 | 41.3229 | 56.4685 |
| 全0基线 | 78.9372 | 73.7169 | 65.1610 |
- 独立位点基线:先从训练数据中统计
某种编辑器、某个长度组下,每个A位置发生编辑的概率(就是把12个target的编辑情况汇总,作为模型的一部分定死),再假设这些位置之间相互独立,计算各种组合的概率 - 全0基线:假设所有结果都没有A→G,用来判断模型是否提供了有用的产物分布预测
- 三个神经网络原输出的TV都没有优于独立位点基线:网络没有准确分配后段编辑产物的概率。例如TeABE中,“第11–20位发生编辑,但第3–10位没有编辑”的真实平均比例为46.59%,Length原输出只预测了9.83%
据此gpt做了“独立Q(HΔ)”的修正:基于训练数据中各位置的编辑效率+预测出的总编辑比例,对模型生成的outcome频率做修正
-
例如我们的训练数据中
编辑器 长度组 位置 从训练数据估计的编辑概率 ABE8e 16/17nt A5 60% ABE8e 16/17nt A7 40% - 预测时,假设给一条全新的DNA,指定ABE8e和16nt条件,程序会这样做
- 读序列:发现第5和第7位是A,因此可能有“只编辑A5”“只编辑A7”“两个都编辑”等组合
- 读已有参数:从训练得到的表中,取出该编辑器、长度组对应的A5概率60%、A7概率40%
- 计算Q:按独立假设计算组合比例,得到47.37%、21.05%、31.58%
- 网络预测E:根据新序列、length、distance和编辑器预测总体效率,例如60%;再用E乘以Q,得到最终产物频率
- 感觉问题很大,首先现在的数据规模就没法统计出一个确定的“各位置的编辑效率”,其次这个相当于用正确答案去改错误答案
| 方案 | ABE8e TV | TeABE TV | D699 TV |
|---|---|---|---|
| Length原输出 | 75.6907 | 87.0405 | 84.2446 |
| 独立位点基线 | 71.2775 | 41.3229 | 56.4685 |
| H0:Length效率+独立Q | 61.8955 | 40.6270 | 52.8963 |
| absolute nearest效率+独立Q | 62.1724 | 41.2505 | 52.8173 |
| HΔ:Δnearest效率+独立Q | 61.6410 | 39.6938 | 51.4831 |
Δnearest到底贡献了多少:
| 编辑器 | H0 TV | HΔ TV | 加入Δnearest后的下降 |
|---|---|---|---|
| ABE8e | 61.8955 | 61.6410 | 0.2545个百分点 |
| TeABE | 40.6270 | 39.6938 | 0.9333个百分点 |
| D699 | 52.8963 | 51.4831 | 1.4132个百分点 |
进一步按长度看:
| 编辑器 | 16/17nt条件的TV下降 | 18/19nt条件的TV下降 | 20nt条件的TV下降 |
|---|---|---|---|
| ABE8e | +1.4496 | −0.6861 | 0 |
| TeABE | +1.3056 | +1.4942 | 0 |
| D699 | +2.7191 | +1.5204 | 0 |
基于上述结果,gpt推荐选用Length+Editor+Δnearest神经网络+HΔ修正的方式
| 编辑器 | outcome等权MAE | 靶点等权MAE | 真实频率加权MAE | TV | 总体效率MAE |
|---|---|---|---|---|---|
| ABE8e | 0.2395 | 0.3154 | 10.8290 | 61.6410 | 11.1058 |
| TeABE | 0.1453 | 0.1893 | 10.5920 | 39.6938 | 11.3496 |
| D699 | 0.1823 | 0.2367 | 15.1773 | 51.4831 | 17.5894 |
| 编辑器 | 联合R₂ | 联合ρ₂ | outcome Pearson | outcome Spearman |
|---|---|---|---|---|
| ABE8e | 0.6507 | 0.6388 | 0.4300 | 0.5754 |
| TeABE | 0.8149 | 0.6756 | 0.7042 | 0.6020 |
| D699 | 0.7203 | 0.6707 | 0.5640 | 0.5447 |
加碱基编辑器种类 try3
最终决定:延续3-10的编辑窗口,只预测ABE8e和D699,选Length+Δnearest,评估指标一个是原文的R₂+ρ₂(综合看总编辑效率+outcome频率),一个是outcome的MAE或total variation distance,评估时用LOTO(12轮每轮单拿出一个作测试集,最终汇总),最终模型用全部12个target一起做训练集
- 加一步迁移,将预测结果迁移映射到第三种编辑器,也就是说这部分不作为主模型训练,而作为模型对其他编辑器的延伸应用。因此这部分结果不参与主结果和原模型的对比,仅作为延伸结果在最后面单独讲一下
迁移映射:固定ABE8e/D699模型,再把它们的预测校准到TeABE
- 直接迁移:将两种源编辑器的预测固定等权平均,直接用于TeABE
- 效率校准:用TeABE训练target拟合效率映射,保留源网络的outcome比例
- HΔ式映射:校准后的效率乘以TeABE训练target估计的产物比例
| 量 | 含义 | 例子 |
|---|---|---|
| 编辑总量E | 全部reads中,所选窗口内至少有一个A→G的比例 | 40%reads发生窗口内编辑 |
| 产物比例Qj | 已经发生窗口内编辑的reads中,第j种产物占多少 | 其中一半是“只编辑A5” |
| outcome频率pj | 全部reads中,第j种产物占多少 | 40%*50%=20% |
- p0=100-E,指窗口内没有A→G,其中仍可能存在窗口外编辑
-
直接迁移:直接使用两个源模型的平均预测
产物 ABE8e预测 D699预测 两者平均 只编辑A5 36% 24% 30% 只编辑A7 12% 28% 20% 同时编辑A5和A7 12% 8% 10% 窗口内没有编辑 40% 40% 40% 合计 100% 100% 100% 直接把最后一列作为TeABE的预测
- 检验的是:ABE8e/D699模型已经学到的序列、长度和结构规律,对TeABE是否有可直接复用的部分
- 效率校准:调整编辑总量,通常保留源网络预测的产物比例
- 上面源模型预测的三个非空产物频率为30%、20%、10%。把它们除以非空频率之和60%,得到Q源=(50%, 33.33%, 16.67%),其含义是
源模型认为,在已编辑产物中,“只编辑A5”最多,“同时编辑两个位置”最少 - 然后用TeABE训练target学习一个小型校准关系ETeABE=10+0.5E源 ,当源效率预测为60%时,校准后的TeABE效率就是40%。接着按原来的Q源分配这40%
产物 计算 校准后频率 只编辑A5 40×0.5 20.00% 只编辑A7 40×33.33% 13.33% 同时编辑两个位置 40×16.67% 6.67% 窗口内没有编辑 100-40 60.00% 三个编辑产物之间的比例仍为3∶2∶1,只是编辑总量从60%变成了40%
- 检验的是:源模型对TeABE的主要偏差,是否可以通过整体效率尺度校准解决
- 上面源模型预测的三个非空产物频率为30%、20%、10%。把它们除以非空频率之和60%,得到Q源=(50%, 33.33%, 16.67%),其含义是
- HΔ式映射:保留校准后的编辑总量,改用TeABE统计得到的产物比例
- TeABE可能不仅整体效率不同,编辑位置偏好也不同。例如,源网络更容易预测“只编辑A5”,但TeABE实验显示A7更常被编辑,整体缩放无法改变这种排序。因此,这一版本重新估计QTeABE
- 具体做法是:在相同长度组的TeABE训练target中,统计每个A位置的编辑概率。假设最终估计
- A5被编辑的概率为20%
- A7被编辑的概率为40%
-
按照位点独立假设:
产物 计算 独立模型概率 只编辑A5 20%×60% 12% 只编辑A7 80%×40% 32% 同时编辑两个位置 20%×40% 8% 窗口内没有编辑 80%×60% 48% 非空产物总和为52%。只取已经发生编辑之后的相对比例QTeABE=(12/52, 32/52, 8/52)=(23.08%, 61.54%, 15.38%)
- 再把同一个校准效率40%按这个新比例分配:pj=40×QTeABE, j
| 产物 | 直接迁移 | 效率校准 | HΔ式映射 |
|---|---|---|---|
| 只编辑A5 | 30.00% | 20.00% | 9.23% |
| 只编辑A7 | 20.00% | 13.33% | 24.62% |
| 同时编辑两个位置 | 10.00% | 6.67% | 6.15% |
| 窗口内没有编辑 | 40.00% | 60.00% | 60.00% |
| 合计 | 100% | 100% | 100% |
cd /public/home/GENE_proc/wth/crispron-BE
# 补跑新版训练的only distance
sbatch --array=0 scripts/editor_main_transfer_20261013/single_array.sbatch \
    --editor ABE8e --candidate single_nearest --epochs 2 --patience 1 \
    --result-root res/editor_main_transfer/smoke_single  # /public/home/GENE_proc/wth/crispron-BE/res/editor_main_transfer/singles/ABE8e
# 迁移
sbatch --array=0 scripts/editor_main_transfer_20261013/transfer_array.sbatch \
    --candidate delta_nearest --members model_1_1 \
    --result-root res/editor_main_transfer/smoke_transfer
# 汇总
module load miniconda3/base
conda activate crispronbe
python scripts/editor_main_transfer_20261013/summarize_plot.py
python scripts/editor_main_transfer_20261013/summarize_plot.py \
    --mode transfer --candidate delta_nearest --window 8
# 1-20
bash scripts/editor_main_transfer_20261013/submit_transfer.sh delta_nearest 20
python scripts/editor_main_transfer_20261013/summarize_plot.py \
    --mode transfer --candidate delta_nearest --window 20
| 模型 | MAE↓ | TV↓ | R₂↑ | ρ₂↑ |
|---|---|---|---|---|
| 原CRISPRon-ABE | 6.083 | 63.100 | 0.247 | 0.258 |
| Length | 4.813 | 49.053 | 0.532 | 0.623 |
| 单nearest | 5.429 | 55.330 | 0.470 | 0.477 |
| 单Δnearest | 5.279 | 54.272 | −0.003 | 0.132 |
| Length+Δnearest | 4.749 | 48.203 | 0.525 | 0.625 |
原模型→Length→Length+Δnearest这样是一个连续下降的过程- Length+Δnearest相对Length:
- 两编辑器平均MAE改善约1.34%,TV改善约1.73%
- ABE8e的8/12个target、D699的9/12个target出现MAE改善
- ABE8e的TV略变差,D699的TV改善;联合相关性也不是全部提高
| 方法 | 3–10位MAE | 3–10位TV | 1–20位MAE | 1–20位TV |
|---|---|---|---|---|
| 直接迁移 | 4.948 | 65.632 | 0.383 | 80.711 |
| 效率校准 | 3.221 | 31.398 | 0.407 | 78.904 |
| HΔ式映射 | 1.948 | 19.248 | 0.190 | 40.514 |
| Length来源的H0映射 | 1.950 | 19.268 | 0.189 | 40.468 |
| 仅TeABE训练位置统计 | 1.248 | 18.814 | 0.195 | 40.737 |
- 3–10位中,效率校准和产物重分配都降低了误差,但仅TeABE位置统计的平均MAE和TV优于HΔ。HΔ与H0也几乎相同。因此可以说“TeABE数据辅助校准改善了迁移预测”,目前不能强调“distance提高了第三种编辑器的预测”
- 20位中,HΔ相对统计参考的TV只改善0.223pp,并略差于H0;这些小差异的target bootstrap区间均跨0,尚无稳定增益的证据
- 20位直接迁移误差高:真实分布中平均70.57pp的频率来自含3–10位之外A→G的产物,而直接迁移和仅效率校准将这些类别预测为0
- 不能因为20位MAE只有0.19pp,就认为预测很准确:类别数从984增至16860,许多低频或零频率组合会稀释MAE;它的完整分布TV仍约40.5pp
加碱基编辑器种类 try4
现在的做法是“不重新训练模型,只是把原来3-10的结果经过各种数学方法处理后作为1-20的所有outcome的结果”,感觉还是之前重新训练1-20位模型的方法比较有“对原模型的编辑窗口进行扩展”的感觉
- 以已训练好的ABE8e/D699的Length+Δnearest模型为基础,冻结原有网络,只增加两个小型适配层,分别学习TeABE的编辑器/长度差异,以及3–10位之外的编辑组合信息
- 利用TeABE训练target的1–20位完整产物分布训练新增参数,再通过12折按target留一验证评估
cd /public/home/GENE_proc/wth/crispron-BE
bash scripts/teabe_full20_neural_transfer_20261014/submit_many.sh 25
# /public/home/GENE_proc/wth/crispron-BE/res/TeABE_full20_neural_transfer_20261014/source_delta_nearest/submissions/20261014_161514_76e755/logs/
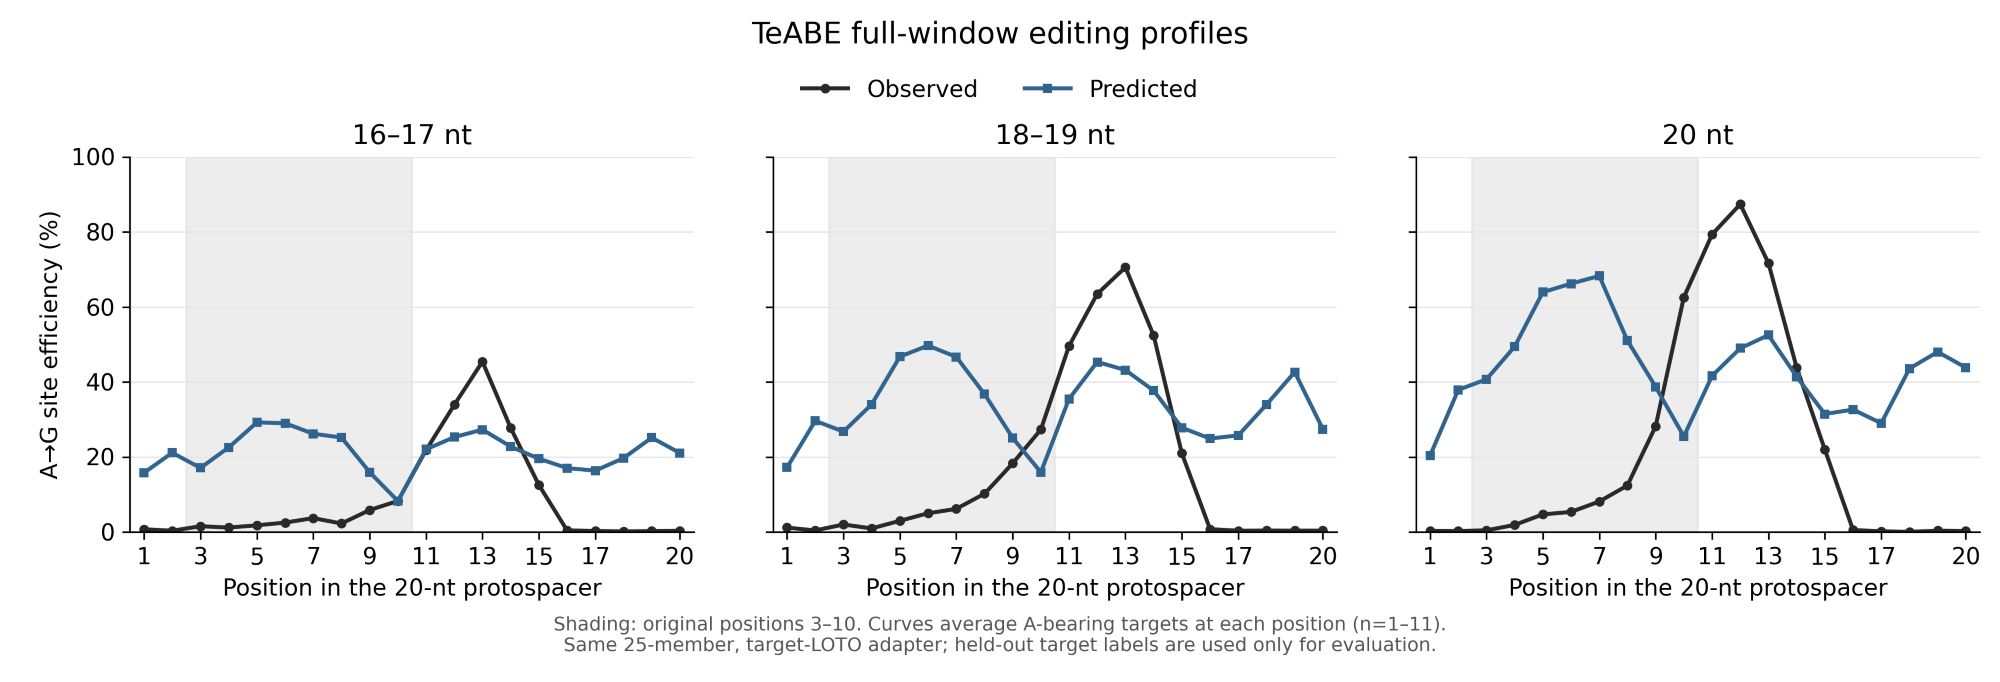
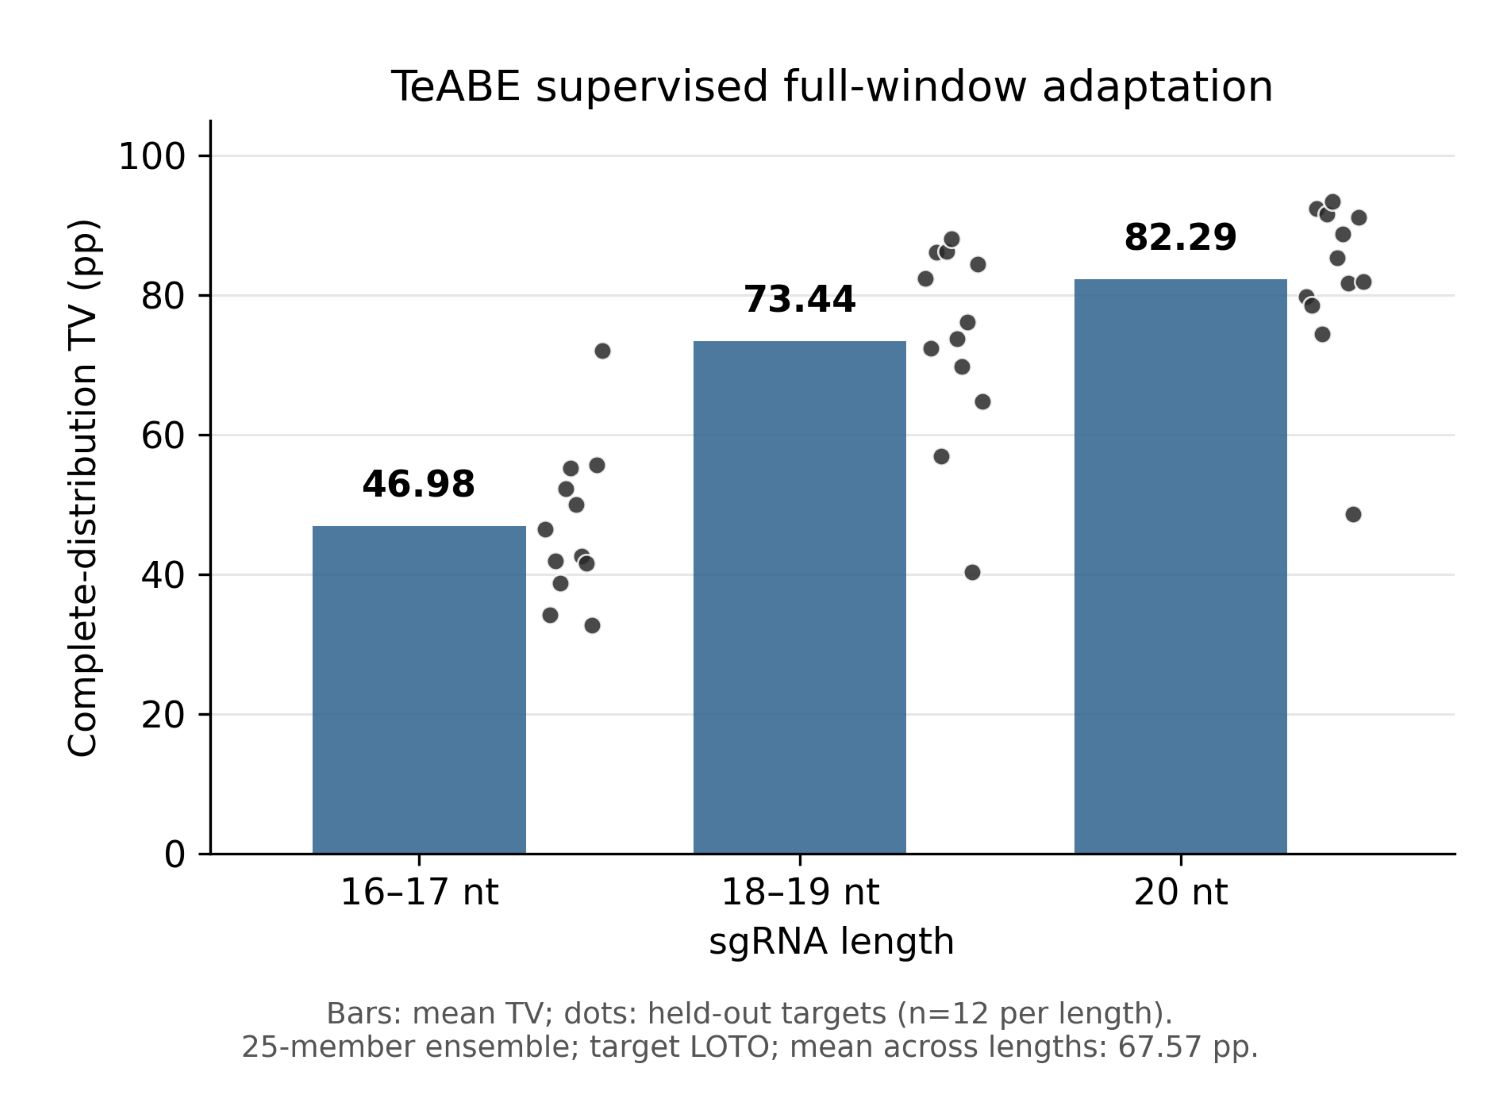
可以看到预测误差仍较大,说明现有模型的跨编辑器全窗口适配能力有限
上面的补充运行only是用的新版的训练,现在把旧版的也运行一下:代码 | 结果
cd /public/home/GENE_proc/wth/crispron-BE
bash scripts/editor_nn_old_singles_20261014/submit.sh ABE8e D699
# /public/home/GENE_proc/wth/crispron-BE/res/editor_length_distance_nn/
以下结果都选用nearest distance(第i位C1′到另一DNA链所有C1′的最小距离)
旧版训练方法(训练过程使用最早gpt推荐的评估方式,即只用outcome的MSE),总结果表里对应Legacy:
| 编辑器 | 模型 | R₂↑ | ρ₂↑ | MAE_out↓ | MAE_target↓ | TV↓ |
|---|---|---|---|---|---|---|
| ABE8e | 原CRISPRon-ABE | 0.299 | 0.293 | 3.454 | 5.512 | 58.576 |
| ABE8e | Length only | 0.316 | 0.371 | 2.919 | 5.146 | 50.452 |
| ABE8e | Distance only | 0.458 | 0.500 | 2.992 | 5.302 | 51.783 |
| ABE8e | Length+distance | 0.368 | 0.414 | 2.902 | 5.153 | 49.871 |
| ABE8e | Δdistance only | 0.377 | 0.387 | 2.986 | 4.764 | 51.409 |
| ABE8e | Length+Δdistance | 0.346 | 0.363 | 2.848 | 5.025 | 49.990 |
| D699 | 原CRISPRon-ABE | 0.195 | 0.224 | 3.641 | 6.655 | 67.625 |
| D699 | Length only | 0.415 | 0.546 | 2.407 | 4.337 | 45.221 |
| D699 | Distance only | 0.036 | 0.219 | 2.689 | 4.754 | 49.342 |
| D699 | Length+distance | 0.437 | 0.569 | 2.396 | 4.302 | 45.266 |
| D699 | Δdistance only | 0.312 | 0.424 | 2.774 | 5.290 | 50.001 |
| D699 | Length+Δdistance | 0.391 | 0.534 | 2.379 | 4.320 | 44.988 |
新版训练方法(按照原论文的评估方式,即同时考虑总体编辑效率+outcome的联合MSE),总结果表里对应Joint MSE:
| 编辑器 | 模型 | R₂↑ | ρ₂↑ | MAE_out↓ | MAE_target↓ | TV↓ |
|---|---|---|---|---|---|---|
| ABE8e | 原CRISPRon-ABE | 0.299 | 0.293 | 3.454 | 5.512 | 58.576 |
| ABE8e | Length only | 0.488 | 0.614 | 2.941 | 5.290 | 50.496 |
| ABE8e | Distance only | 0.437 | 0.499 | 3.083 | 5.638 | 53.169 |
| ABE8e | Length+distance | 0.474 | 0.611 | 2.936 | 5.297 | 50.266 |
| ABE8e | Δdistance only | -0.105 | 0.059 | 3.063 | 4.987 | 53.085 |
| ABE8e | Length+Δdistance | 0.464 | 0.596 | 2.913 | 5.225 | 50.968 |
| D699 | 原CRISPRon-ABE | 0.195 | 0.224 | 3.641 | 6.655 | 67.625 |
| D699 | Length only | 0.576 | 0.632 | 2.532 | 4.337 | 47.609 |
| D699 | Distance only | 0.504 | 0.455 | 3.057 | 5.220 | 57.491 |
| D699 | Length+distance | 0.572 | 0.613 | 2.550 | 4.376 | 48.002 |
| D699 | Δdistance only | 0.099 | 0.204 | 3.044 | 5.572 | 55.459 |
| D699 | Length+Δdistance | 0.586 | 0.654 | 2.444 | 4.272 | 45.438 |
- 旧版训练方法相当于集中关注outcome频率,因此R2和ρ2会较差一些;新版的MAE会略低于旧版(这几个MAE和TV主要衡量outcome频率的预测)
- R2是总编辑效率和outcome频率的综合MSE,ρ2是综合Spearman相关性
- MAE_out就是outcome的MAE(把所有outcome行放在一起平均),MAE_target就是先在每个条件内部平均outcome误差,再平均同一target的三个长度,最后平均12个target
- 总体来看D699的结果会比较稳定,新版Length+Δdistance在它的所有指标上都最低;在ABE8e中,R2和ρ2仅次于length only(约等于length+distance),outcome的MAE最低,target的MAE也仅次于Δdistance only
- 关于为什么ABE8e的length only在R2和ρ2中最优,这个尚不清楚,不过在之前看总编辑效率MAE的时候确实也是length only最好
- 总之想用新版的Length+Δdistance作为最终结果,然后展示图中比较原模型、length only、Δdistance only以及Length+Δdistance的R2和ρ2(对应原论文)+outcome的MAE
模型迁移new try
Gemini:先用距离模型估计20nt→18nt的效率变化比例,再乘到已有的20nt效率上,但它主要处理长度变化,而且使用了待预测序列的20nt实测值。但现在还涉及换成TeABE和扩展窗口,同时部分结果用18nt真值选过参数,这样就不属于独立测试了
- 将外部20nt实验数据按位置求平均,得到1–20位的平均编辑效率
- 用距离和位置训练一个回归模型f,尝试了SVR、随机森林和梯度提升树
- 将输入中的20nt距离换成18nt距离,得到预测的18nt平均效率
- 计算各位置的修正比例,再乘到其它实验数据的20nt实测效率上
最后gpt推荐这么做:
- 复用最终主图选定的ABE8e/D699模型,将3–10位outcome频率汇总成位置效率,再分别对窗口内可编辑A的位置求平均,得到两种源模型对该序列的活性参考\(s_A、s_D\)
-
用一个共享的小回归预测TeABE的每个A位置
输入 含义 \(s_A、s_D\) 该序列在两种源模型中的预测活性 该位置的nearest距离 局部结构信息 位置\(j\)及\(j^2\) 允许TeABE形成自己的窗口形状 可以采用约6个系数的比例logit回归:
\[\operatorname{logit}(\hat p_{T,t,L,j}) = \beta_0 +\beta_A\operatorname{logit}(s_A) +\beta_D\operatorname{logit}(s_D) +\gamma z_{d,j} +\delta_1x_j+\delta_2x_j^2\]其中,\(z_{d,j}\)是标准化距离,\(x_j\)是缩放后的位置。变回原尺度后,这是对编辑优势比的乘法修正,预测值保持在0–100%
这样处理也解决了源模型缺少第11–20位预测的问题:源预测提供整条序列的活性参考,距离和位置决定各位置的响应
- 仍用其它TeABE target的1–20位实测效率拟合回归,每折10个target训练、1个验证、1个测试。同一target的全部长度和位置一起留出,源模型也使用对应留出折
- 这属于有监督的跨编辑器全窗口回归适配。它利用训练target学习TeABE规律,测试target真值只用于评价
- 最后主要报告position-level MSE,辅以MAE
cd /public/home/GENE_proc/wth/crispron-BE
# /public/home/GENE_proc/wth/crispron-BE/res/TeABE_position_logit_20261016/paper_joint/delta_nearest/members_25/submissions/20261016_100903_3a5027/logs
bash scripts/teabe_position_logit_20261016/submit.sh 25
# /public/home/GENE_proc/wth/crispron-BE/res/TeABE_position_logit_20261016/paper_joint/delta_nearest/members_25/summary/
文献阅读
human enhancer–gene regulatory interactions
An encyclopedia of human enhancer–gene regulatory interactions
用CRISPR功能扰动数据训练了一个增强子—基因预测模型ENCODE-rE2G,再将它应用于1,458个ENCODE样本,构建了超过9,200万条具有细胞类型信息的增强子—基因预测联系,并由模型特征进一步发现邻近增强子之间可能存在超加性协同
- 增强子是能够促进基因转录的非编码调控元件,但从开放染色质、H3K27ac或Hi-C数据中发现一个候选增强子后,仍然面临两个问题:这个区域是否真的具有调控功能?它具体调控哪个基因?
- DNase-seq、ATAC-seq:说明染色质开放,但开放区域不一定是增强子
- H3K27ac:支持活性增强子状态,但不能确定靶基因
- Hi-C、ChIA-PET:说明增强子和启动子在三维空间中接触,但接触不等于功能调控
- 距离最近基因:远端增强子经常跨过最近基因调控更远的基因
- 增强子和基因表达相关性:可能由共同细胞状态或其它因素驱动,不能直接证明调控
- CRISPRi:抑制候选增强子后观察基因表达是否下降,可以直接检验功能,但实验成本高,无法覆盖所有细胞类型和全基因组
- 解决方案:用少量但较可信的CRISPR功能扰动结果作为监督标签,让模型从DNase-seq、Hi-C、基因组距离、启动子类型等特征中学习调控规律,再将规律推广到没有CRISPR实验的细胞类型
数据:
- CRISPR扰动数据:K562(人慢性髓系白血病细胞)训练集包含10,356个元件—基因组合,其中471个为阳性、9,885个为高统计功效阴性;另用5种细胞类型约4,400个组合进行独立验证
- ENCODE表观基因组数据:包括1,458个DNase-seq实验,覆盖369种细胞类型和组织,并整合65个Hi-C数据集及部分H3K27ac、ChIA-PET数据,用于描述增强子活性和三维接触
- 人群遗传数据:使用GTEx中超过30,000个fine-mapped eQTL和UK Biobank中94种性状的fine-mapped GWAS变异,检验模型能否识别调控元件及其靶基因
- 增强子协同实验数据:对K562中MYC附近7个增强子进行两两CRISPRi扰动,并结合H3K27ac ChIP-seq,研究增强子之间是否存在协同作用
CRISPR扰动数据:
- 把一个候选增强子和一个附近基因组成一个“元件—基因组合”
候选增强子E→基因G - 主要使用CRISPRi进行实验
- 设计gRNA将不切割DNA的dCas9-KRAB定位到候选增强子
- KRAB使该区域形成抑制性染色质,降低增强子活性
- 测量基因G的表达是否随之下降
- 与没有靶向该增强子的对照细胞比较
- 如果抑制增强子E后基因G表达显著下降,就支持“E调控G”,这类组合被标记为阳性
- 如果抑制增强子后基因表达没有显著变化,不能立刻认为二者没有关系,还可能是因为分析的细胞数量太少/基因表达波动太大/测序深度不足/gRNA抑制效率不稳定/增强子作用较弱等等。这种情况下,“未显著”可能只是实验能力不足造成的假阴性。因此作者进行了统计功效分析——只有当实验具有至少约80%的概率检测到15%~25%的基因表达下降,但实际仍未观察到显著下降时,才把该组合定义为高统计功效阴性
- 例如,某基因正常表达量为100
- 是否显著下降:抑制增强子后,基因表达是否至少下降20%
- 因为是单细胞数据,所以每个细胞的表达都可能有差别,作者先根据真实数据(基因G的平均表达量和表达离散程度)在计算机中模拟“如果增强子E真的会让基因G下降20%,按照当前细胞数量和表达噪声,重复做这项实验会得到什么结果”
- 如果模拟的结果中有超过80%的概率能检测到,就认为当前实验对20%下降具有较好的检测能力
- 但现在我们发现没有显著结果,就说明增强子E不太可能对基因G产生20%左右或更大的表达促进作用,这就是“高统计功效”
- 如果模拟的结果中没有80%的概率检测到,就说明阴性很可能是因为检测能力不足造成的,无法判断是否增强子影响了基因,就把这部分样本剔除
ABC模型:
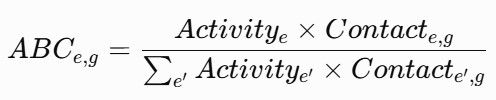
一个增强子调控某个基因的可能性取决于:
- 增强子本身有多活跃
- 它和该基因启动子接触得有多频繁
- 相对于同一基因周围其它增强子,它贡献了多少activity×contact
Hi-C(高通量染色体构象捕获)技术:一种用于研究染色质在三维空间中的组织方式的实验方法。通过Hi-C数据,我们可以分析染色质互作区域,这些区域指的是在细胞核中空间上相互靠近的染色质区域,它们可能在调控基因表达中起着重要作用
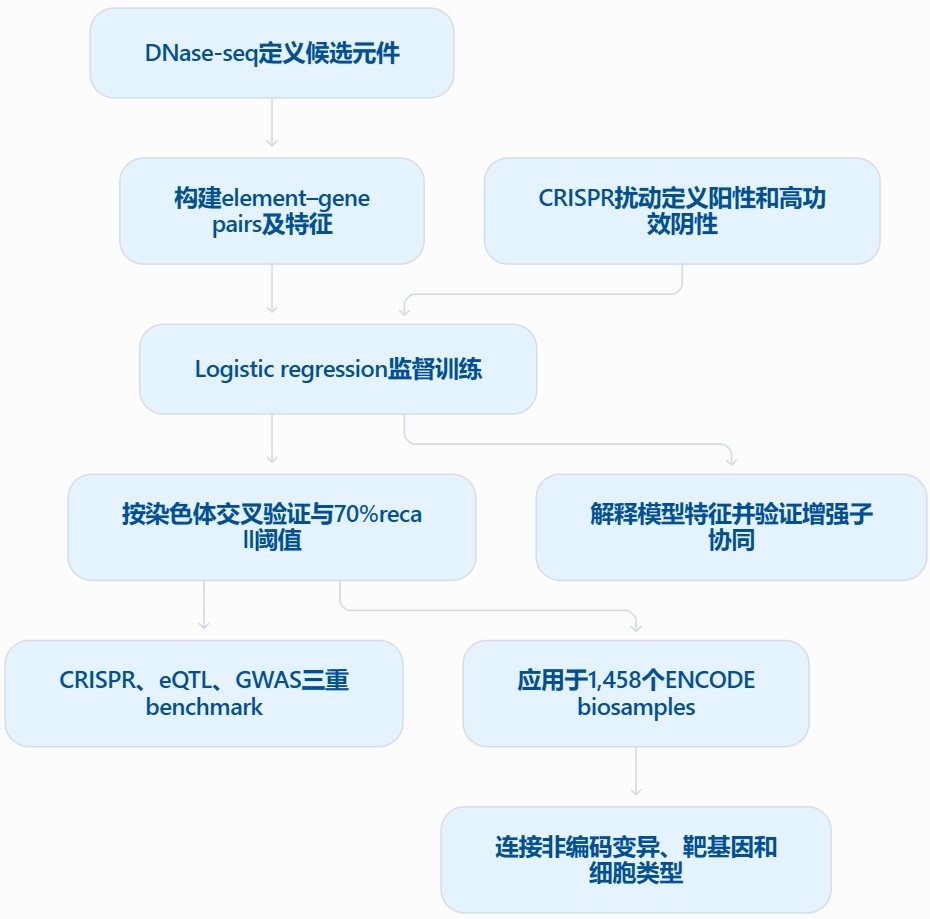
第1步:用CRISPR功能结果训练ENCODE-rE2G模型
- 训练数据:471个阳性element–gene pairs+9,885个高功效阴性pairs
- 训练集测试集划分:hold-one-chromosome-out cross-validation
- 每次留出一条染色体作为测试集
- 用其余22条常染色体和X染色体训练
-
重复23次,使每条染色体都被独立测试一次
增强子—基因联系在同一基因组区域内高度相关。如果随机拆分element–gene pairs,同一基因附近非常相似的元件可能同时进入训练集和测试集,造成性能虚高。按染色体拆分可以明显减少这种局部信息泄漏
-
ENCODE-rE2G:二分类Logistic regression监督学习模型
P(y=1|X)=sigmoid(β0+k∑βkXk)
y=1:CRISPR支持该元件调控该基因y=0:有充分统计功效但没有发现调控- Xk:DNase信号、三维接触、距离、启动子类型等特征
- 输出值:该element–gene pair存在调控联系的预测概率
- 两种主要模型
-
ENCODE-rE2G通用模型:只要求新细胞类型具有DNase-seq数据(唯一需要针对新细胞类型重新测量的实验数据是DNase-seq),模型自带固定的跨组织Hi-C Megamap和基因组注释
特征包括:
- 候选元件和启动子的DNase信号
- 65个ENCODE Hi-C数据汇总得到的平均接触频率
- ABC score
- 元件到TSS的距离
- 元件和靶基因之间的TSS数量、候选元件数量
- 靶基因是否属于广泛表达的housekeeping gene
- 候选元件周围5kb内其它元件的总活性
-
ENCODE-rE2G Extended模型:额外加入H3K27ac ChIP-seq、细胞类型特异Hi-C、CTCF/Pol II ChIA-PET以及EpiMap、GraphReg等其它模型的输出
它的准确度更高,但只有少数ENCODE Tier 1细胞类型具有完整输入数据,因此无法用于全部1,458个样本
-
- 1a左:研究的三个组成部分
- DNase-seq/H3K27ac代表染色质活性
- Hi-C代表三维接触;
- CRISPRi提供真实功能标签
- Logistic regression学习这些特征与真实调控之间的关系
- 1a中:验证模型准确——CRISPR、eQTL、GWAS
- 1a右-1b:将通用ENCODE-rE2G应用到1,458个DNase-seq样本,输出不同细胞类型中的增强子-基因预测弧线,以PRKAR2B位点为例,展示模型根据开放程度、三维接触、距离和其它环境特征,从候选区域中筛出更可能具有功能的元件
- K562的Hi-C接触矩阵
- PRKAR2B及附近基因结构
- ENCODE-rE2G和Extended模型的预测弧线
- CRISPR实验支持的元件
- H3K27ac、DNase-seq轨迹和DHS(DNase I高敏感位点,表示染色质比较开放、容易被DNase I酶切割的基因组区域)
- 相关造血细胞中的预测结果:展示模型能否应用到K562以外的细胞,判断调控联系是细胞类型特异性的还是共享的造血系统调控元件
- 不同biosample(细胞类型)中,各候选增强子调控PRKAR2B的ENCODE-rE2G预测分数热图
- 一条垂直的红色区域表示位于这个基因组位置的增强子,在多种细胞类型中都被预测为PRKAR2B增强子
- 红色弧线连接候选增强子和PRKAR2B,弧线宽度或颜色反映预测分数
- 作者在70%recall对应的阈值处二值化预测,最终每个biosample平均得到
- 40,210个预测增强子
- 63,221条增强子—基因联系
- 约0.89%的人类基因组被标记为预测调控元件
第2步:用CRISPR、eQTL和GWAS系统评测模型
- 建立了一个统一benchmark,用相同数据、相同候选元件和相同评价指标比较616种模型或模型变体
- 用CRISPR、eQTL和GWAS系统评测模型:主要使用precision–recall而不是accuracy
- 训练集中只有471/10,356≈4.55%为阳性,类别极不平衡
- Precision:预测为调控联系的pairs中有多少是真的
- Recall:真实调控联系中找回了多少
- 2a:三类功能证据
- 2b:K562训练数据中的precision–recall曲线
- 基础模型:
- ENCODE-rE2G:AUPRC=0.66
- DNase+平均Hi-C版ABC:AUPRC=0.56
- 70%recall时precision分别为58%和48%
- 进阶模型:
- ENCODE-rE2G Extended:AUPRC=0.74
- DNase×H3K27ac+细胞类型特异Hi-C版ABC:AUPRC=0.61
- 70%recall时precision分别为73%和56%
- 说明监督学习确实从CRISPR数据中学到了ABC之外的信息
- 不过这仍是交叉验证性能,不代表全基因组预测中73%的联系都一定真实,因为全基因组候选pairs的阳性比例可能与CRISPR训练集不同
- 基础模型:
- 2c:不同距离下的性能
- 按增强子到TSS距离分为:0-10kb、10-100kb、100-2500kb
- 近距离pairs相对容易预测;距离超过100kb后,所有模型AUPRC都明显下降。ENCODE-rE2G仍然优于其它模型,但并没有完全解决远端增强子预测问题
- 2d:在K562、WTC11、HCT116、GM12878和Jurkat等5种细胞中测试模型。ENCODE-rE2G在没有参与训练的CRISPR数据中仍取得最高weighted AUPRC,说明模型不只是记住了K562训练位点
- weighted AUPRC:部分CRISPR阳性可能来自间接效应
- 将远端元件扰动与其它染色体上的随机基因配对
- 估计距离无关的trans/indirect hit rate
- 建立直接效应随距离衰减的power-law模型
- 为每个阳性pair计算Pdirect
- 按该概率为阳性结果加权
- weighted AUPRC:部分CRISPR阳性可能来自间接效应
- 2e:eQTL评测(SNP基因型→基因表达变化)
-
检查fine-mapped eQTL SNP是否落在模型预测的增强子中,以及该增强子是否连接到正确的eGene
富集倍数=
eQTL中落入预测增强子的比例/背景变异中落入预测增强子的比例背景变异:普通的远端非编码常见变异
25倍富集:已知会影响基因表达的fine-mapped eQTL变异,落入模型预测增强子区域的比例,是普通远端非编码变异落入这些区域比例的25倍。说明模型筛选出的区域确实集中包含已知表达调控变异,而不是随意选出一批开放染色质区域
Recall:所有真实eQTL中,有多少不仅落在预测增强子里,而且该增强子还被模型连接到了正确的eGene
15%recall:有1,000个eQTL,其中150个落在被模型连接到这个eQTL实际影响的eGene增强子中
在约15%recall处达到25倍富集:模型正确找回了约15%的eQTL—基因联系;与此同时,模型选出的增强子区域中,eQTL相对于普通非编码变异富集约25倍
- ENCODE-rE2G Extended在约15%recall处达到31倍富集,ENCODE-rE2G达到约25倍富集
- 为什么富集很高,但recall只有15%:因为此时模型使用了相对严格的分数阈值,只保留高可信预测。这正是2e绘制“enrichment–recall曲线”的原因——不能只看富集,也不能只看覆盖率,需要同时评价可信度和找回能力
-
- 2f:GWAS变异富集
- 检查血细胞相关GWAS变异是否富集在K562或GM12878预测增强子中:ENCODE-rE2G平均富集10.6倍,ABC约9.6倍
- 证明模型预测的元件能够优先覆盖疾病或性状相关变异,但不能仅由此确定具体靶基因
- 2g:检验模型能不能把一个非编码GWAS变异连接到正确的靶基因
- 假设GWAS发现某个非编码区域与红细胞数量有关,但其中的变异不在任何基因编码区,可能位于增强子中,但附近有多个基因,作者不知道它究竟调控哪个基因。为了评价ENCODE-rE2G和ABC,必须先找到一批“靶基因大概率已知”的位点作为参考答案。可是绝大多数非编码GWAS位点没有经过CRISPR实验验证,所以作者采用了一个间接办法
- credible set:最可能包含因果变异的一组SNP。如果这个credible set中的变异都不改变蛋白编码序列,也不位于关键剪接位点,就称为非编码credible set。它可能通过增强子调控基因,但具体靶基因未知
- 附近存在独立coding variant:假设同一个GWAS locus中存在两个相对独立的遗传信号——信号A(非编码credible set,靶基因未知)+信号B(一个独立的coding variant,直接改变Gene G的蛋白序列),独立”表示B代表另一个相对独立的遗传关联信号,而不只是因为与非编码变异处于强连锁不平衡而被动显著;作者据此推测同一区域中的非编码变异也可能通过调控Gene G影响同一种性状,于是Gene G被当作非编码credible set的“参考靶基因”。因为这种方法没有直接证明非编码变异确实调控该基因,所以被称为Silver standard(对应的,通过CRISPR等实验直接证明非编码元件调控某个基因就是Gold standard)
- 作者最终选出197个附近存在独立coding variant的血液性状非编码credible sets,把这些基因当作参考答案,测试不同模型能否通过
非编码GWAS变异 → 与预测增强子重叠 → 模型预测的靶基因找到它们- Precision=模型预测中符合参考答案的基因联系/模型给出的全部基因联系
- Recall=模型成功找回的参考基因联系/全部参考基因联系
第3步:构建全基因组增强子—基因图谱
模型被应用到1,458个ENCODE DNase-seq biosamples后,共得到92,176,227条biosample-specific E–G预测联系、每个biosample平均63,221条,覆盖369种细胞类型和组织
- 增强子通常没有想象中那么远:24.1%的联系距离TSS不足10kb,74.6%的联系距离TSS不足100kb,仍有少数联系可跨越数百kb甚至Mb
- 一个基因通常由多个增强子调控:每个基因平均5.91个增强子,中位数为3个
- 一个增强子通常只调控少数基因:每个增强子平均连接1.57个基因,中位数为1个;但同一个增强子可以在不同细胞类型中连接不同基因。因此“某个增强子的靶基因”不能完全脱离细胞类型来定义
- 调控复杂度与基因功能相关:在至少50%的biosamples中表达的基因里,
- 平均每种细胞有至少5个增强子的基因,富集于血管生成、神经发生等细胞类型特异过程
- 平均不超过1.5个增强子的基因,富集于rRNA加工、mRNA剪接等housekeeping过程
- 提示需要精细时空控制的基因通常拥有更复杂的增强子网络,而基础生命活动基因相对少依赖远端增强子
第4步:GWAS变异—基因—细胞类型连接,用ENCODE-rE2G解释非编码GWAS变异(增强子上的GWAS变异)
- 仅凭增强子—基因预测仍存在问题:一个GWAS变异所在增强子平均连接2.9个基因,最多可连接34个基因;59.8%的此类增强子还会在不同细胞类型中连接不同基因
- PoPS:根据57,543种基因层面的信息(bulk/scRNA-seq表达、生物学通路、蛋白互作网络以及基因功能特征),训练模型预测MAGMA gene score,回答“哪些基因的已知功能与这种疾病更一致”
- ENCODE-rE2G和PoPS结合:ENCODE-rE2G看风险变异所在元件在基因组空间中可能调控哪个基因,PoPS看哪个基因的功能与疾病遗传结构最相符。作者取每个locus中两种方法的top 2基因交集
- 3a:风险变异 + 预测增强子 → rE2G → 候选基因,再与PoPS优先基因求交集,得到更严格的候选靶基因
- 3b:覆盖率与富集程度
- 横轴表示有多少fine-mapped variants被连接到基因,纵轴表示相对于对照变异的富集倍数
- ENCODE-rE2G与PoPS交集的覆盖率较低,但富集程度最高
- 3c:ENCODE-rE2G∩PoPS识别silver-standard基因的precision达到79%,分别是单独使用ENCODE-rE2G或PoPS的约1.4倍和2.3倍
- 也发现了ABC-Max图谱未覆盖的1,044个credible sets
- 但求交集会牺牲recall,因此适合构建高可信候选列表,不适合要求尽可能找全所有候选的分析
- 3d:性状—组织富集热图
- 列是50种GWAS性状,行是914个映射到组织类别的ENCODE biosamples
- 红色表示该性状的fine-mapped variants显著富集于该biosample的预测增强子,白色是未达到FDR<0.10
- 结果总体符合生物学预期:红细胞、血红蛋白等性状富集于造血细胞,免疫性状富集于淋巴和髓系细胞,肝脏、肾脏、肺等性状在对应组织中出现富集
- 表明模型不仅可以提出靶基因,还可以利用增强子的细胞类型特异性推测疾病发挥作用的细胞环境
- 3e:rs875741—CPEB4示例
- rs875741是mean corpuscular haemoglobin相关fine-mapped variant,PIP=0.50
- CPEB4本身广泛表达,但风险变异所在增强子只在特定造血祖细胞中表现出开放和调控联系
- 模型预测该变异所在元件在haematopoietic multipotent progenitor中连接CPEB4,在K562、活化T细胞、B细胞和部分其它细胞中不形成同样的高分连接
第5步:解释模型学到了哪些调控规律
- 4a:最终8类特征
- 启动子DNase活性
- 靶基因是否广泛表达
- ABC score
- 增强子—启动子三维接触
- 候选增强子周围5kb内其它元件的活性
- 到TSS的距离
- 中间隔着多少个TSS
- 中间隔着多少个候选元件
- 4b:leave-one-feature-out
- 删除后性能下降越多,说明该特征包含其它特征无法完全替代的信息
- 中间TSS数量、ABC score、是否为广泛表达基因等具有较明显的独立贡献
- “中间TSS数量”可能反映启动子竞争、调控结构边界或增强子更倾向于作用于未被其它启动子隔开的基因,但模型本身不能确定具体机制
- 4c:顺序加入特征
- 从空模型开始,每次加入能够最大幅度提高AUPRC的特征:第一个加入的ABC score带来最大性能提升,再加入启动子类别、间隔TSS、启动子DNase等特征,后续特征的边际贡献逐渐减少
- 4d:523种染色质实验谁最适合表示enhancer activity(仅在K562 CRISPR benchmark、当前数据处理和候选元件定义下)
- 作者把523种ENCODE一维染色质实验逐一代入ABC模型的activity部分
- DNase-seq整体表现最好;EP300、NCOA1、NCOR1及部分转录因子ChIP-seq接近DNase-seq;H3K27ac是表现最好的组蛋白修饰,但在全部实验中约排第33
- 4e:哪种三维接触数据最好(也是代入ABC模型中)
- 作者比较6种contact估计方法:细胞类型特异ENCODE Hi-C、跨细胞类型平均Hi-C、Pol II/CTCF ChIA-PET、CTCF相关结构、用距离倒数近似接触
- 细胞类型特异Hi-C最好,它的提升主要出现在距离超过100kb的调控联系。近距离元件的接触可由距离较好近似,远距离联系则更依赖真实三维结构
- 4f–g:不同数据组合
- 作者提供8种预训练模型,可以根据现有数据选择DNase-only/DNase+H3K27ac/DNase+Hi-C/DNase+H3K27ac+Hi-C/对应的ATAC版本/Extended模型
- 添加细胞类型特异H3K27ac或Hi-C可以提高性能;在本文数据中,DNase模型优于对应ATAC模型;ATAC模型加入H3K27ac或Hi-C后的改善更明显;Extended模型性能最高,但数据要求也最高
第6步:模型提示邻近增强子可能具有超加性作用
- 模型发现“候选增强子周围5kb内其它元件的活性”能够提高预测性能,也就是说,一个增强子附近还有其它活跃增强子时,它更可能产生可检测的基因调控效应。作者由此提出:邻近增强子可能不是完全独立相加,而是相互促进
- 超加性:双增强子抑制产生的表达下降,小于把两个单增强子下降幅度直接相加得到的预测值
- 假设正常基因表达量为100,抑制增强子E1后表达变为60(即下降40),抑制增强子E2后也变为60(即下降40)
- 简单加性模型预测同时抑制两者后下降80,表达剩20
- 如果两个增强子在正常状态下相互促进,那么单独抑制任何一个时,都会同时损失部分共同协同成分。把两次单独扰动的下降量直接相加,会重复计算协同成分。双扰动实际可能只下降64,表达剩36(接近
0.6×0.6=0.36)
- 5a:20个对目标基因附近全部候选增强子进行CRISPRi tiling的实验
- 有10个基因的所有单增强子抑制效应相加超过100%,提示部分单扰动效应包含共享的协同成分
- 5b:作者选择K562细胞中已知的MYC增强子e1–e7,其中e1–e4位于相对近端区域,e5–e7可距离MYC达到约1~2Mb,展示DNase和H3K27ac信号
- 5c:CRISPRi-FlowFISH实验
- 为7个增强子和对照区域设计gRNA
- 将每条gRNA与其它gRNA两两组合
-
导入表达KRAB-dCas9的K562细胞
KRAB-dCas9不会切断DNA,而是把KRAB抑制结构域定位到目标区域,诱导局部抑制性染色质,从而降低增强子活性
- 同时抑制两个增强子
- 通过RNA-FlowFISH测量单细胞MYC RNA
- 按荧光强度分成6个区间
- 测序每个区间中的gRNA组合
- 推断每种双扰动对MYC表达的影响
- 5d:近距离和远距离组合
- e2+e3相距约85kb:双扰动结果明显弱于简单加性下降,接近乘法模型,支持超加性激活
- e1+e7相距约1.8Mb:双扰动更接近简单加性,协同较弱
- 5e:全部21个增强子组合
- 数值是
观测双扰动效应/加性模型预测效应,比值越低于1,说明双扰动的下降越弱于简单相加,也就是正常状态下的超加性越明显 - 21个组合中有19个达到显著超加性,但程度不同
- 距离3~89kb的组合,与加性预测相差16%~37%
- 距离107kb~1.79Mb的组合,仅相差2%~10%
- 数值是
- 5f:Hi-C接触矩阵
- 增强子之间Hi-C接触越强,Fig.5e中的超加性通常越明显,关键因素可能不是线性距离本身,而是三维空间邻近程度
- 5g–h:CRISPRi和DNA deletion后的H3K27ac变化
- 扰动一个增强子后,1-10kb内其它增强子的H3K27ac明显下降;10-100kb的影响较弱;超过100kb后总体接近零
- 提供了独立于基因表达的染色质证据:邻近增强子能够影响彼此的活性状态
- 综上:
邻近或高接触增强子→相互维持活性染色质→对靶基因产生超加性激活
PASCode
AI-based characterization of Alzheimer’s disease phenotypes from population-scale single-cell data
PASCode:利用大量供体的单核转录组和临床表型,识别真正与某种表型相关的细胞状态,再研究这些细胞的基因、通路和调控网络
研究背景:为什么要从“供体是否患病”进一步分析到“哪些细胞与疾病相关”?
- 常规单细胞研究:将AD供体的小胶质细胞与对照供体的小胶质细胞比较,寻找差异表达基因
- 但实际上,即使来自同一个患者、属于同一种细胞类型,不同细胞也可能处于不同状态。例如,一部分小胶质细胞发生了明显的疾病相关转录变化,另一部分变化较小。将它们混合分析,可能稀释特定细胞状态中的信号
-
此外,AD具有多种不能完全相互替代的表型:
表型 具体回答的问题 AD诊断 是否符合AD的诊断定义? Braak分期 神经原纤维缠结病理处于什么阶段? 认知功能 是否出现认知受损,其程度如何? 认知韧性 已存在AD病理时,认知功能是否仍相对保留? 神经精神症状,NPS 是否伴随抑郁、睡眠问题、精神运动性激越等? - 这里的“认知韧性”尤其重要:有些人虽然存在AD病理,却没有出现同等程度的认知受损。研究这些人,可能帮助寻找与认知保留相关的分子特征
这篇文章想回答:上述不同表型分别对应哪些细胞状态?这些状态涉及哪些分子变化?不同表型是否共享部分细胞与通路?
数据:
- 主数据来自PsychAD项目,脑区为背外侧前额叶皮层(DLPFC),snRNA-seq
- 还使用了ROSMAP的bulk RNA-seq验证基因集,以及独立重性抑郁障碍队列验证抑郁相关结果
| 数据或分析 | 样本规模 | 用途 |
|---|---|---|
| PsychAD整体资源 | 1,494位供体,超过630万个细胞核 | 提供大规模单核表达图谱 |
| 本文重点分析人群 | 584位具备相关表型信息的供体 | 分析AD、Braak、认知韧性和NPS |
| AD模型训练集 | 100位AD+100位对照,776,273个细胞核 | 训练AD相关细胞评分模型 |
| PsychAD留出验证集 | 11位AD+11位对照 | 检验未参与训练供体上的表现 |
| SEA-AD验证集 | 39位痴呆+39位无痴呆供体 | 跨队列验证 |
| ROSMAP单核验证集 | 24位AD+24位对照 | 跨队列验证 |
| 疾病进展模型训练集 | Braak 0和Braak 6各30位供体 | 学习早期与晚期病理相关转录状态 |
| AD伴抑郁分析 | 98位伴抑郁+110位不伴抑郁的AD供体,839,355个细胞核 | 研究AD内部的抑郁相关变化 |
第1步:建立PASCode,为每个细胞计算表型关联评分
-
表型相关细胞(phenotype-associated cell, PAC):
分类 含义 AD-PAC+ 与AD条件相关的细胞状态 AD-PAC− 与对照条件相关的细胞状态 non-PAC 未达到两端关联阈值的细胞 这里的正负,取决于当前分析的表型对比。换成抑郁分析后,Depression-PAC+对应抑郁相关状态,Depression-PAC−对应无抑郁相关状态
-
PAC标签描述细胞的表达状态与表型之间的关联,不能直接解释成细胞有害或具有保护作用
- 第一层:使用多种差异丰度分析方法,寻找与表型相关的细胞状态
- 将表达相似的细胞组织到相邻区域
- 检查某一局部细胞状态是否在AD或对照供体中更丰富
- 多种方法分别给出结果
- 通过排名整合,得到正向、负向和未标记三类“聚合表型标签”
差异丰度(DA):关注的是某种细胞状态出现得是否更多
- 第二层:训练图注意力网络(GAT),将统计方法得到的细胞状态关联,转化为可用于新数据的预测模型
- 输入:每个细胞的基因表达、细胞之间的相似性图、上一步得到的聚合表型标签
-
模型学习如何根据细胞自身的表达及其邻居信息,预测聚合标签。训练完成后,可以为新细胞输出三个类别的概率
si=Pi(正向标签)-Pi(负向标签)
- PAC score的范围是−1到1
- 某细胞的正向概率为0.80,负向概率为0.10,未标记概率为0.10,表示它具有较强的正向表型关联
- 1b左:PsychAD-1,494个供体-DLPFC-约600万个细胞核、27个细胞亚类、65个细胞亚型
-
1b右:不同表型分组的供体数
柱子分组 比较什么 研究目的 Control、AD 对照与AD供体 找AD相关细胞状态 Braak 0–6 不同神经原纤维缠结病理分期 研究AD病理进展 Others、AD-cognitive-resilient、AD-strict 认知韧性、明确AD伴痴呆及其余供体 研究已有病理时的认知保留 Control、Depression/Mood 不伴与伴抑郁/情绪症状 研究AD中的抑郁相关状态 Control、WeightGain/Sleep/Suicide 相应症状对比 研究这一NPS组合相关状态 Control、WeightLoss/PMA 相应症状对比 研究体重下降/精神运动性激越相关状态 - 认知韧性分组:已经存在AD病理,为什么不同人的认知受损程度仍然不同?
- AD-strict:明确AD病理并伴临床确认的痴呆
- AD-cognitive-resilient:已经有一定AD病理,但认知功能相对保留;具体标准结合病理诊断和CDR-SOB
- Others:没有被划入上述两类的其余供体,不能直接当作健康对照
- NPS(neuropsychiatric symptoms):神经精神症状
- Depression/Mood:抑郁/情绪症状
- WeightGain/Sleep/Suicide:体重增加/睡眠/自杀相关症状组合
- WeightLoss/PMA(psychomotor agitation):体重下降/精神运动性激越组合
- 认知韧性分组:已经存在AD病理,为什么不同人的认知受损程度仍然不同?
第2步:识别AD相关细胞,判断哪些细胞类型最重要
- 2a上:基于基因表达的UMAP,主要展示细胞类型之间的差异;同一细胞类型内,AD与对照供体的细胞存在大量混合
- 2a下:基于PASCode的UMAP,细胞状态沿AD-PAC评分呈现更清楚的分布
- 2b:独立数据中,按照差异丰度方法得到的正向、负向、未标记细胞,其预测PAC评分能否区分
-
2d:进一步检验供体层面的AD分类
验证数据 AUC PsychAD留出集 0.85 SEA-AD 0.68 ROSMAP 0.72 AUC衡量分类排序能力:数值越大,模型越能将两类供体区分开
- 2c:对每位供体、每个细胞类型计算平均PAC score
-
2e:将这个矩阵输入随机森林,预测供体属于AD还是对照,再用SHAP解释不同细胞类型对预测的贡献
横坐标是该特征对模型输出的贡献,颜色表示平均PAC评分的高低,排名靠前表示其评分更有助于模型区分AD与对照
-
2f:筛选PAC后,已知AD通路的信号是否更清楚
以小胶质细胞为例,比较三类已知AD相关基因集——Aβ结合、tau蛋白结合、AD通路
使用AUCell计算每个细胞的基因集评分,分别比较donor level(AD与NC)和PAC level(AD-PAC+与AD-PAC−),结果显示PAC比较中的通路评分差异更明显
先定位具有明确表型关联的细胞状态,再研究分子变化,有助于减少其它状态对信号的稀释
-
2g:差异基因也出现类似结果
小胶质细胞中,在PAC层面找到1,148个差异基因,donor层面220个,两者共享198个
横轴是PAC层面的统计显著性,纵轴是donor层面的统计显著性,对角线下方的点,表示该基因在PAC比较中更显著,紫色是仅作PAC上出现的基因,橙色是仅在donor上,加粗的基因则属于已知与AD相关的mic相关通路中的基因
第3步:用细胞状态刻画AD进展,研究认知韧性
- 3a、b:从Braak两端学习“疾病进展评分”
- 选取30位Braak 0供体和30位Braak 6供体,先训练细胞层面的AD-progression-PAC模型,再按细胞类型汇总评分,训练供体层面的随机森林,输出供体属于Braak 6这一端的概率——AD progression stage time,表示供体的转录特征与晚期Braak状态的相似程度
- 3b横轴为真实Braak分期,纵轴为模型评分。总体上,Braak越高,评分越高,但是中间阶段存在较大重叠,模型没有准确区分疾病进展的中间状态
- 3c:在SEA-AD中与独立病理评分比较
- 固定PsychAD训练的模型,应用到SEA-AD,再与该队列的连续病理进展评分CPS比较
- 每个点是一位供体,横轴是PASCode生成的stage time,纵轴是SEA-AD的CPS,相关系数约为0.41,n=69。说明模型捕捉到了一部分病理进展信息,但相关程度有限,不能说两种评分完全一致
- 3d:沿模型进展评分寻找表达变化
- 重点分析EN_L2_3_IT,即皮层第2/3层的一类端脑内投射兴奋性神经元
- 通过MAST,在考虑年龄、性别和死后间隔等因素后,寻找与stage time相关的基因
- 本质是一种火山图,图中左边较大的是右边总图的放大部分(浅蓝色区域),模型进展评分越高 基因表达越高/低
- 3e:相同Braak分期下,认知韧性人群是否不同
- 中期两组评分差异不显著,晚期AD-cognitive-resilient的模型进展评分显著低于AD-strict组
- 在相同的大类病理分期中,两组仍具有不同的转录状态
- 3f:比较AD-cognitive-resilient和AD-strict两组在不同细胞类型的SHAP贡献差异,多个兴奋性和抑制性神经元显示显著差异,提示神经元状态在区分认知韧性时较重要
-
3g展示晚期两组在这些神经元中的差异基因,黄色方向表示AD-strict中表达更高,蓝色方向表示认知韧性组中表达更高
功能方向 代表性观察 线粒体功能 AD-strict中MTERF1上调,提示线粒体转录调节异常 兴奋/抑制平衡 PIP5K1A、KCNB2、KCND2以及ADCY2、CBLN2等出现细胞类型相关变化 脂质代谢 RAB27B、PLA2G4C、PRKCH等变化
第4步:AD伴发抑郁对应哪些细胞状态
- 在AD供体内部,比较伴抑郁与不伴抑郁的供体
- 4a、b:抑郁相关细胞分布
- 4c:各类细胞中Depression-PAC+和PAC−的比例,橙线是细胞总数
-
4d/e:基于SHAP进行排序,同fig2
与前面AD总体分析中小胶质细胞排名第一有所不同,说明不同临床表型对应的重点细胞类型并不相同
- 4f、g:是否存在同时与AD和抑郁相关的细胞
- 将AD-PAC+和Depression-PAC+进行交叉,寻找同时满足两种关联的细胞,显著共享的细胞簇主要涉及Astro_WIF1和Oligo_OPALIN等亚型
- 4f:将两种分析共有的细胞细分为89个Leiden簇,然后在各簇内部检验两类PAC+的重叠,最终展示5个满足筛选条件的簇——Astro_WIF1、Oligo_OPALIN、Oligo_RBFOX1
- 4g:每一行对应f中的一个彩色簇
- 最左边的单列热图:簇内AD-PAC+与Depression-PAC+的重叠显著性,越黑,实际交集超过随机预期的统计证据越强
- 中间的三列热图:该簇与Astro_WIF1、Oligo_OPALIN、Oligo_RBFOX1的富集关系,哪一列黑,说明该簇主要对应哪个亚型
- 最右边的两列灰色柱子:分别表示两类PAC+(AD-PAC+和Depression-PAC+)占该簇所有细胞的比例
- a:Depression-PAC+和PAC−相比上调基因富集于炎症相关条目
- b:Depression-PAC+和PAC−在各亚群的DE
- c:IL18在Depression-PAC+中更高
-
d:将同时关联AD和抑郁的Astro_WIF1细胞簇与其余Astro_WIF1细胞比较,找到271个上调基因,富集于内质网应激等过程
内质网参与蛋白质折叠和加工。内质网应激相关基因的变化提示蛋白质稳态压力,作者据此提出它可能参与AD与抑郁的共同细胞机制
第5步:从差异基因深入到基因调控网络
- 抑郁相关星形胶质细胞中的基因变化,是否组织成特定功能模块?推断的调控关系是否发生变化?
-
5a:基因共调控网络,点是基因,边反映两个基因预测调控因子的重叠,颜色表示不同模块
在Depression-PAC+和PAC−星形胶质细胞中使用GRNBoost2推断调控因子与靶基因的关系,检查不同基因是否共享相似的预测调控因子,根据共享程度构建基因—基因网络,聚类得到模块
- 5b:不同模块在哪些星形胶质细胞亚型中表达,行是模块,列是星形胶质细胞亚型,颜色表示模块平均表达,说明不同亚型可能承担不同的功能程序
- 5c:模块与疾病基因集的重叠,黑色格子表示达到图中设定的显著性阈值(0.1)
- 使用DisGeNET进行疾病相关富集,观察模块是否包含较多已知抑郁或其它疾病相关基因
- 5d:以M9为例,比较同一调控因子在PAC+与PAC−中预测的靶基因关系
- 横轴为M9基因;每个调控因子有上下两行,对应两类细胞;颜色越深,预测连接权重越高
- 例如,作者观察到ANXA1与部分M9靶基因的预测连接在Depression-PAC+中减弱,并讨论GRHL3、LMO2等候选调控节点
第6步:扩展到多种表型,形成可复用图谱
- 将同样的流程用于其它NPS组合:WeightGain/Sleep/Suicide、WeightLoss/PMA、Depression/Mood
- 6a:每一行是一个表型对比,每一列是一个细胞亚类,每个小框内的两根柱子表述该亚类中PAC−和PAC+的比例,绿色是PAC−,AD的PAC+用紫色,其他三种NPS的PAC+用蓝色
- 分类依据仍然是s>0.5是PAC+,<-0.5是PAC-,中间的细胞属于non-PAC,因此两根柱子的比例之和通常小于1
- 颜色深浅是log2(PAC细胞数)
- AD模型中,Micro有较高的PAC+比例;WeightLoss/PMA模型中,多个兴奋性神经元亚类有较高的PAC+比例;Depression/Mood的关联分布与AD不同,Astro、Oligo等胶质细胞较突出
- 6b:沿用前面Fig.2、Fig.4的分析——对每位供体、每个细胞亚类计算平均PACscore,得到“供体×27个细胞亚类”的特征矩阵,用随机森林预测对应表型的病例组和对照组,用SHAP衡量各细胞类型的预测贡献
- 柱高采用平均SHAP值的绝对值(只展示重要性大小,不展示贡献方向)
- 不同表型的预测依赖不同的细胞类型组合
- 6c:以Oligo为例,在每个表型下分别比较PAC+和PAC−,取得上调DEG集合,再比较四个集合的交集
- 例如,AD集合指Oligo中AD-PAC+相对于AD-PAC−上调的基因;Depression/Mood集合则来自对应的抑郁PAC比较
- 6d:模型复用示意图
- 新数据:来自多位供体的单核表达矩阵,列为基因、行为细胞,细胞归属于相应供体
- 已训练的AD/NPS模型:选择所需表型的PASCode模型,对齐所需基因,并完成匹配的预处理和细胞图构建
- 输出单细胞PACscore:为新数据中的每个细胞预测对应表型关联,再按阈值划分PAC+、PAC−和non-PAC
细胞亚群的划分:逐层重新选择高变基因、构建邻居图、进行Leiden聚类,再结合参考图谱注释
- 对全体细胞进行质控和表达量归一化,选择高变基因
- 用PCA降维,并用Harmony校正批次影响
- 在校正后的空间中构建kNN邻居图,用Leiden寻找表达相似的细胞簇
- 在每个大类内部重新选择高变基因,再进行同样的聚类,得到亚类;随后在亚类内部继续细分
- 将各簇的表达汇总,与已有DLPFC和人类初级运动皮层M1参考图谱比较,并结合marker确定身份和名称
- 在SEA-AD、ROSMAP等外部数据中,作者还通过
scanpy.tl.ingest()转移PsychAD细胞类型标签,以保证不同队列采用一致的分类
| 层级 | 本文采用的数量 | 含义与例子 |
|---|---|---|
| class:大类 | 8 | EN、IN、Astrocyte、Oligodendrocyte、OPC、Immune、Mural、Endothelial |
| subclass:亚类 | 27 | 例如EN_L2_3_IT、IN_SST、Micro |
| subtype:亚型 | 65 | 更细的表达谱分类,例如Astro_WIF1、Astro_ADAMTSL3 |
- 例如,EN亚类的命名结合了皮层层次和投射特征:EN_L2_3_IT表示第2/3层、端脑内投射的兴奋性神经元
PACscore的计算:供体表型+单细胞表达 → 三种DA方法 → RRA生成细胞训练标签 → GAT学习 → 每个细胞的PACscore
以下以AD与NC对照为例,这里正向表型是AD,负向表型是NC;换成进展分析时,正向和负向分别是Braak6和Braak0
- 准备平衡的训练数据和细胞邻居图
- 使用log₂CPM表达数据
- 用50个Harmony校正后的PC构建细胞邻居图(输入1:哪些细胞的表达状态相似)
- 从前5000个高变基因中保留3401个蛋白编码基因,作为PAC识别的表达特征(输入2:细胞表达谱)
-
用Milo、MELD、DAseq判断哪些表达状态与AD关联
方法 主要做法 提供给后续整合的结果 Milo 在kNN图上建立相互重叠的邻域,统计每个供体落入各邻域的细胞数,用负二项GLM比较两组丰度 邻域logFC;对包含同一细胞的邻域结果取平均,转换到细胞层面 MELD 在细胞图上估计不同样本、条件的密度,计算细胞状态与某一条件的相对关联 将0~1的相对likelihood缩放到−1~1 DAseq 在多个邻域尺度下计算状态评分,再用逻辑回归整合这些评分 −1~1的单细胞DA评分 - 使用DA,即差异丰度
- 同属Micro的一部分细胞具有某种相似表达状态,而这种状态在AD供体中更常见,就会被判断为AD方向相关。这个局部状态中仍然可以有来自NC供体的细胞
- 用RRA(RobustRankAggregation, 整合排名)整合三种方法,生成三类训练标签
- 三种DA方法的原始分数含义和尺度不同,所以作者用RRA而不是直接平均原始分数
- 具体来说:
- 每种方法分别按照正向、负向关联强度排列细胞
- 检查哪些细胞在多种方法中持续排在强关联位置
- 与随机排名的情况比较,评价这种一致性
- 最终形成正向关联、负向关联、无明显关联三类标签
- 这些标签是算法推断出的训练标签,不是把“来自AD供体的每个细胞”直接标成PAC+
- GAT(图注意力网络)学习表达与这些标签之间的关系
- GAT:它接受表达向量和细胞邻居图,学习预测RRA给出的三类标签
- “注意力”:预测一个细胞时,模型会利用它自身及邻居细胞的信息,并学习不同邻居应该占多大的权重。与简单平均邻居信息相比,GAT允许邻居的贡献不同
- 训练完成后,对每个细胞,GAT输出三个概率:p-(负向概率)、p0(未标记概率)、p+(正向概率),三者之和为1
- 作者增加GAT这一步,是为了在有表型信息的数据中学习好模型后,能够给新供体或缺少表型信息的供体的细胞评分,而无需每次重新依赖完整的病例、对照标签运行DA分析
-
将三个概率转换成一个PACscore:si=Pi,+-Pi,-
PACscore 分类 si PAC+ si PAC− 其余 non-PAC
总结:
-
将供体层面的表型关联定位到具体细胞状态:先利用Milo、MELD和DAseq寻找与供体表型关联的细胞状态,再用RRA整合结果、生成细胞训练标签,最后由GAT学习表达与细胞邻居关系,输出连续的PACscore
这样,Micro、Astro等仍然表示“细胞身份”,PACscore则提供“表型关联状态”这一额外维度
- 除此之外一个好处是可复用:训练完成后,新数据中的细胞可以获得评分,即使新数据缺少完整的供体表型信息。当然,实际迁移效果仍取决于脑区、测序数据和细胞状态是否与训练数据相近
-
将AD相关问题拆成几个不同的研究问题:一个状态与AD诊断相关,并不意味着它同样解释认知下降或抑郁。不同表型可能突出不同细胞类型,也可能共享部分细胞状态
分析方向 实际回答的问题 AD诊断 哪些细胞状态与AD供体身份相关? AD进展 哪些状态更接近早期或晚期病理,哪些基因随模型定义的阶段变化? 认知韧性 在较高病理负担下,哪些细胞状态与认知保存有关? 抑郁等神经精神表型 哪些状态与这些症状相关,它们与AD关联状态有多少共享? - 将细胞评分连接到可解释的生物学分析
- 哪些细胞类型提供了较强的表型预测信息:将评分按“供体×细胞类型”取平均,利用随机森林预测供体表型,再通过SHAP判断哪些细胞类型对预测贡献较大
- 这些关联状态涉及哪些表达变化和候选调控过程:在同一细胞类型内比较PAC+与PAC−,寻找差异基因、功能通路,并在部分分析中构建调控或共调控网络
- 一些局限性:
-
训练用的PAC标签来自DA分析和RRA整合,属于计算生成的监督标签,例如PAC+可能代表参与疾病损伤的状态/对疾病作出反应的状态/代偿或保护性状态,还无法确定其中哪一种解释成立
AD供体分类在PsychAD留出数据、SEA-AD和ROSMAP中的AUC分别约为0.85、0.68和0.72。这支持评分包含可迁移的表型信息,也显示迁移性能存在差异
- 筛选细胞和寻找差异基因使用了相同的表达信息:假设某个炎症基因的高表达帮助模型识别了高PACscore细胞。之后再比较PAC+和PAC−,发现该炎症基因显著上调,其中一部分差异可能来自前面的筛选过程
- 部分PAC差异表达采用细胞级Wilcoxon检验
- 晚期病理组的认知韧性分析只有9位工体
-
- 可以借鉴一下他是怎么给每个细胞打分的,之前毕设中也尝试过打分的思路(不过用的是hERV的表达量)
- 用他的模型算一下我自己的数据pac score
RLDpred-BE
Results
RLDpred-BE incorporates guide length and structural distance to predict adenine base-editing outcomes
Base-editing predictors trained on standard-length sgRNAs may not capture efficiency changes associated with guide truncation. We developed RLDpred-BE, an sgRNA length- and structural distance-aware post-training framework for predicting the editing efficiency of specific base editors, by adding length and Δdistance adapters to pretrained CRISPRon-ABE. With the original parameters fixed, adapters were trained separately for ABE8e and D699 to predict overall editing efficiency and A-to-G outcome frequencies at protospacer positions 3–10 (Fig. 1A). Δdistance describes interstrand DNA distance changes relative to the same target with a 20-nt guide. AlphaFold 3 structures showed reduced mean distances at positions 3–10 for 16-nt guides and smaller changes for 18-nt guides (Supplementary Fig. 1A).
Across guide lengths, the combined model performed best on all four D699 metrics, with \(R_2\), \(\rho_2\), outcome-frequency MSE and adenine-position MSE of 0.668, 0.682, 42.08 pp² and 617.67 pp², respectively. For ABE8e, it achieved the lowest outcome-frequency MSE of 58.66 pp². Length only achieved the highest \(R_2\) and \(\rho_2\), whereas Δdistance only achieved the lowest adenine-position MSE of 694.59 pp² (Fig. 1B). Improvement over CRISPRon-ABE in adenine-position prediction was greatest with 16-nt guides (Fig. 1C). Outcome-frequency MSE decreased in 11 of 12 ABE8e targets and all 12 D699 targets (Fig. 1D). Adding Δdistance to length further reduced outcome-frequency MSE for both editors and adenine-position MSE for D699. A supervised regression model combining source-model activities and structural distance predicted TeABE editing at positions 1–20. Its mean editing peak occurred at position 11, compared with observed peaks at positions 12 or 13 (Supplementary Fig. 1B–D).
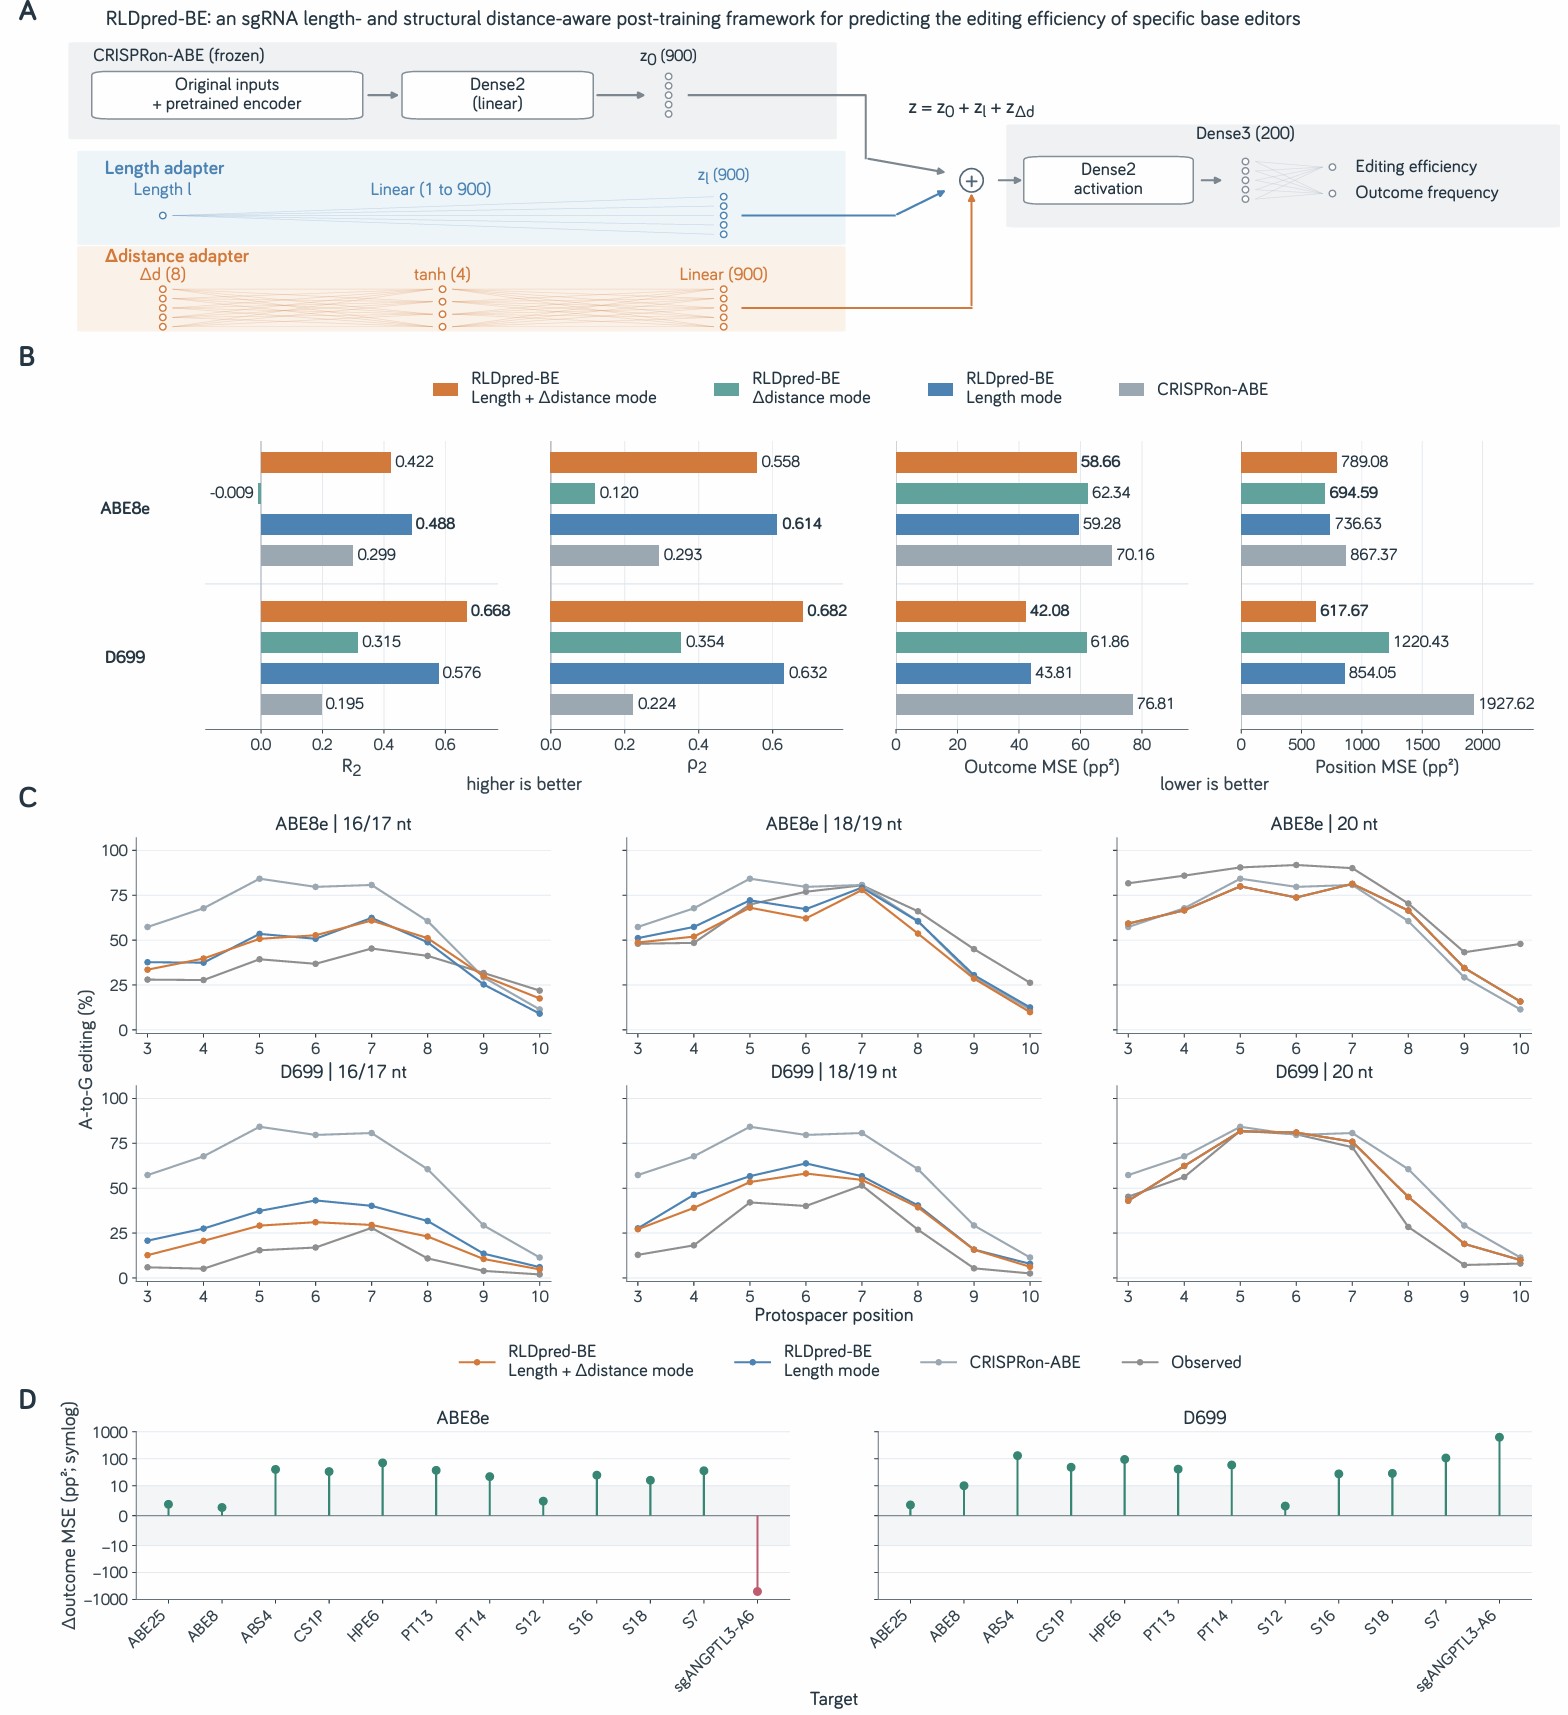
Figure 1 | RLDpred-BE prediction of adenine base-editing outcomes across guide lengths.
A, RLDpred-BE architecture with length and Δdistance adapters. B, Performance of CRISPRon-ABE and the length-only, Δdistance-only and combined models. \(R_2\) and \(\rho_2\) jointly assess efficiency and outcome frequency. MSE assesses outcome frequencies and adenine-position efficiencies. Bold values indicate the best result per editor and metric. C, Mean observed and predicted editing at positions 3–10 by guide length, including targets carrying adenine at each position. The number of contributing targets ranges from 3 to 11. D, Outcome MSE differences calculated as CRISPRon-ABE minus combined RLDpred-BE. Positive values indicate reduced error. The symmetric logarithmic axis is linear between −10 and 10 pp². Predictions used 12-fold leave-one-target-out evaluation. pp², percentage points squared.
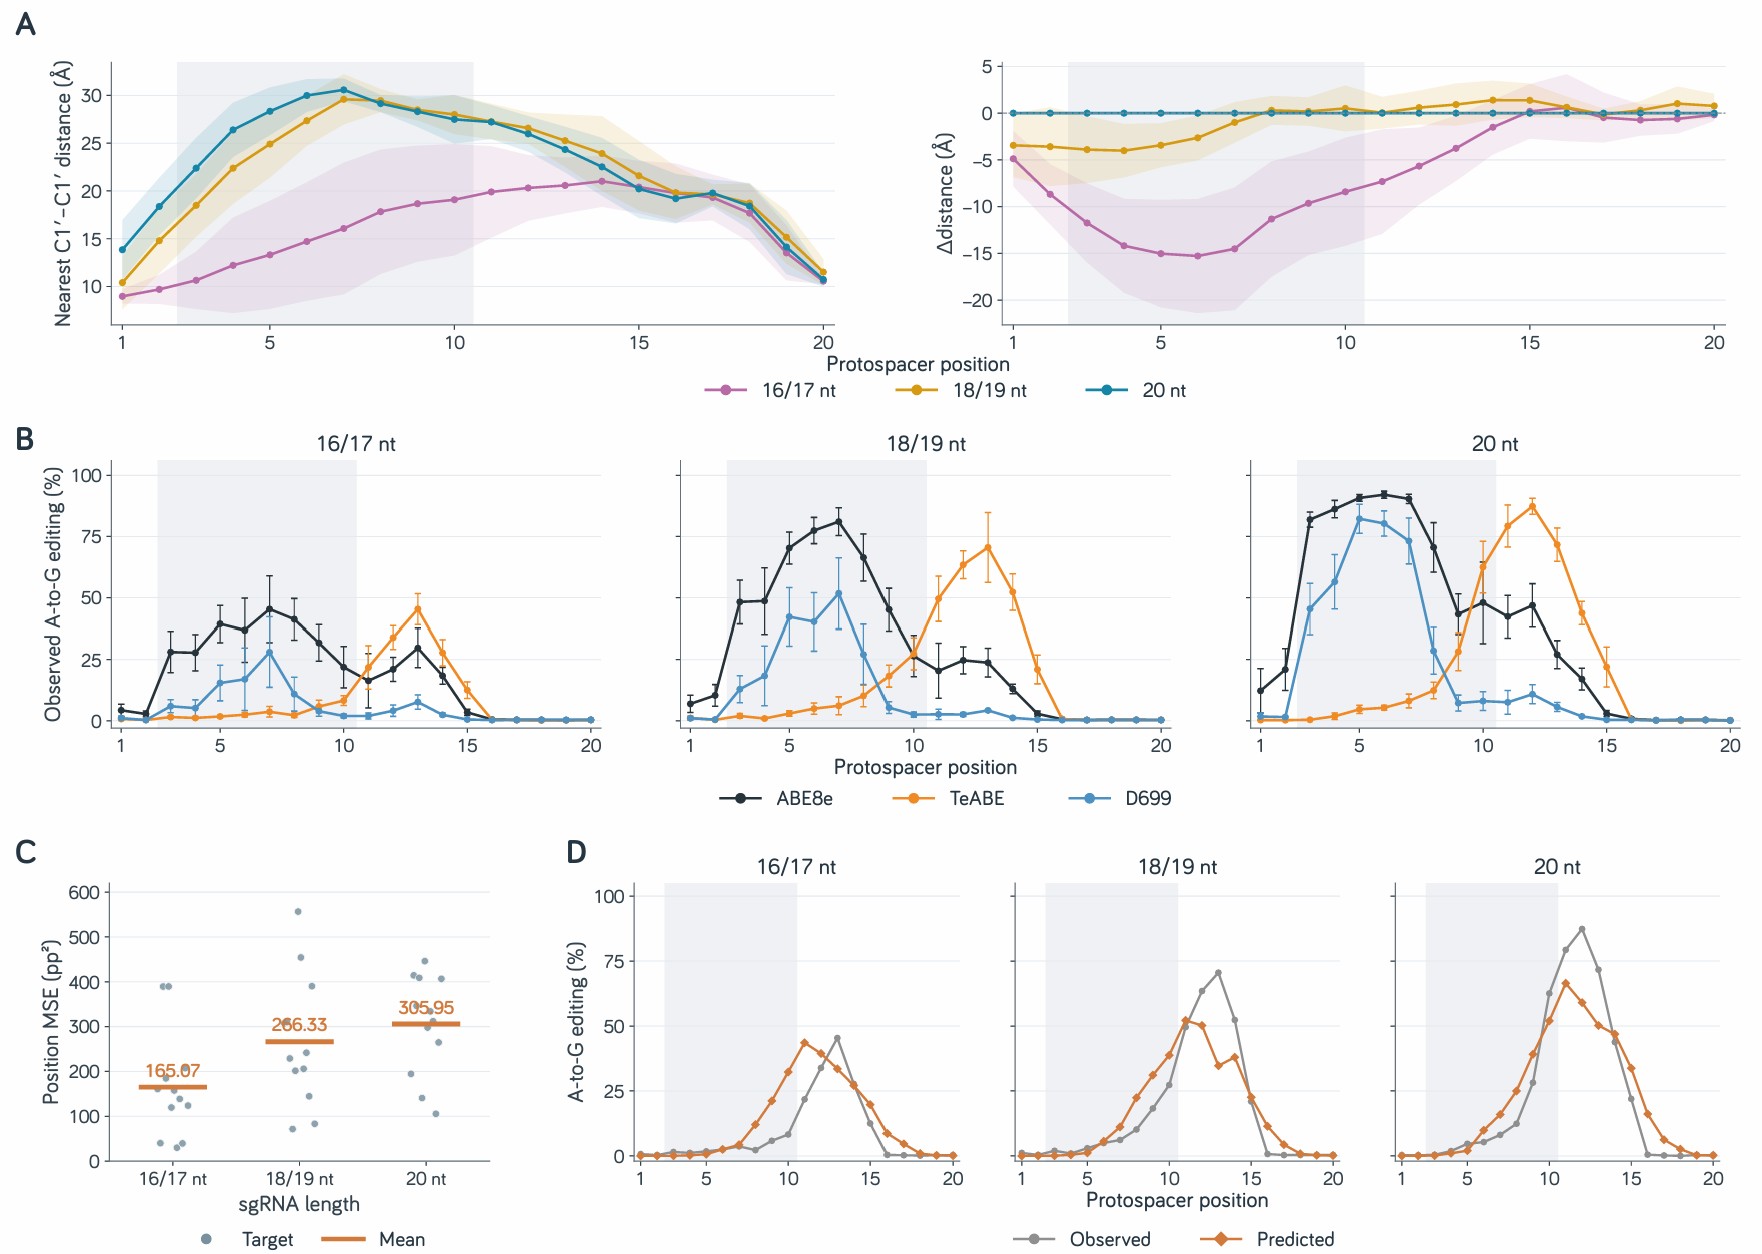
Supplementary Figure 1 | Structural distances, observed editing profiles and TeABE position regression.
A, Nearest interstrand C1′–C1′ distances at positions 1–20 and changes relative to the target-matched 20-nt guide. Lines and shading indicate mean and standard deviation across 12 targets. B, Observed A-to-G profiles for ABE8e, TeABE and D699. Means and standard errors include targets carrying adenine at each position. C, TeABE adenine-position MSE by guide length. Points represent 12 held-out targets and orange lines their mean. D, Mean observed and predicted TeABE profiles across adenine-containing targets. Observed percentages in B and D use reads covering the full 20-nt protospacer as denominator. C and D show regression with absolute structural distance. Grey backgrounds in A, B and D mark positions 3–10.
Methods
Development and evaluation of RLDpred-BE
We analyzed 12 targets in the 16/17-, 18/19- and 20-nt sgRNA groups. Length inputs were 16, 18 and 20 target-matching bases, respectively. Positions followed the full 20-nt protospacer. Sample-level allele-frequency tables provided overall editing efficiency as the percentage of reads with reported substitutions or indels. Eight binary values encoded A-to-G conversions at positions 3–10, with missing or uncovered positions assigned zero. All \(2^K - 1\) nonempty patterns were included for \(K\) adenines, including unobserved outcomes assigned zero frequency. Overall efficiency and outcome frequencies used each sample’s total reads as denominator and were averaged equally within each target–length condition.
AlphaFold Server using AlphaFold 3 [2] returned five Cas9–sgRNA–DNA structures per condition, shared across the three editors. At each protospacer position, distance was measured from its C1′ atom to the nearest C1′ atom on the opposing 60-nt DNA strand. Two structures were excluded because the minimum interstrand carbon–carbon distance was below 2 Å at any position from 1 to 20. Distances were averaged across the remaining four or five structures, and the target-matched 20-nt distance was subtracted:
\[d_{t,L,j} = \frac{1}{M_{t,L}}\sum_{m=1}^{M_{t,L}} \min_{k=1,\ldots,60} \left\lVert \mathbf{a}_{t,L,j}^{(m)}-\mathbf{b}_{t,L,k}^{(m)} \right\rVert_2,\] \[\Delta d_{t,L,j}=d_{t,L,j}-d_{t,20,j},\]Here, \(t\), \(L\) and \(m\) denote target, guide length and retained structure. Vectors \(\mathbf{a}\) and \(\mathbf{b}\) are C1′ coordinates, and \(M\) is the retained structure count. Distances are in ångströms. The eight Δdistance values at positions 3–10 formed the structural input.
RLDpred-BE retained CRISPRon-ABE’s inputs [1]: a 30-nt target DNA sequence, an eight-value editing pattern, CRISPRoff and CRISPRon scores, and a dataset indicator. The indicator selects one of the original training datasets. For both editors, [0, 0, 0, 0, 1] selected the ABE8e dataset of Kissling et al. Length and distance adjustments were added before activation of Dense2, the second fully connected layer with 900 units:
\[\mathbf{z} =\mathbf{z}_0+\mathbf{W}_{\ell}\tilde{\ell}+\mathbf{b}_{\ell} +\mathbf{W}_2\tanh\!\left(\mathbf{W}_1\widetilde{\Delta\mathbf{d}}\right).\]Here, \(\mathbf{z}_0\) denotes Dense2 features before activation, and tildes denote scaled inputs. The length adapter used a linear mapping with a bias from one input to 900 adjustments. The distance adapter used an 8→4→900 mapping with tanh activation and no biases. Training updated only adapter parameters. Original network weights remained fixed.
Adapters were fitted separately for each editor using 25 pretrained models. In the combined model, length was trained first and fixed during distance training. The length adapter and final distance mapping were zero-initialized, initially preserving the preceding model’s predictions. Comparisons included the original, length-only, Δdistance-only and combined models.
Twelve-fold leave-one-target-out cross-validation used ten targets for training, one for validation and one for testing per fold. Each target was tested once. All lengths and outcomes of a target remained together, with identical splits across models.
Scaling used distinct training target–length conditions. Length was scaled by subtracting its mean and dividing by its standard deviation. Δdistance was divided by its position-specific standard deviation without subtracting its mean, preserving the zero-valued 20-nt reference. Validation and test inputs used these training parameters.
Training used TensorFlow/Keras and Adam with learning rate \(10^{-4}\) and batch size 16. Each stage ran for at most 2000 epochs, stopping after 100 epochs without improvement in validation MSE and retaining the parameters with the lowest validation MSE. The base seed was 42. The loss equally weighted both percentage outputs and all outcome records:
\[\mathcal{L} =\frac{1}{2N}\sum_{i=1}^{N} \left[\left(\widehat{E}_i-E_i\right)^2 +\left(\widehat{F}_i-F_i\right)^2\right],\]Here, \(E\) and \(F\) denote measured overall efficiency and outcome frequency, hats denote predictions, and \(N\) is the number of training outcome records.
Corresponding predictions were averaged across 25 models before frequency processing. Overall metrics pooled predictions for all 12 test targets.
\(R_2\) and \(\rho_2\) jointly evaluated efficiency and outcome frequency following CRISPRon-ABE [1]. Negative predicted frequencies were set to zero. Within each condition, frequencies were rescaled to sum to the mean efficiency prediction across its outcomes. Matrices \(Y\) and \(P\) contained outcomes as rows and efficiency and frequency as columns, repeating condition-level efficiency for each outcome:
\[R_2= \frac{ \displaystyle\sum_{i=1}^{N}\sum_{k=1}^{2} \left(Y_{ik}-\overline{Y}_k\right) \left(P_{ik}-\overline{P}_k\right) }{ \displaystyle \sqrt{\sum_{i,k}\left(Y_{ik}-\overline{Y}_k\right)^2} \sqrt{\sum_{i,k}\left(P_{ik}-\overline{P}_k\right)^2} }.\]Bars denote column means. \(N\) is the outcome count and \(k\) indexes the two outputs. For \(\rho_2\), each column was converted to average ranks before applying the same formula.
For MSE and predicted profiles, frequencies were clipped to 0–100%. Totals exceeding 100% were proportionally reduced to 100%. Adenine-position efficiency summed frequencies of outcomes containing that conversion. MSE was calculated as:
\[\mathrm{MSE}_{\mathrm{out}} =\frac{1}{N_{\mathrm{out}}}\sum_{i=1}^{N_{\mathrm{out}}} \left(\widehat{F}_i-F_i\right)^2, \qquad \mathrm{MSE}_{\mathrm{pos}} =\frac{1}{N_{\mathrm{pos}}}\sum_{c,j} \left(\widehat{A}_{c,j}-A_{c,j}\right)^2.\]Here, \(c\) denotes a target–length condition and \(j\) an adenine at positions 3–10. Each editor contributed 36 conditions, 984 outcomes and 159 condition–adenine records. Zero-frequency outcomes were included. Both MSEs are in percentage points squared, pp². Figure 1D subtracts combined-model MSE from CRISPRon-ABE MSE for each target across all three lengths.
Observed profiles for all three editors used reads covering the full 20-nt protospacer as denominator. Percentages were averaged equally across samples within conditions, then across targets carrying adenine at each position. TeABE regression used these condition-level proportions at positions 1–20, comprising 312 adenine records.
Continuous TeABE editing proportions from 0 to 1 were fitted by L2-penalized logistic regression using the same target splits. Fold-matched combined ABE8e and D699 models supplied source activities, each averaging predicted adenine editing at positions 3–10 after 25-model averaging and MSE frequency processing.
Five predictors comprised the two source activities, absolute C1′–C1′ distance, normalized position \(x = (j - 10.5)/9.5\) and \(x^2\). Source activities were converted to proportions \(p\), clipped to \([10^{-4}, 1 - 10^{-4}]\) and logit-transformed as \(\log[p/(1 - p)]\). Weighted training means and standard deviations scaled all predictors:
\[\widehat{A}_{t,L,j} =100\,\sigma\!\left( \beta_0+\boldsymbol{\beta}^{\mathsf{T}}\widetilde{\mathbf{v}}_{t,L,j} \right).\]Here, \(\sigma\) is the logistic function that constrains proportions to 0–1, \(\beta_0\) the intercept and the tilded vector the scaled predictors. The weighted logistic loss used measured proportions \(y\) and predicted proportions \(p\):
\[\mathcal{L}_{\mathrm{frac}} =-\sum_i w_i\left[ y_i\log p_i+(1-y_i)\log(1-p_i) \right] +\frac{\lambda}{2}\sum_{k=1}^{5}\beta_k^2.\]Record weights \(w_i = 1/(T C_t K_{t,L})\) gave equal weight to targets and lengths within targets. \(T\), \(C_t\) and \(K_{t,L}\) denote training targets, lengths per target and adenines per condition. The intercept was unpenalized. SciPy L-BFGS-B fitted coefficients, with \(\lambda\) selected from 0.001, 0.01, 0.1 and 1 by validation MSE averaged across lengths. Evaluation averaged squared errors across adenines within conditions, lengths within targets and finally test targets.
References
-
Sun, Y. et al. Deep learning models simultaneously trained on multiple datasets improve base-editing activity prediction. Nature Communications 16, 9821 (2025). https://doi.org/10.1038/s41467-025-65200-5
-
Abramson, J. et al. Accurate structure prediction of biomolecular interactions with AlphaFold 3. Nature 630, 493–500 (2024). https://doi.org/10.1038/s41586-024-07487-w